机器人
带「机器人」标签的文章共 22 篇。标签跨越分类,所以统计、客服和产品类文章可能并排出现。
标签:机器人
22 篇文章
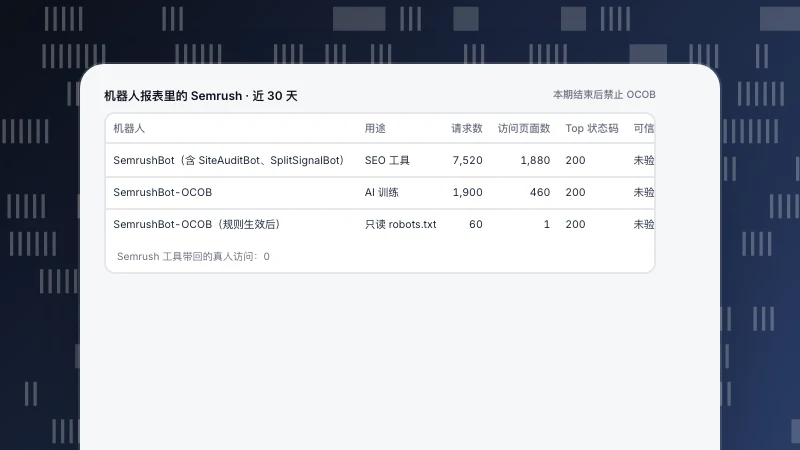
SemrushBot:一组十个爬虫,怎么分开决定
SemrushBot 是 Semrush 的爬虫家族,十个 robots.txt token 各自独立。各做什么、怎么保住 SEO 数据又单独退出 SemrushBot-OCOB、怎么核实请求、按目的怎么决定。
阅读全文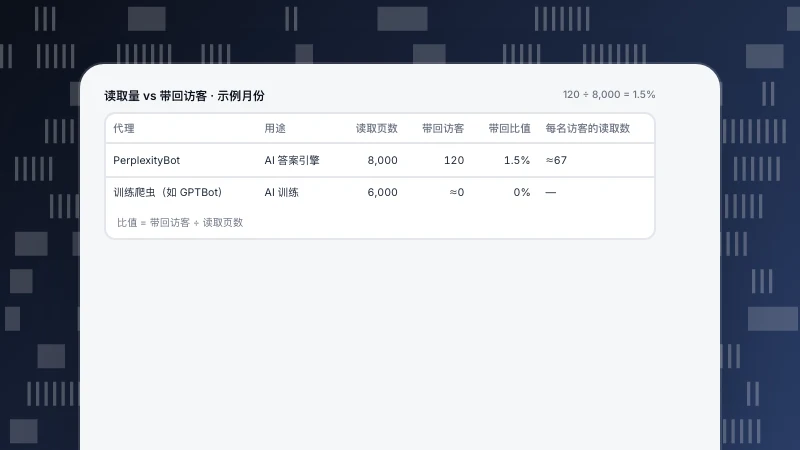
PerplexityBot:它读什么、带回什么,以及要不要放行
PerplexityBot 读取网页,让 Perplexity 答案能引用你的网站;Perplexity-User 按用户请求抓页。两个代理各做什么、robots.txt 怎么写、怎么按 IP 核实,以及用读取量与带回访客的比值决定放不放行。
阅读全文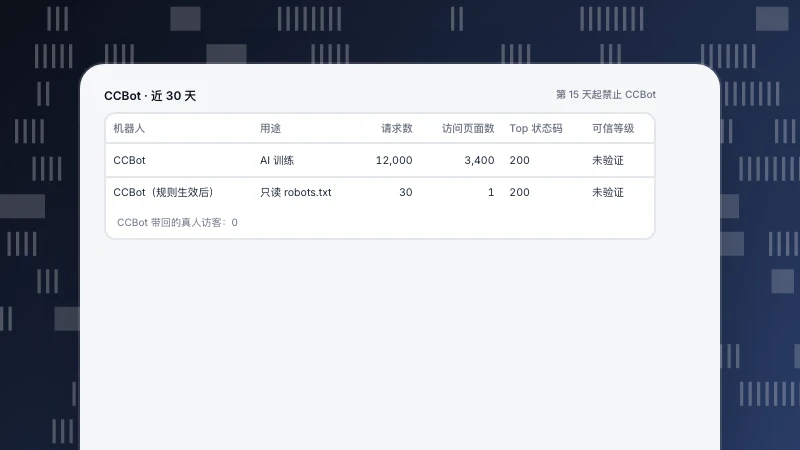
CCBot:Common Crawl 的数据集爬虫,屏蔽它到底改变什么
CCBot 建起 Common Crawl 的免费公开数据集,GPT-3、LLaMA、BLOOM 的训练语料都有论文出处。它抓什么、怎么核实、robots.txt 怎么写,以及为什么屏蔽只影响以后的快照。
阅读全文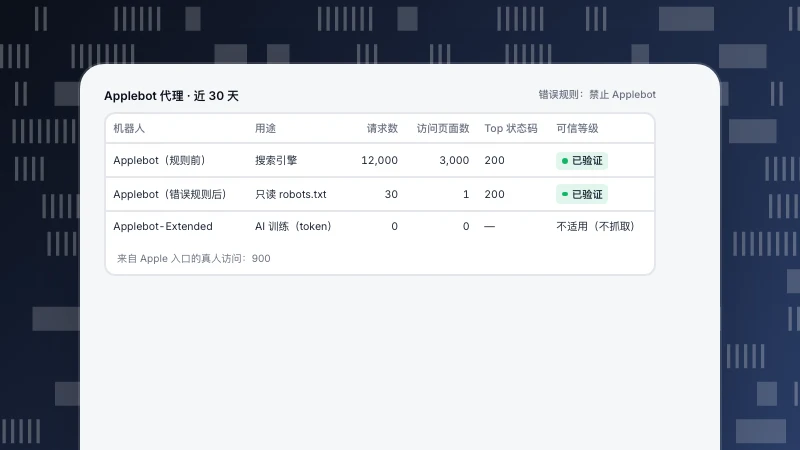
Applebot 和 Applebot-Extended:两个身份,分别控制
Applebot 给 Spotlight、Siri 和 Safari 搜索抓内容;Applebot-Extended 只是 robots.txt 里的 AI 训练开关。两个代理各做什么、三种规则写法、DNS 与 IP 核实,以及屏蔽错了会损失多少的算例。
阅读全文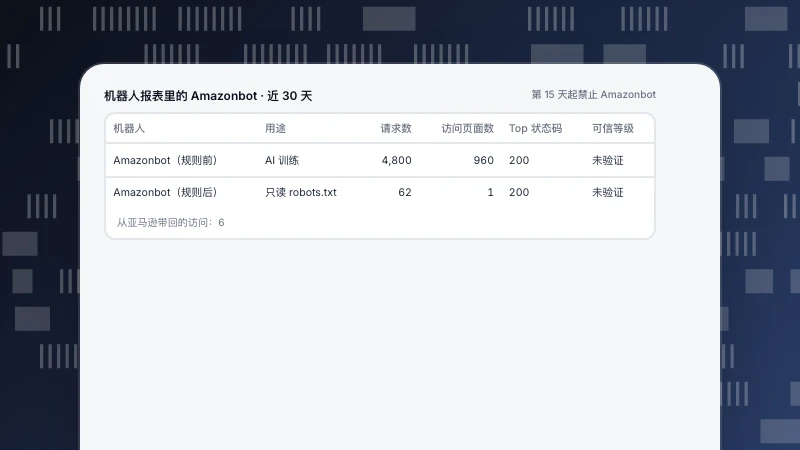
Amazonbot:亚马逊的三个爬虫,以及怎么分别控制
Amazonbot 是亚马逊的爬虫,它读取的内容可能用于训练 Amazon AI 模型,是三个 robots.txt 设置互相独立的亚马逊代理之一。各自做什么、按目标怎么写规则、怎么按 IP 核实,以及一个读取量对比回流量的算例。
阅读全文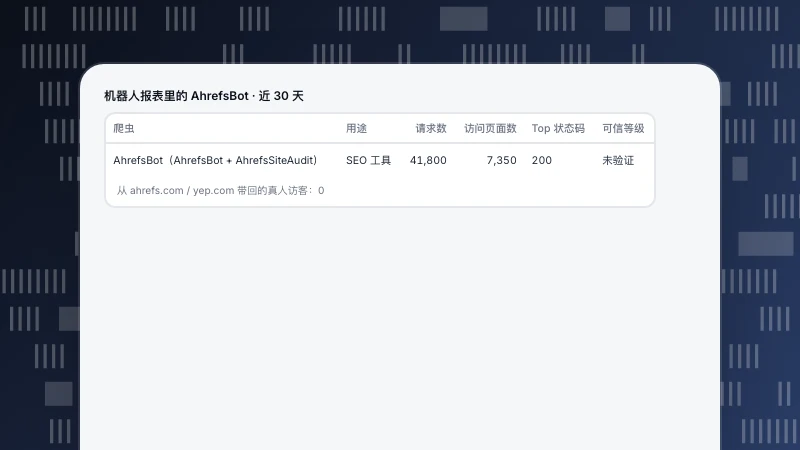
AhrefsBot:Ahrefs 的两个爬虫,放行还是屏蔽
AhrefsBot 替 Ahrefs 用户(包括竞争对手)读你的网站,不带回访客。两个爬虫各做什么、robots.txt 怎么允许/屏蔽/限速、怎么验真、按什么决定放行。
阅读全文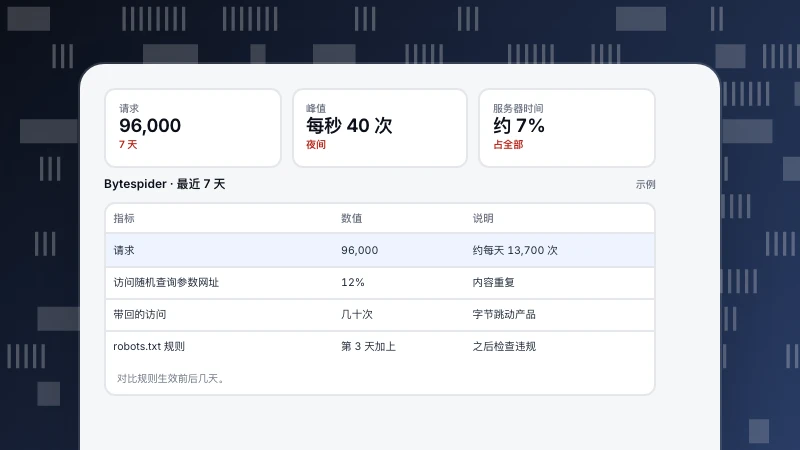
Bytespider:是什么、怎么控制
Bytespider 是字节跳动(TikTok 背后的公司)运营的网络爬虫。很多站长因为它的请求量而注意到它。讲清它的用户代理、一个衡量负载和 robots.txt 遵守情况的完整一周例子,以及从 robots.txt 到防火墙屏蔽的各种做法。
阅读全文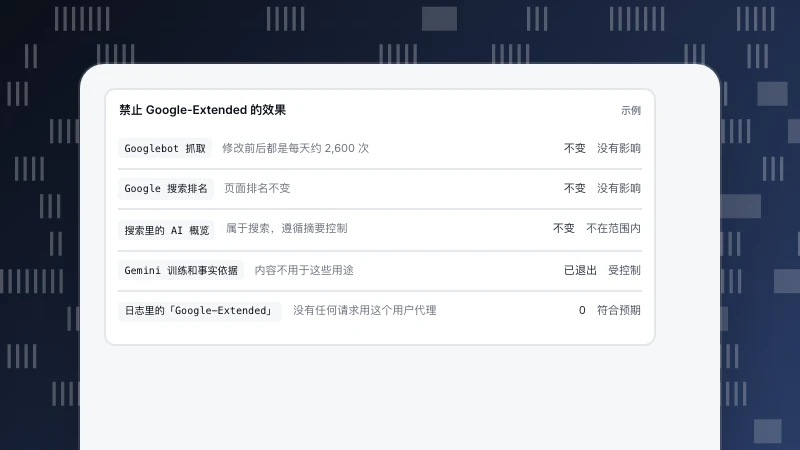
Google-Extended:它控制什么、怎么写进 robots.txt
Google-Extended 是 robots.txt 里的一个标记,不是单独的爬虫。它让你选择 Google 抓取的内容能不能用于 Gemini 模型和其他一些 AI 产品,而不影响 Google 搜索。讲清它控制什么、不控制什么,以及怎么设置。
阅读全文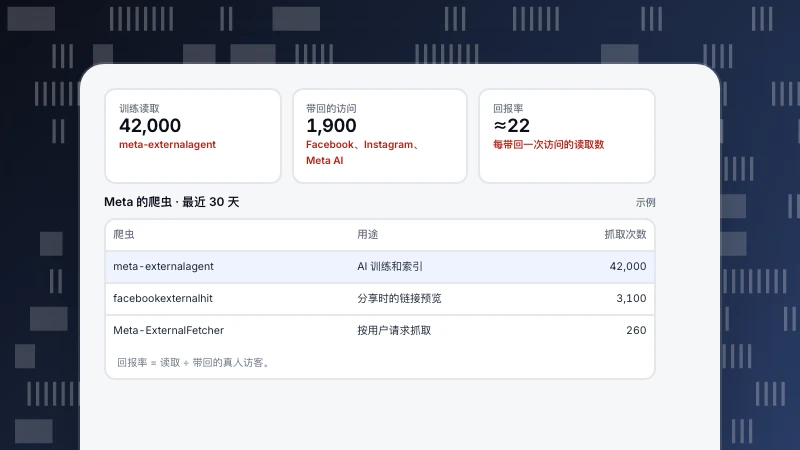
Meta-ExternalAgent:Meta 的 AI 爬虫做什么、怎么控制
Meta-ExternalAgent 是 Meta 用来为 AI 训练和索引收集网页内容的爬虫。讲清它和 Meta 链接预览爬虫的区别、怎么验证、一个对比它读了多少和 Meta 带回多少访客的完整月度例子,以及 robots.txt 规则。
阅读全文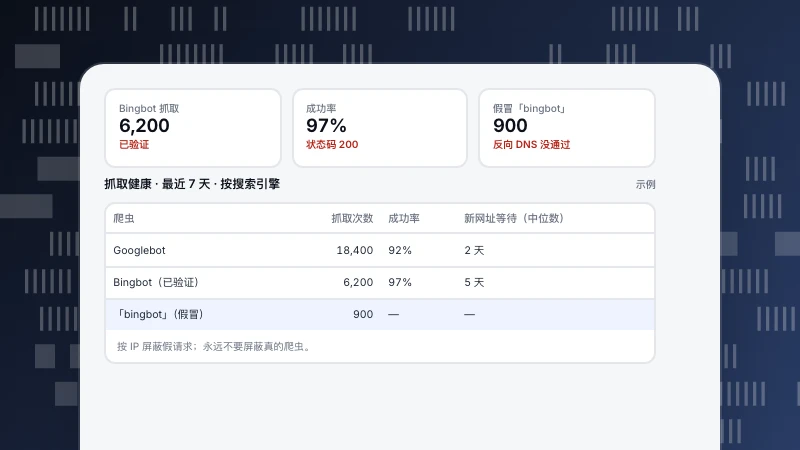
Bingbot:是什么、怎么验证、怎么控制抓取
Bingbot 是微软为 Bing 搜索抓取网页的爬虫。讲清它的用户代理、怎么用反向 DNS 验证真假、一周内和 Googlebot 对比的完整例子(含假冒的 Bingbot)、怎么控制抓取频率,以及 IndexNow 怎么加快收录。
阅读全文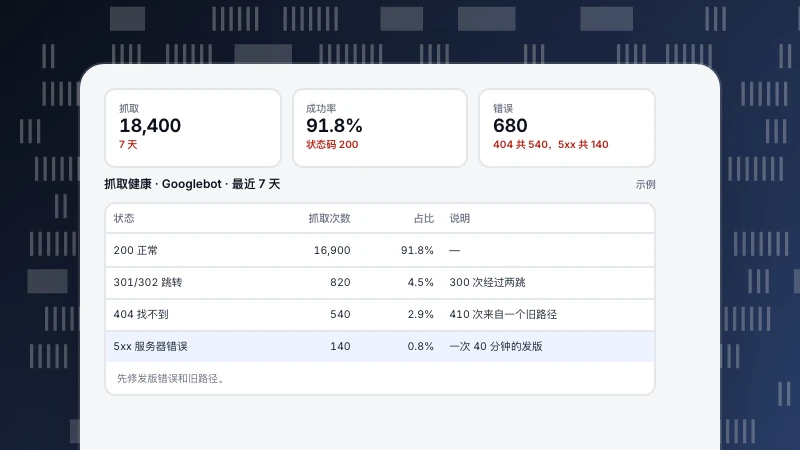
抓取错误:类型、原因和修复方法
抓取错误是搜索引擎爬虫的失败请求:DNS 和服务器错误、超时、404、跳转问题。讲清主要类型、各自原因、一周 Googlebot 数据的完整例子,以及修复的先后顺序。
阅读全文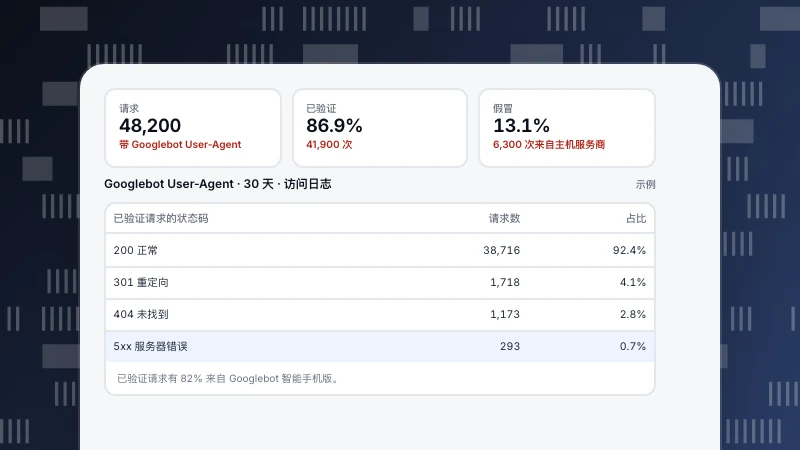
Googlebot:是什么、怎么抓取、怎么验证真假
Googlebot 是 Google 为搜索抓取网页用的爬虫。它怎么抓取和渲染、日志里还会看到哪些 Google 爬虫、怎么分辨真假 Googlebot,以及一个月的日志示例。
阅读全文
什么是数据质量?六个维度,用在分析数据上
数据质量是数据在多大程度上能支撑你要做的决定。六个维度(准确性、完整性、一致性、及时性、有效性、唯一性)各自能查出哪种分析数据问题,附一份每周检查清单。
阅读全文
SEO 日志分析:不依赖工具的方法,六个问题
服务器日志记录的是搜索引擎爬虫实际请求了什么,而不是抓取工具的推测。怎么拿到日志、验证 Googlebot 是真的,以及用六个问题把原始日志变成 SEO 修复项。
阅读全文
robots.txt 禁止所有爬虫:能挡什么、挡不了什么,以及更稳妥的写法
robots.txt 里的两行就能要求所有爬虫别碰整个网站。它实际做了什么、没做什么(不会隐藏网址,也保护不了任何东西),常见变体和 Google 怎么处理冲突规则,以及怎么检查哪些爬虫真的遵守。
阅读全文
Google 多久抓取一次网站?先量出来,再让它更快
Google 没有固定的抓取周期:首页可能一天被抓很多次,深层商品页可能一个月才一次。怎么在自己的网站上按页面类型量出抓取频率,以及什么做法真能让新页面更快被抓取。
阅读全文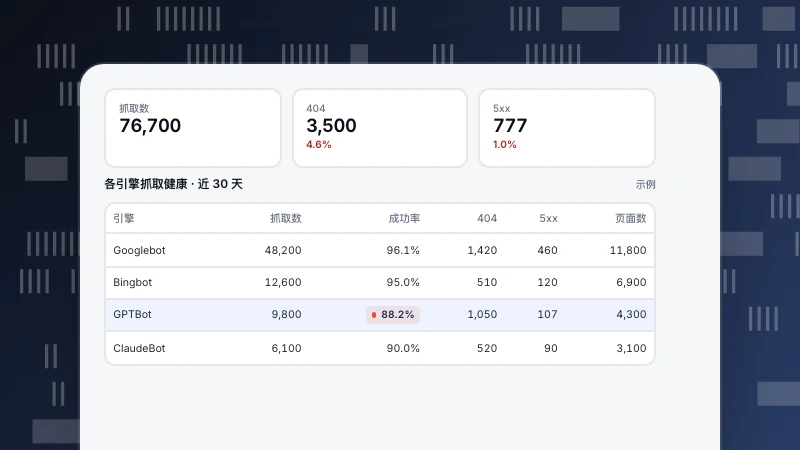
抓取预算:对你的网站重要吗,又花在了哪里?
抓取预算是搜索引擎愿意并且能够在你的网站上抓取多少。什么时候需要关心、什么在浪费它,以及怎么读服务器日志,看搜索引擎和 AI 爬虫的请求到底花在了哪里。
阅读全文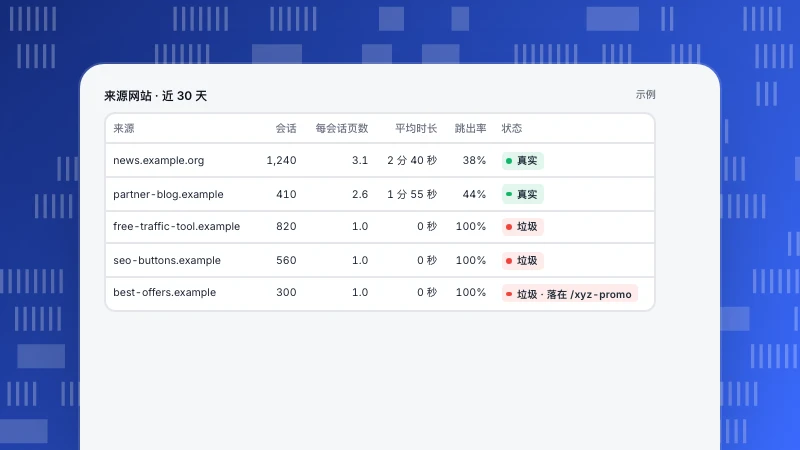
引荐垃圾流量:三种类型、怎么识别、在哪一层拦
引荐垃圾流量分三种:从不访问你网站的幽灵请求、爬虫访问和脚本化的浏览器访问。每种在报表里的迹象,以及该在哪一层处理,从采集白名单到报表筛选。
阅读全文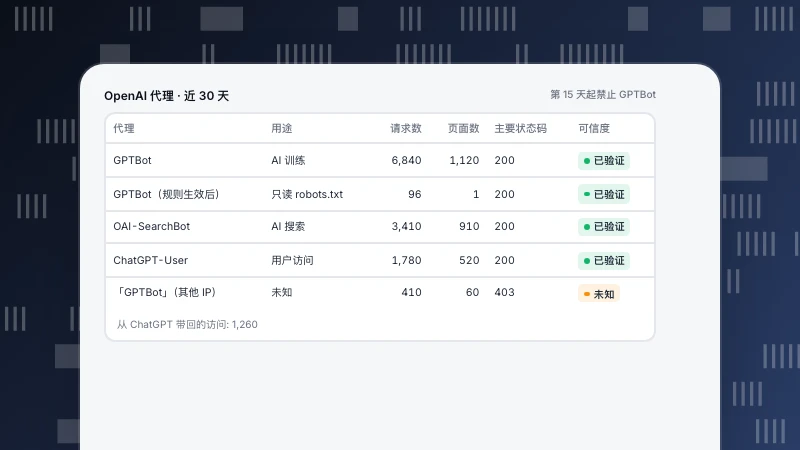
GPTBot:OpenAI 的四个爬虫,以及怎么分别控制
GPTBot 是 OpenAI 的训练爬虫,是四个 robots.txt 设置互相独立的 OpenAI 代理之一。各自做什么、退出后会怎样、常见目标下的规则,以及怎么核实、怎么在自己的数据里检查。
阅读全文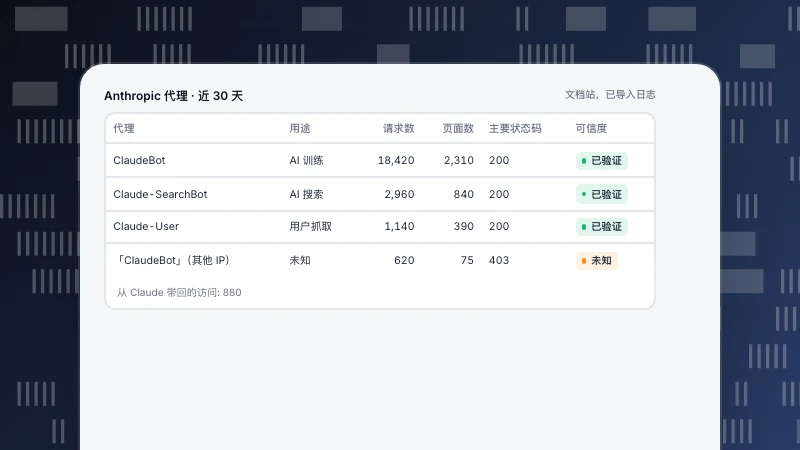
ClaudeBot:抓什么、怎么屏蔽、怎么核实
ClaudeBot 是 Anthropic 的三个网络代理之一。每个代理做什么、屏蔽后会怎样、常见目标下 robots.txt 怎么写、怎么用 Anthropic 公布的 IP 列表核实请求,以及怎么在自己的数据里看到 ClaudeBot。
阅读全文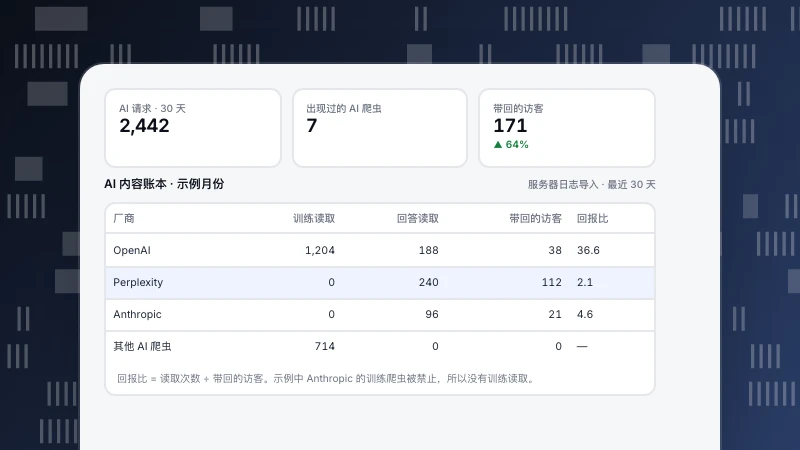
怎么屏蔽 AI 爬虫:User-Agent 清单、robots.txt 写法和核实方法
GPTBot、ClaudeBot、Google-Extended 各干各的活。该挡哪些 AI 爬虫、robots.txt 怎么写、哪些要在服务器上拦,以及怎么确认规则生效。
阅读全文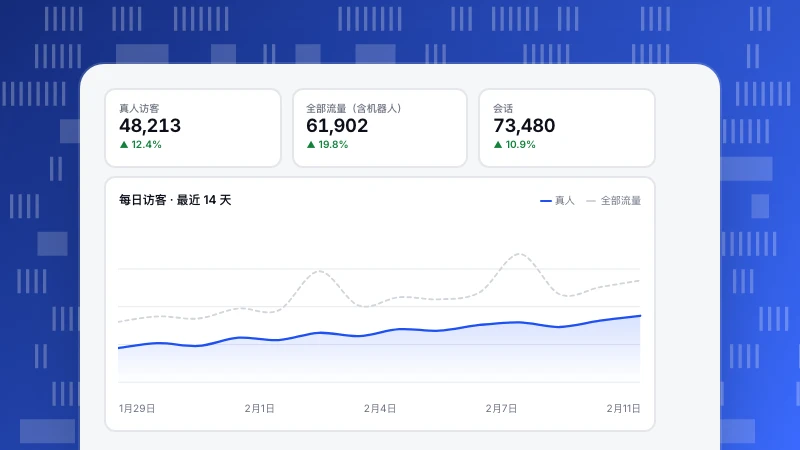
为什么不同统计工具的数据对不上?8 个原因和一份核对清单
同一个网站装两个统计工具,访客数永远对不上。本文讲清 8 个原因,用一个例子拆开差距去了哪里,再给一份核对清单。
阅读全文