在 Google 上有排名的每个页面,都先被 Googlebot 抓过;而你日志里自称 Googlebot 的请求,有相当一部分根本不是 Google。本文讲 Googlebot 怎么抓取和渲染、还会看到哪些 Google 爬虫、怎么验证真假,以及一个月的日志是什么样。
读完你会知道
- 大部分抓取来自 Googlebot 智能手机版;只看 User-Agent 证明不了什么
- 用反向 DNS(googlebot.com 或 google.com)加正向查询验证,或对照 Google 公布的 IP 段
- 响应快而稳定,抓取才健康;5xx 错误会让 Googlebot 放慢
什么是 Googlebot
Googlebot 是 Google 用来发现和抓取网页、供 Google 搜索使用的爬虫。它顺着链接和站点地图找到页面,下载、渲染,再交给 Google 的索引系统。Googlebot 抓不到的页面,就不可能有排名。
主要有两个版本:
- Googlebot 智能手机版抓取大多数网站,因为 Google 优先索引页面的移动版本。
- Googlebot 桌面版仍然会抓,但在大多数网站上频率低得多。
两者的 User-Agent 里都带有「Googlebot」,但光看 User-Agent 什么也证明不了:谁都能照抄。
Googlebot 怎么抓取和渲染
- 发现:已知页面上的链接、站点地图、在 Search Console 提交的网址。
- 规则:抓取前先看 robots.txt,跳过不允许的路径。它不理会 crawl-delay 指令。
- 抓取:下载 HTML(Google 文档写明每个文件只处理前 15 MB)以及渲染所需的资源。
- 渲染:用较新版本的 Chromium 运行 JavaScript,所以脚本加载的内容也能被索引,只是有时会晚一些。
- 抓取速度:Google 根据服务器响应快慢和它对内容的需求来调整抓取速度。响应慢、出现 5xx 错误,它就会放慢。见 Google 多久抓取一次。
其他 Google 爬虫
日志里的 Google 爬虫不只有 Googlebot。下表列出最常遇到的几个,以及在 robots.txt 里怎么写。
| 爬虫 | 抓什么 | robots.txt 标识 |
|---|---|---|
| Googlebot 智能手机版 / 桌面版 | Google 搜索用的页面 | Googlebot |
| Googlebot Image | 搜索和图片搜索用的图片 | Googlebot-Image |
| Googlebot Video | 视频文件和视频页面 | Googlebot-Video |
| Google-InspectionTool | Search Console 里的实时测试 | 沿用 Googlebot 的规则 |
| GoogleOther | 内部研究和一次性抓取 | GoogleOther |
| AdsBot-Google | 广告落地页质量检查 | AdsBot-Google(不受 * 规则约束) |
| Google-Extended | 不是单独的爬虫,而是控制内容能否用于 Gemini 模型的标识 | Google-Extended |
以 Google 爬虫总览页的最新列表为准;名称和标识会变。
怎么验证真的 Googlebot
假 Googlebot 很常见:采集程序和漏洞扫描器会照抄 User-Agent,以免被拦。验证一个 IP 的步骤:
- 反向 DNS:查这个 IP 的主机名(比如
host 66.249.66.1)。真的 Googlebot 会解析到以 googlebot.com 或 google.com 结尾的名字。 - 正向 DNS:再查这个主机名,确认返回的是同一个 IP。
- 或者对照 Google 公布的 IP 段,Google 以 JSON 文件的形式提供各类爬虫的 IP 段。
既不要只按 User-Agent 拦截,也不要只凭它就信任。
一个月的日志示例
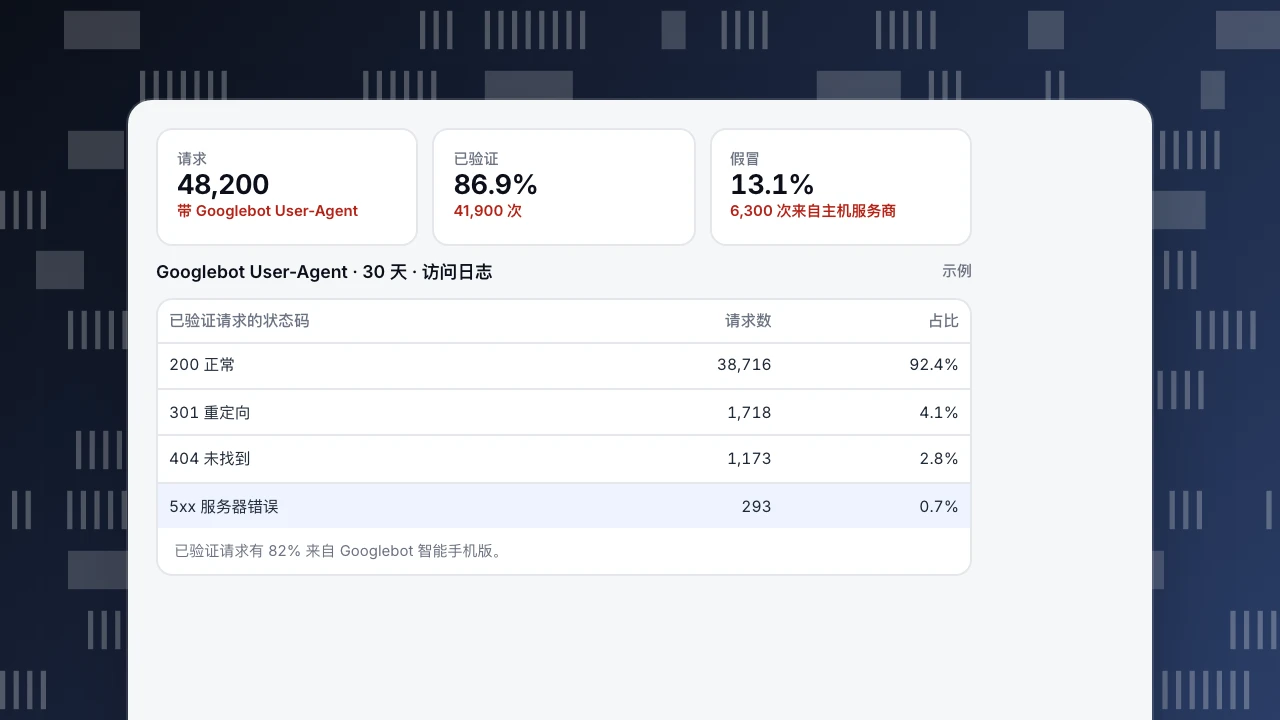
一个内容网站导入了 30 天的访问日志(示例数字):
- 48,200 次请求带着 Googlebot 的 User-Agent。
- 其中 41,900 次(86.9%)验证为 Google;6,300 次(13.1%)来自主机服务商,是假的。假请求大多冲着登录页和旧插件路径去。
- 验证过的请求里,92.4% 返回 200,4.1% 是 301 重定向,2.8% 是 404,0.7% 是 5xx 错误。
- 验证过的请求有 82% 来自 Googlebot 智能手机版。
要做的事:在防火墙按 IP 拦掉假请求,修掉重定向链,查一下那些 404 是从哪里链过来的。0.7% 的 5xx 值得重视,反复出现的服务器错误会让抓取变慢。
请求
48,200
带 Googlebot User-Agent
已验证
86.9%
41,900 次
假冒
13.1%
6,300 次来自主机服务商
Googlebot User-Agent · 30 天 · 访问日志
示例| 已验证请求的状态码 | 请求数 | 占比 |
|---|---|---|
| 200 正常 | 38,716 | 92.4% |
| 301 重定向 | 1,718 | 4.1% |
| 404 未找到 | 1,173 | 2.8% |
| 5xx 服务器错误 | 293 | 0.7% |
已验证请求有 82% 来自 Googlebot 智能手机版。
怎么控制 Googlebot
- robots.txt 控制的是抓取,不是索引。被禁止抓取的网址,如果有别的页面链接它,仍可能出现在搜索结果里。见 robots.txt 禁止全部抓取。
- noindex(meta 标签或 X-Robots-Tag 响应头)让页面不进索引;前提是 Googlebot 能抓到这个页面,才能看到这条指令。
- 抓取速度:不能直接设置。响应快而稳定,Google 就会多抓;临时返回 503 或 429 能让它暂时放慢。
- 抓取预算主要对大网站有影响,见抓取预算。
在 TapCub 里看 Googlebot
- 网站统计 › 机器人 的「All bots」页签列出每个爬虫的运营商、用途、请求数、访问页面数、最常见状态码、最后发现时间和可信等级(已验证、疑似、未验证)。默认情况下,识别出的机器人不计入人类访客数据。
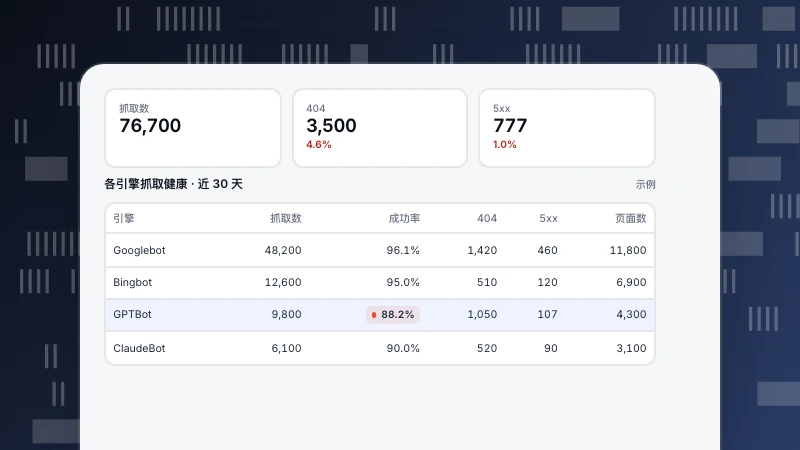
- 监测 › 抓取健康 按搜索引擎显示抓取次数、成功率、独立页面、404 和 5xx;设置了站点地图后,还能看到新页面等了多久才被首次抓取。在通知里打开「抓取异常」,某个引擎 24 小时抓取量低于 7 天日均的 30% 时会提醒你。
- Googlebot 很少执行你的统计脚本,所以状态码和完整的抓取次数需要服务端事件或日志导入。见 SEO 日志分析。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。