robots.txt 里的两行就能要求所有爬虫别碰你的网站。本文讲清它实际做了什么、没做什么,常见变体,Google 怎么处理冲突规则,以及怎么检查哪些爬虫真的遵守。
读完你会知道
- Disallow: / 停止的是抓取,不是收录;网址仍可能出现
- Disallow: 后面留空等于允许全部,注意斜杠
- 具名的组会替换 * 组,而不是叠加
就这两行
要让所有爬虫都别抓整个网站,在主机根目录的 /robots.txt 里写两行就够了:User-agent: * 和 Disallow: /。下面的示例还演示了怎么给某一个爬虫放行。
* 组适用于所有没有专属组的爬虫,Disallow: / 覆盖所有路径。规则按主机和协议生效:www.example.com 和 shop.example.com 各自需要一份文件。格式标准见 RFC 9309。
一个字符就能把意思完全反过来:Disallow: 后面什么都不写,意思是允许全部。注意检查那个斜杠。
# 禁止所有爬虫抓取整个网站
User-agent: *
Disallow: /

# ……Googlebot 除外,它只遵循自己的那一组
User-agent: Googlebot
Allow: /
它做不到的事
- 不会把页面从搜索结果里移除。 Google 说,被 robots.txt 屏蔽的网址如果有其他页面链接,仍可能出现在结果里,只是没有描述。要让页面不出现,用
noindex(并允许抓取,才能看到这个标记)或密码保护(见 robots.txt 简介)。 - 不保护任何东西。 这个文件是公开的,只是礼貌地请求。无视它的爬虫和普通人仍然能打开每个页面。
- 不会立即生效。 Google 一般会把 robots.txt 缓存最长 24 小时。
- 管不到别的主机。 每个子域名读自己的文件。
几种变体
表里列出人们说「禁止所有」时通常想要的几种写法,以及要注意的地方。只屏蔽 AI 爬虫,需要为每个代理名各写一组,而每家厂商都有好几个用途不同的代理;当前的名称见 GPTBot 和 ClaudeBot。
| 目标 | 规则 | 注意 |
|---|---|---|
| 屏蔽全部 | User-agent: * · Disallow: / | 网址仍可能不带描述地出现 |
| 允许全部 | User-agent: * · Disallow:(留空) | 少一个斜杠,意思就反了 |
| 只放行一个爬虫 | * 组 Disallow: / · 具名组 Allow: / | 具名爬虫会忽略 * 组 |
| 屏蔽一个目录 | Disallow: /private/ | 不是访问控制;文件是公开的 |
| 只屏蔽 AI 爬虫 | 每个代理一组,写 Disallow: / | 厂商有多个代理,以官方文档为准 |
| 测试站 | Disallow: / 加密码 | 不要把这份文件带到正式站 |
优先级以 Google robots.txt 规范为准。
Google 怎么处理冲突的规则
Google 的 robots.txt 规范定了三条值得记住的规则:
- 每个爬虫只认一组。 爬虫只遵循用户代理匹配得更具体的那一组,其余忽略。
Googlebot组对 Googlebot 来说是替换*组,而不是叠加。 - 路径长的规则优先。 同一组里,匹配路径更长的规则生效,所以对
/blog/post来说,Allow: /blog压过Disallow: /。 - 打平时按允许处理。 两条规则同样具体时,Google 采用限制更少的那条。
文件本身的状态码也有影响。返回 4xx(429 除外)时按没有 robots.txt 处理,所有内容都可能被抓。返回 5xx 时,Google 在头 12 小时停止抓取整个网站,之后最长 30 天沿用上一份能读到的版本。
测试站事故
Disallow: / 常见的伤害方式,是测试站的文件被带到了正式站。接下来的几天到几周,页面不再被刷新,排名随之下滑。防范办法:
- 测试站用密码保护,不要只靠 robots.txt。
- 在构建时按环境生成 robots.txt,不要复制。
- 加一道发布检查:如果正式站 robots.txt 的
User-agent: *下有Disallow: /,就让发布失败。 - 搜索引擎抓取量突然下降时提醒。
检查谁真的遵守
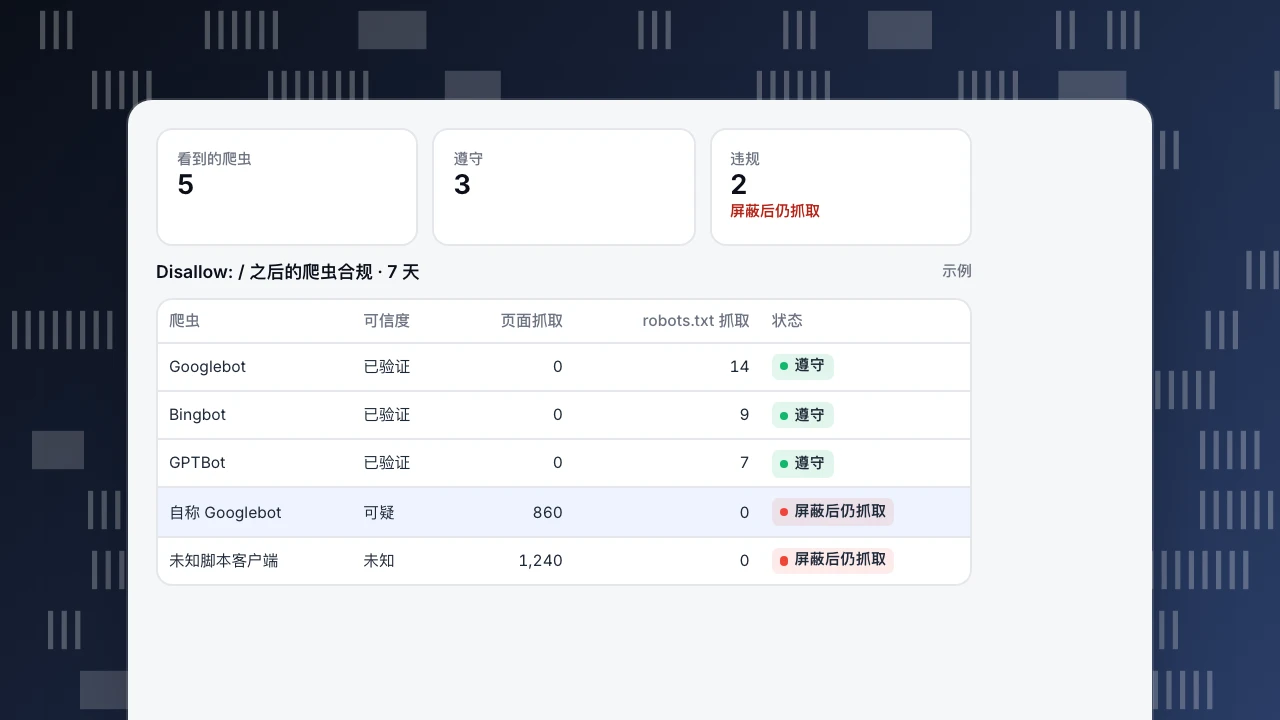
robots.txt 只是请求。把它和爬虫的实际抓取对比:全站屏蔽后,守规矩的爬虫应该只请求 /robots.txt。其他还在抓页面的,要么无视规则,要么是冒充别的爬虫。示例里三个经过验证的爬虫都遵守了,有两个客户端没有,其中一个自称 Googlebot,地址却不属于 Google。这类要在服务器或防火墙上拦,而不是靠 robots.txt。
如果屏蔽是因为爬虫给服务器带来负载,先想想问题是不是出在抓取预算和服务器报错上;全站屏蔽还会让搜索引擎无法抓取新页面。
看到的爬虫
5
遵守
3
违规
2
屏蔽后仍抓取
Disallow: / 之后的爬虫合规 · 7 天
示例| 爬虫 | 可信度 | 页面抓取 | robots.txt 抓取 | 状态 |
|---|---|---|---|---|
| Googlebot | 已验证 | 0 | 14 | 遵守 |
| Bingbot | 已验证 | 0 | 9 | 遵守 |
| GPTBot | 已验证 | 0 | 7 | 遵守 |
| 自称 Googlebot | 可疑 | 860 | 0 | 屏蔽后仍抓取 |
| 未知脚本客户端 | 未知 | 1,240 | 0 | 屏蔽后仍抓取 |
在 TapCub 里核查 robots.txt 合规
有了日志导入或服务端事件提供的服务端记录,爬虫合规会抓取你的规则文件,并和实际抓取对比。它标出三类违规:全站屏蔽时仍然抓取、抓取了禁止的路径、抓取间隔短于声明的延迟。可以重新抓取并重新扫描,打开违规行可以复制一段用于服务器的屏蔽代码。生成器可以按「屏蔽训练爬虫」「屏蔽答案引擎」「只允许主流搜索引擎」起草规则,由你发布到网站上。
正如页面上说明的,文件本身挡不住抓取,报表才是证据。抓取异常提醒能发现某个引擎的抓取量突然下降,这是误屏蔽的典型信号(见文档抓取健康与爬虫合规)。更多见 AI 爬虫和 llms.txt。
常见问题
robots.txt 怎么禁止所有爬虫?
在每个主机根目录的 robots.txt 里写 User-agent: *,下一行写 Disallow: /。
Disallow: / 会把网站从 Google 移除吗?
单靠它不会。页面不再被抓取,但网址仍可能不带描述地出现。要让页面不出现,用 noindex 或身份验证。
Disallow: / 和 Disallow: 后面留空有什么区别?
Disallow: / 屏蔽所有路径;空的 Disallow: 什么都不屏蔽。
怎么屏蔽除 Google 之外的所有爬虫?
写一个 User-agent: * 组配 Disallow: /,再写一个 User-agent: Googlebot 组配 Allow: /。Googlebot 只遵循自己的那一组。
所有爬虫都遵守 robots.txt 吗?
不是。主流搜索引擎和公开声明的 AI 爬虫表示会遵守;采集脚本和伪造的用户代理往往不会。查看日志,必要时在服务器上拦截。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。