llms.txt 是写给语言模型的一份简短网站导读。它很新、自愿遵守,也容易被高估。本文讲提案实际定义了什么、该写什么、一份删减后的真实示例、它和 robots.txt 怎么保持一致,以及怎么从服务器日志核实到底有没有智能体在读。
读完你会知道
- llms.txt 是挑选,不是权限;Google 说它的 AI 功能不需要它
- 结构:一个 H1、一段摘要引用块,再加若干附说明的链接小节
- 在服务器日志里核实:/llms.txt 被抓了几次,抓的页面有多少在清单里
本次更新 · 2026 年 11 月 3 日
按提案重写格式说明,补充 Google 的立场、真实示例和用服务器日志核实的方法;删除不存在的指标。
llms.txt 是什么,不是什么
本节已更新
llms.txt 是放在网站根目录的一个 Markdown 文件,给大语言模型一份简短的、经过挑选的网站导读:用一段话说清你是谁,再列出值得读的页面,每个附一句说明。它由 Jeremy Howard 在 2024 年 9 月提出(llmstxt.org),是社区提案,不是标准,也没有任何强制力。
可以把三个文件放在一起看。sitemap 列出所有页面,给搜索引擎看,不带取舍。robots.txt 管权限:哪些爬虫能抓哪些路径。llms.txt 是挑选,写给一个会把你转述给别人的读者。它不授予也不禁止任何东西:被 robots.txt 屏蔽的爬虫读不到它,被允许的爬虫也可以不理它。
对搜索的作用要看清楚。Google 明确说,想出现在它的 AI 功能里,不需要新建机器可读文件、AI 文本文件或特殊标记(Google 搜索中心)。所以把 llms.txt 当作一份成本很低的保险,留给真正会读它的助手和智能体:写一小时,每季度维护几分钟,效果在自己的日志里核实,而不是靠相信。
里面写什么
本节新增
提案定义的结构很简单,只有第一项是必需的:一个写着网站或项目名称的 H1。之后依次是:一段引用块形式的简短摘要、可选的补充段落,以及若干 H2 小节,每节是一组链接,格式是 Markdown 链接加冒号和说明。名为「Optional」的小节按约定放次要链接,读者上下文不够时可以跳过。
实际写的时候:
- 摘要放前面。 一段模型可以直接引用的话:你做什么、给谁用,以及别人常搞错的事实(计价货币、你不做什么)。
- 链接按用途分组。 产品页、文档、价格和政策,再加几篇把常见问题讲清楚的文章。
- 写说明,不写广告。 助手会引用说明文字,「领先的平台」出现在别人的回答里很难看。写清读者会看到什么。
- 用带域名的完整网址,指向规范页面,不要指向跳转或带跟踪参数的链接。
- 要挑选。 十几到几十个链接就够;什么都列,就又变回了 sitemap。
下面是我们发布的文件开头部分,有删减:
它和 robots.txt 的关系
本节已更新
两个文件要一致。llms.txt 里的每个网址,都必须对你希望它读的爬虫开放;一个页面列在 llms.txt 里、却在 robots.txt 里被屏蔽,爬虫的处理方式就是不抓。反过来也一样:给训练爬虫屏蔽掉的页面(用户内容、站内搜索结果、登录后区域)不应出现在 llms.txt 里。下表对比三个文件各自的作用;怎么屏蔽 AI 爬虫一文给了屏蔽训练、放行回答的 robots.txt 写法。
| 文件 | 给谁看 | 说什么 | 靠什么执行 |
|---|---|---|---|
| sitemap.xml | 搜索引擎 | 这是全部页面和更新时间 | 没有;只是抓取提示 |
| robots.txt | 所有爬虫 | 哪些爬虫能、不能抓哪些路径 | 爬虫自觉遵守;不遵守的靠服务器规则 |
| llms.txt | 语言模型和智能体 | 这些页面值得读,附摘要 | 没有;只是挑选后的建议 |
核实有没有人读
本节新增
「llms.txt 有没有用?」诚实的回答是「看服务器日志」。多数助手抓取时不执行 JavaScript,页面脚本看不到它们,需要服务端记录或导入访问日志。
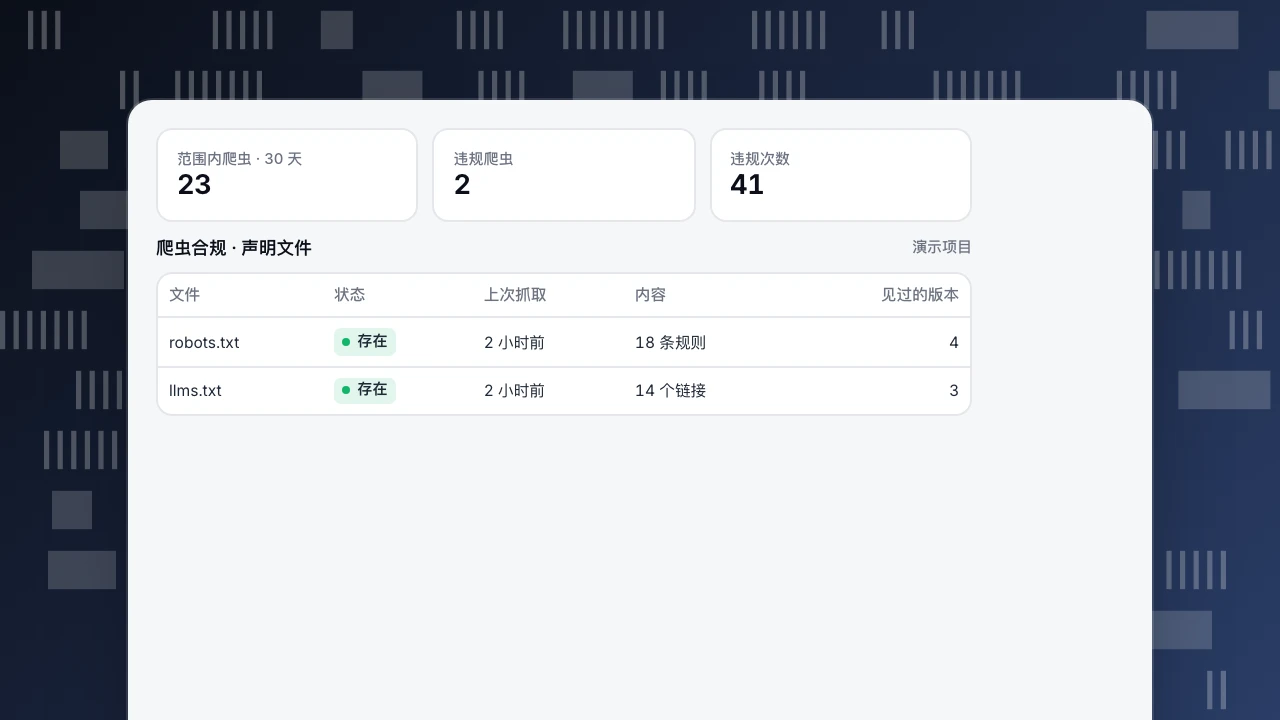
- 确认文件能访问。 TapCub 的爬虫合规页会抓取你的 robots.txt 和 llms.txt,显示每个文件是否存在、有多少条规则或链接、见过几个版本,还能生成一份 llms.txt 草稿,供你修改后发布。
- 统计文件被抓了几次。 在访问日志里筛出
GET /llms.txt,按 User-Agent 分组。刚开始一个月有几次来自回答类爬虫的抓取很常见;一个月一次都没有,说明还没人用。 - 对比爬虫抓的页面和你列的页面。 接入服务器日志后,抓取健康页会列出每个爬虫抓得多的页面。看其中有多少在你的文件里。发布后这个比例上升,说明文件起了作用;一直不变,就把时间花在别处。
TapCub 不会替你算这个比例;它是表格里十分钟的对比,每次改完文件一个月后再做一次。下面的示例是演示项目里两个文件在合规页上的样子。
范围内爬虫 · 30 天
23
违规爬虫
2
违规次数
41
爬虫合规 · 声明文件
演示项目| 文件 | 状态 | 上次抓取 | 内容 | 见过的版本 |
|---|---|---|---|---|
| robots.txt | 存在 | 2 小时前 | 18 条规则 | 4 |
| llms.txt | 存在 | 2 小时前 | 14 个链接 | 3 |
保持更新
本节已更新
llms.txt 和任何目录一样会过时。每季度检查一次;上线新产品页、下线文档或调整价格时也要改。说明要实事求是:如果助手引用了一句关于已下线功能的描述,那是你的文件写的。新文章少量添加,让文件一屏能看完;在开头注明上次检查的日期。
如果网站有多种语言,每条说明用它指向的页面的语言来写;每种语言的重点页面各放一个小节,或者在每个语言目录下各放一个文件。每次修改后到合规页看一眼,确认线上的文件就是你想发布的那份。
常见错误
本节已更新
我们反复看到的五种:
- 把所有页面都列上,成了第二个 sitemap。
- 用相对网址,或者网址会跳转、带跟踪参数。
- 说明写成口号,而不是摘要。
- 列出的页面恰好被 robots.txt 对你想吸引的爬虫屏蔽了。
- 发布后从没看过日志,就断定它没用。
一小时写好,一个月后核实,再调整。看日志时,可以用 AI 爬虫查询工具查某个 User-Agent 属于哪家、用来做什么。
常见问题
本节新增
llms.txt 是什么?
放在网站根目录的 Markdown 文件,2024 年提出,给语言模型一段网站摘要和一份附说明的重点页面清单。它是自愿的,不授予也不禁止任何抓取。
Google 会用 llms.txt 吗?
Google 表示,出现在它的 AI 功能里不需要 AI 文本文件或特殊标记,常规 SEO 做法就适用。llms.txt 写给真正会读它的助手和智能体,并在日志里核实。
llms.txt 和 robots.txt 有什么区别?
robots.txt 规定哪些爬虫能抓哪些路径;llms.txt 建议哪些页面值得读。两者要一致:不要在 llms.txt 里列出 robots.txt 对目标爬虫屏蔽的页面。
怎么知道 AI 爬虫有没有读我的 llms.txt?
在服务器访问日志里找对 /llms.txt 的 GET 请求,按 User-Agent 分组,再对比每个爬虫抓的页面和文件里列的页面。页面脚本看不到大多数 AI 抓取。
还需要 llms-full.txt 吗?
不是必需的。llms-full.txt 把页面全文放进一个文件,一些文档站会发布。先写一份简短的 llms.txt;只有文档经常被智能体读取时,再考虑完整版。
另见:AI 可见性。
更新记录1
- 大改按提案重写格式说明,补充 Google 的立场、真实示例和用服务器日志核实的方法;删除不存在的指标。
- 首次发布
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。