装了第二个统计工具的团队,第一周都会问同一个问题:数字为什么不一样?本文讲清 8 个原因,从脚本被拦、Cookie 同意,到机器人、会话规则、身份标识和时区;用一个例子拆开差距到底去了哪里,再给一份核对清单,一个下午就能把两个工具对清楚。
读完你会知道
- 两个统计工具对不上的 8 个原因,以及各自让哪边的数字变大或变小
- 算一个例子:通常大部分差距来自机器人和 Cookie 同意
- 比较日 UV 而不是月 UV,在同一个工具里看漏斗
本次更新 · 2026 年 11 月 3 日
按八个原因重写数据对不上的问题,新增核对清单、机器人和同意的示例以及常见问题。
为什么不同统计工具的数据对不上1. 脚本被拦和 Cookie 同意2. 机器人只抬高一边3. 会话规则先拉开差距4. 身份:Cookie、哈希和登录5. 估算而不是精确计数6. 时区和单页应用算一个例子核对清单为什么漏斗照样可信常见问题
为什么不同统计工具的数据对不上
本节新增
为什么不同统计工具的数据对不上?因为「访客」不是工具从网站上直接读出来的事实,而是每个工具按自己的规则算出来的:收到了哪些请求、哪些算机器人、几次请求合成一次访问、明天怎么认出同一个人、一次访问记在哪一天。两个工具只要有一处规则不同,独立访客(UV)就不会一样,而且两边都没有坏。
页面浏览(PV)接近事实:页面加载了,请求到了。访客是推断。下表是我们核对时依次检查的 8 个原因,以及每个原因会让哪一边的数字变大或变小。
| 原因 | 差在哪里 | 影响哪个数字 |
|---|---|---|
| 脚本被拦 | 广告拦截插件、隐私浏览器会拦掉一部分统计脚本 | 被拦的工具偏低 |
| Cookie 同意 | 依赖 Cookie 的工具,访客拒绝后就不统计 | 依赖同意的工具偏低 |
| 机器人 | 一边过滤爬虫和监控,另一边不过滤 | 不过滤的一边偏高 |
| 会话规则 | 空闲超时、最长时长、跨午夜和换广告参数是否切分 | 会话数,日 UV 略受影响 |
| 身份标识 | Cookie、设备 ID、服务端哈希还是登录 ID | 周 UV、月 UV 影响大 |
| 估算 | 有的工具对去重计数做近似估算 | 大数字上的小差异 |
| 时区 | UTC 还是站点时区,跨午夜的访问落在不同日期 | 按天的数字,月度影响小 |
| 单页应用 | 路由切换是否发页面浏览 | 先是 PV,再是会话 |
1. 脚本被拦和 Cookie 同意
本节新增
浏览器端的统计,脚本加载并执行了才算一次访问。广告拦截插件、隐私浏览器和公司网络过滤会拦掉一部分统计脚本,拦不拦往往取决于脚本的域名和文件名。服务器日志和主机面板没有这个问题,所以它们总比任何浏览器端工具高。
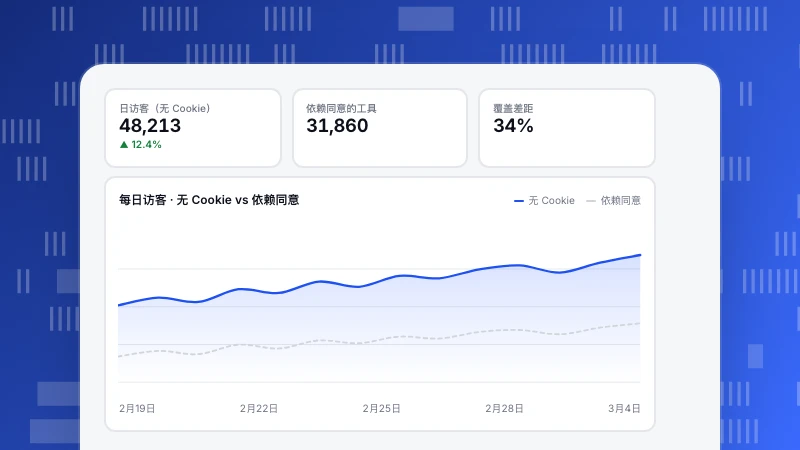
第二道过滤是 Cookie 同意。写 Cookie 的工具在要求同意的地区,通常要等访客点「接受」才统计,拒绝的人一律不算。这个缺口有多大取决于你的访客和弹窗设计,别直接套别人的百分比,在自己网站上量:同样的页面、同样的日期,比较依赖同意的工具和不需要同意的工具的日访客数。
2. 机器人只抬高一边
本节新增
差异最大的来源往往不是定义,而是一边统计、另一边剔除的流量。监控服务、链接预览、搜索引擎爬虫和 AI 爬虫都会加载页面。工具 A 剔除了、工具 B 没剔除,B 就永远偏高,而且某个爬虫来重新抓取的那几天,差距会突然变大。
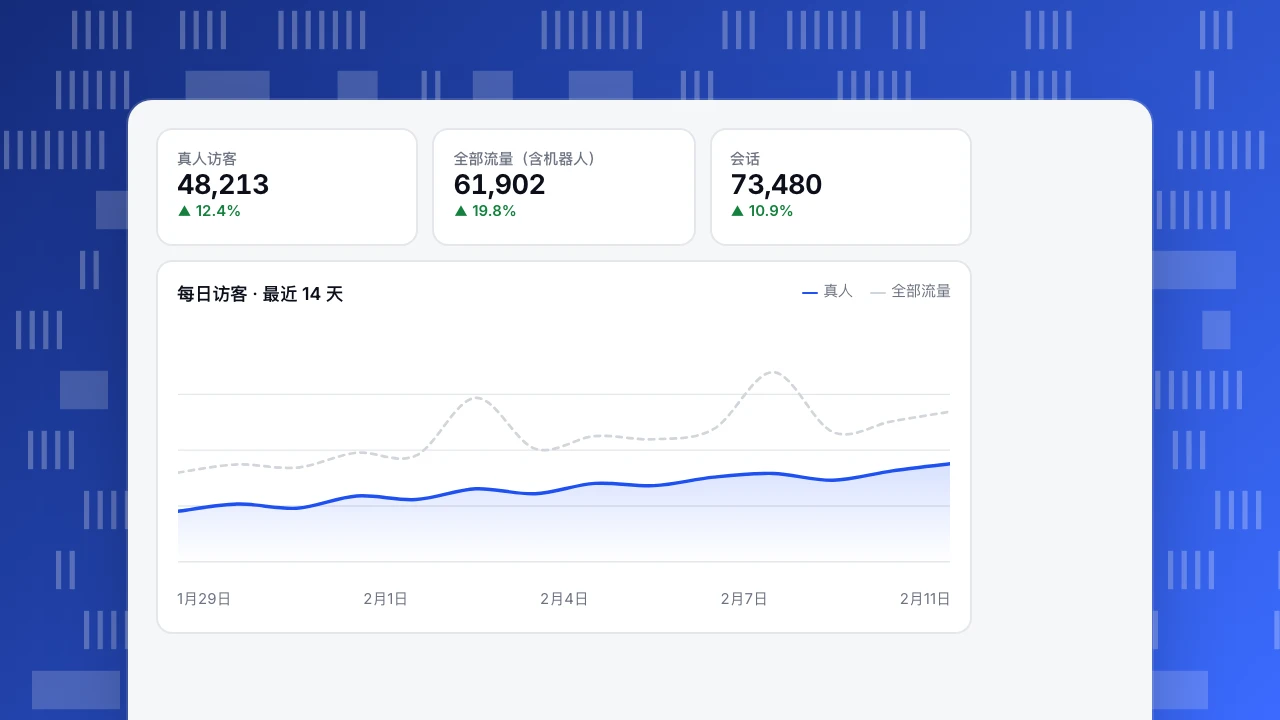
TapCub 用五层检测(User-Agent、请求头、客户端信号、网络归属、请求频率)加 197 条以上内置规则判断,并把机器人流量放进单独的报表,而不是悄悄删掉。默认模式下,识别出的机器人不计入人类访客、会话和页面浏览(见文档机器人与 AI 爬虫)。下面演示项目的图里,人类访客线比全部流量线低约 22%,有爬虫来的两天差距更大。
真人访客
48,213
▲ 12.4%
全部流量(含机器人)
61,902
▲ 19.8%
会话
73,480
▲ 10.9%
每日访客 · 最近 14 天
真人全部流量3. 会话规则先拉开差距
本节新增
会话按规则切分,各家规则不同。Google Analytics 4 默认空闲 30 分钟结束一个会话,超时时间可以按数据流修改(Google:关于 Analytics 会话)。还有的工具在午夜、或访问中途广告参数变化时另起一个会话。23:50 看了一页、00:05 又点了一下的访客,在第一种规则下是一个会话,在第二种规则下是两个。
TapCub 默认空闲 30 分钟、最长 24 小时;跨午夜和换广告参数不切分,除非你打开这个选项(见文档指标口径)。比较两边的会话数之前,先把两套规则并排写下来,最初那几个百分点的差异通常就出在这里。
4. 身份:Cookie、哈希和登录
本节新增
身份标识决定今天的访客和昨天的是不是同一个人。基于 Cookie 的工具在浏览器里存一个标识:换网络还认得,清空存储或换浏览器就认不出了。TapCub 默认无 Cookie:不写 Cookie 也不写本地存储,在服务端用站点、盐值、截断后的 IP 和浏览器类型算出一个带密钥的哈希。均衡模式下盐值保留,同一浏览器在同一网络第二天还能认出;严格模式下盐值每天更换,跨天不关联回访(见文档计数模式)。
实际做法:两个工具之间比较日 UV,这一层两种模型对「一个人」的理解基本一致;周 UV、月 UV 名字一样,其实是不同的指标。访客登录以后,用户 ID(identify)比这两种模型都准,因为它能跨设备认出同一个人。取舍细节见无 Cookie 统计一文。
5. 估算而不是精确计数
本节新增
数据量大时精确去重很贵,所以有的工具做估算。Google Analytics 用 HyperLogLog++ 算法估算活跃用户、会话等指标的去重数(Google Analytics 开发者博客,2022)。估算很接近,但两个估算方式不同的工具,或一个估算一个精确计数的工具,同样的输入也会有小差异。这种差异小而稳定;差距很大的话,原因一定在本文的其他几条里。
数据保留设置是相关的坑。GA4 标准媒体资源可以选保留 2 个月或 14 个月,这个设置影响探索和漏斗报告,不影响标准汇总报告(Google:数据保留)。所以一年前的同一个数字,从探索里取和从标准报告里取,在同一个工具里也可能不一样。
6. 时区和单页应用
本节新增
一个工具按 UTC 出报表,另一个按站点所在时区,深夜的同一次访问就会落在两天里,按天的数字永远对不齐,月度却能对上。按天比较之前,先确认两边的时区设置。
单页应用是最后一处分叉。React、Vue 应用里的路由切换不是页面加载。有的统计代码每次路由切换都发一次页面浏览,有的只在首次加载时发。先对不上的是 PV;如果会话只靠路由切换保持活跃,会话数也会跟着变。TapCub 的网页 SDK 默认在 history 变化时发送页面浏览。
算一个例子
本节新增
下面用一个网站一天的示例数字,看两个工具之间的差距一般是怎么分解的。工具 A 依赖 Cookie、前面有同意弹窗;工具 B 无 Cookie 统计并过滤机器人。
| 步骤 | 日访客 | 说明 |
|---|---|---|
| 工具 B,含机器人的全部流量 | 6,190 | 起点 |
| 工具 B,只看人类 | 4,820 | 剔除 1,370 个机器人访客 |
| 减去浏览器拦掉了工具 A 脚本的访客 | 4,390 | 430 人没到工具 A |
| 减去在工具 A 里拒绝 Cookie 的访客 | 3,240 | 1,150 人工具 A 不统计 |
| 工具 A 显示 | 3,190 | 剩下 50:会话、时区和估算的差异 |
从上往下读:差距几乎全部来自两道过滤,一边是机器人,一边是 Cookie 同意。剩下 1%–2% 是口径噪声,不必再追。你网站的比例会不一样,可以照搬的是这个方法。
核对清单
本节新增
一次只改一处,一个下午就能把两个工具对清楚。按下表从上往下查,每一项要么改成一致,要么记下原因,再看下一项。把记录放在报表旁边,下次有人问「为什么不一样」,直接能找到答案。
| 检查项 | 比较什么 | 不一致时的表现 |
|---|---|---|
| 机器人过滤 | 两边都只看人类,或都看全部流量 | 不过滤的一边偏高,爬虫来的日子出现尖峰 |
| 漏装页面 | 每个模板的 head 里都有统计代码吗? | 一边整块页面没有数据 |
| Cookie 同意 | 是否有一边只统计接受 Cookie 的人? | 依赖同意的一边偏低 |
| 会话规则 | 空闲超时、最长时长、跨午夜和广告参数是否切分 | 会话数差几个百分点 |
| 身份窗口 | 比较日 UV,不要比月 UV | 月 UV 差得多,日 UV 差得少 |
| 时区 | 两边报表时区一致吗? | 访问跨午夜落到不同日期 |
| 单页应用 | 两边都在路由切换时发数据吗? | 先是 PV 不一致,再是会话 |
从上往下查,一次只改一个设置。
为什么漏斗照样可信
本节新增
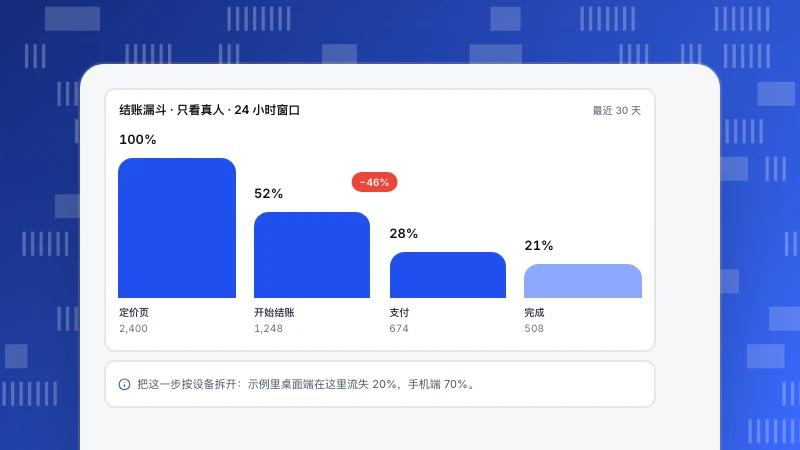
漏斗不需要总数和谁对上。它比较的是同一份数据里、用同一个口径统计的各个步骤。2,400 个访客到了定价页,1,248 个开始结算,674 个到了付款页,508 个完成,结算到付款之间掉了 46%,这个结论在任何口径下都成立,因为每一步都按同样的方式计数。
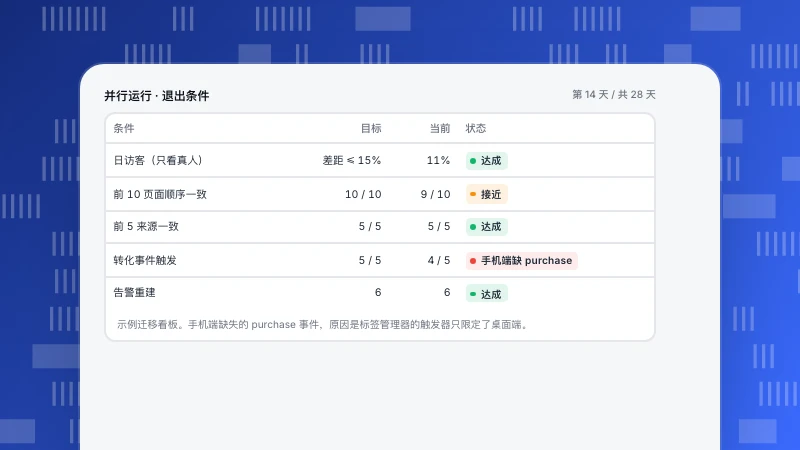
所以别再想办法让总数对上,改看趋势的形状。两个工具并行跑一段时间,比较趋势线、热门页面和来源的排序,形状一致了就选一个作为准绳。并行期怎么安排见 GA4 迁移清单,漏斗怎么建得经得起推敲见漏斗分析的常见错误。
常见问题
本节新增
哪个统计工具的数据是准的?
各自按自己的定义都是准的。服务器日志统计请求,包括机器人;依赖 Cookie 的工具统计同意了且浏览器执行了脚本的人;无 Cookie 工具统计浏览器执行了脚本的所有人,但认人的规则不同。选定义和你要做的决定相符的那个工具,并且一直用它。
两个工具差多少算正常?
没有通用的数字。把机器人过滤、会话规则、时区和身份窗口对齐以后,剩下的差异应该小而且每天稳定。如果每天差距忽大忽小,多半是机器人,或者有页面漏装了某一边的脚本。
为什么 Google Analytics 的用户数比服务器日志少?
服务器日志记录每个请求,包括机器人、拦截了统计脚本的访客和拒绝 Cookie 的访客。Google Analytics 只统计执行了它代码的浏览器,并按它自己的同意和会话规则计算。
应该比较日 UV 还是月 UV?
日 UV。月 UV 取决于每个工具怎么跨天认出同一个人,而依赖 Cookie、无 Cookie 和按登录识别的工具恰恰在这里差别很大。
能让两个工具完全一致吗?
做不到完全一致,也没必要。把能控制的设置对齐,其余的记录下来,用同一个工具里的趋势和漏斗做决定。
另见:跨域跟踪:设置方法和前后对照检查。
更新记录1
- 大改按八个原因重写数据对不上的问题,新增核对清单、机器人和同意的示例以及常见问题。
- 首次发布
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。