放不放 AI 爬虫进来,已经是网站的日常决定,而多数教程只给一段复制粘贴的 robots.txt。本文从每个爬虫按厂商说明到底做什么讲起,给出四种策略和各自的规则,说明 robots.txt 管不住什么,再用自己的数据核实规则是否生效、每个助手又带回了什么。
读完你会知道
- 训练爬虫、AI 搜索爬虫和用户触发抓取,要分别写规则
- 屏蔽训练爬虫不影响 Google 搜索;屏蔽 AI 搜索会让你从那些回答里消失
- 用服务端数据核实:大多数爬虫根本不执行你的统计脚本
本次更新 · 2026 年 11 月 3 日
改写为屏蔽 AI 爬虫指南:核实过的 User-Agent 清单、按用途的 robots.txt 写法和核实方法。
怎么屏蔽 AI 爬虫,又不影响搜索AI 爬虫的 User-Agent 和用途先定策略,再写规则写 robots.txt 规则robots.txt 管不住的,在服务器上管确认规则生效读懂 AI 内容账本一锤定音的那一列常见错误常见问题
怎么屏蔽 AI 爬虫,又不影响搜索
本节新增
想屏蔽 AI 爬虫,先要弄清楚屏蔽的是哪一种,因为「AI 爬虫」其实包含三种不同的工作。训练爬虫收集页面,可能用于训练模型。AI 搜索爬虫给页面建索引,让助手在它的搜索结果里展示并链接你。用户触发的抓取是有人向助手提问时,当场去打开某个页面。多数厂商每种工作用一个单独的 User-Agent,把「OpenAI」或「Anthropic」当成一个整体来写规则,挡掉的会比你想的多,或者少。
搜索引擎是第四类,下面的规则只要不点它们的名字,就不会影响它们。只想了解定义的话,可以看什么是 AI 爬虫;本文讲的是该放行谁、怎么写规则、怎么确认规则生效。
AI 爬虫的 User-Agent 和用途
本节新增
下表按各厂商自己的文档整理(2026-11-03 核对)。robots.txt 一列是厂商的说法,不是我们的测试结果。
| 厂商 | User-Agent | 用途 | 厂商对 robots.txt 的说法 |
|---|---|---|---|
| OpenAI | GPTBot | 训练 | 遵守,用 Disallow 退出 |
| OpenAI | OAI-SearchBot | ChatGPT 的搜索结果 | 遵守 |
| OpenAI | ChatGPT-User | 按用户请求抓取 | 「robots.txt 规则可能不适用」 |
| Anthropic | ClaudeBot | 训练 | 遵守,支持 Crawl-delay |
| Anthropic | Claude-SearchBot | 提升搜索结果质量 | 遵守 |
| Anthropic | Claude-User | 按用户提问抓取 | 遵守 |
| Google-Extended(只是标记) | Gemini 训练和信息支撑(grounding) | robots.txt 里的产品标记,日志里没有单独的 User-Agent | |
| Perplexity | PerplexityBot | Perplexity 的搜索结果,不用于训练 | 遵守 |
| Perplexity | Perplexity-User | 按用户请求抓取 | 「一般会忽略 robots.txt 规则」 |
来源:OpenAI 爬虫说明、Anthropic 爬虫说明、Google 常见爬虫、Perplexity 爬虫说明。
表里有两点会改变大多数人的决定。Google 明确说 Google-Extended 不影响网站能否出现在 Google 搜索里,也不是排名信号,所以屏蔽它不会损失搜索流量。另外,部分厂商的用户触发抓取不受 robots.txt 约束,因为要看这个页面的是人,不是爬虫。
先定策略,再写规则
本节新增
先用一句话写下策略,规则自然就出来了。常见的是下面四种:
| 策略 | 放行 | 屏蔽 | 代价 |
|---|---|---|---|
| 全部开放 | 所有爬虫 | 无 | 内容可能被用于训练;被引用的机会大 |
| 挡训练、放回答 | 搜索引擎、AI 搜索和用户触发抓取 | GPTBot、ClaudeBot、Google-Extended 等训练爬虫 | 保留引用和回访;页面不进入以后的训练数据 |
| 挡掉全部 AI | 只放搜索引擎 | 所有 AI 爬虫,包括 AI 搜索 | 助手无法引用或链接你;普通搜索不受影响 |
| 只保护私密路径 | 公开页面 | 对所有爬虫屏蔽账户、站内搜索结果、用户内容等路径 | 不管哪种爬虫,都抓不到不该抓的地方 |
希望出现在 AI 回答里的媒体和 SaaS 网站,常选「挡训练、放回答」。屏蔽 OAI-SearchBot 或 Claude-SearchBot 会让你从这两家的搜索结果里消失,除非这正是目的,否则别挡。
写 robots.txt 规则
本节新增
robots.txt 里的一组规则,是一行或多行 User-agent 加上后面的规则,规则对这一组里列出的每个爬虫都生效。按标准 RFC 9309,爬虫采用匹配得更具体的那条规则;Allow 和 Disallow 匹配程度相同时,以 Allow 为准。RFC 还规定,爬虫使用缓存的 robots.txt 不应超过 24 小时,所以改动可能要一天左右才生效。
「挡训练、放回答和搜索」的写法如下:
# AI 训练爬虫:不允许
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

# AI 搜索和用户触发抓取:允许
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
Allow: /

# 所有爬虫:私密路径不抓
User-agent: *
Disallow: /account/
Disallow: /search

Sitemap: https://example.com/sitemap.xml
robots.txt 管不住的,在服务器上管
本节新增
RFC 写得很清楚:这些规则「不是一种访问授权」。守规矩的爬虫会遵守,其他的没有任何东西强制它。下面三种情况要在服务器或 CDN 上加规则:
- 用户触发的抓取:厂商说可能不遵守 robots.txt,如果你完全不想让它们来。
- 照抓已禁止路径的爬虫:日志里能看到,说明这个文件对它们无效。
- 伪造 User-Agent:任何采集程序都能自称 GPTBot。用厂商公布的 IP 列表核对来源地址:OpenAI(gptbot.json、searchbot.json、chatgpt-user.json)、Anthropic、Perplexity(perplexitybot.json)。
在边缘按核实过的 User-Agent 和 IP 段拦截、返回 403,robots.txt 里的规则保留,作为公开的意向声明。
确认规则生效
本节新增
不核实的规则只是猜测。需要两样东西:谁抓了什么的记录,以及摆在旁边的你的规则。
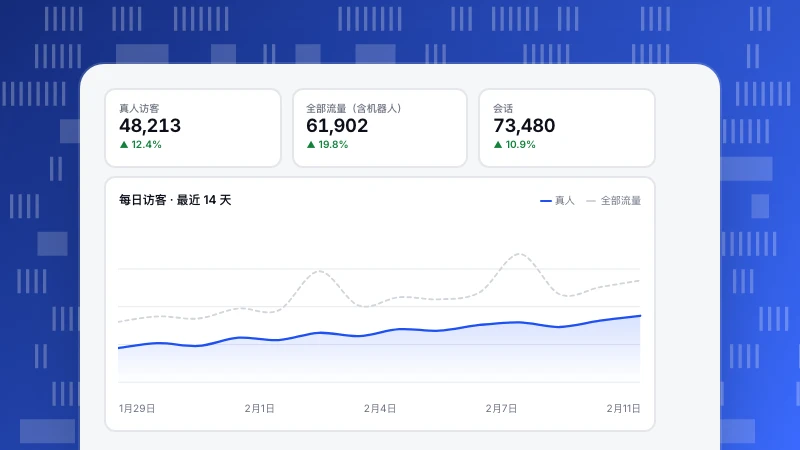
在 TapCub 里,记录来自「机器人」报表,它把搜索、AI 训练、AI 回答和监控类机器人与真人分开。有一个限制要注意:只装了页面脚本时,只能看到会执行 JavaScript 的机器人,而大多数爬虫不执行。要看全,需要接入服务端事件或导入服务器日志(见文档机器人与 AI 爬虫)。
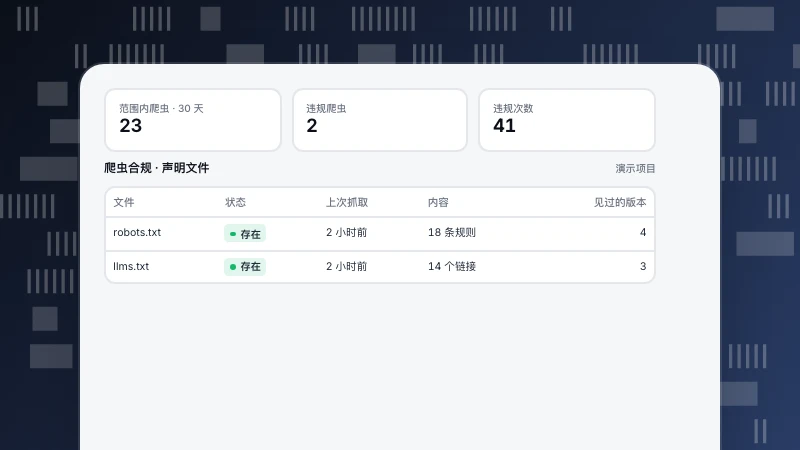
「爬虫合规」页面会抓取你的 robots.txt,和实际抓取记录对比,记录三种违规:全局屏蔽后仍抓取、抓取了禁止的路径、没按声明的 Crawl-delay 间隔抓取。每个爬虫有可信度(已验证、疑似伪造、未验证),点开违规的一行可以复制 User-Agent 标记和 Nginx 拦截片段。页面还带生成器,可以起草「屏蔽训练爬虫」「屏蔽回答引擎」「只放主要搜索引擎」的规则文件(见文档抓取健康与合规)。注意:把爬虫加进 TapCub 的排除规则只是不再统计它,真正拒绝它还要在你的服务器上做。
读懂 AI 内容账本
本节新增
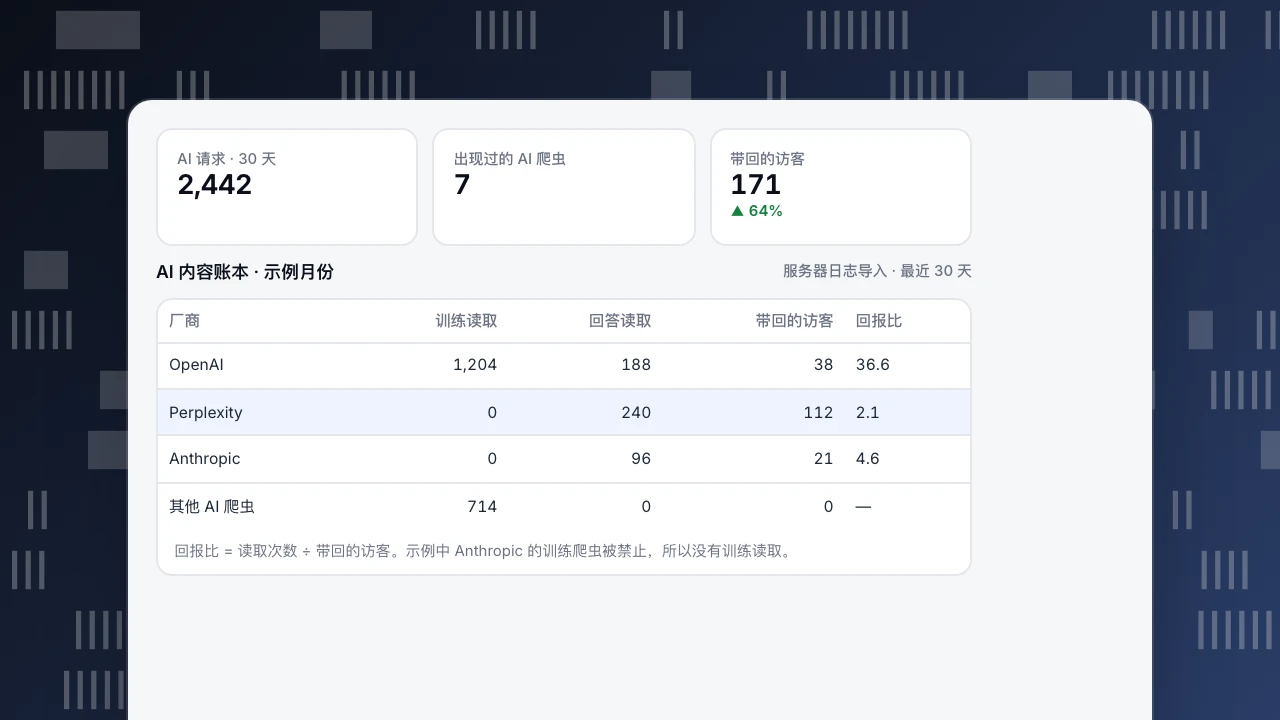
屏蔽只是一半的决定,另一半是每个助手给你带回了什么。「机器人」报表里的 AI 内容账本按厂商列出:训练爬虫和回答引擎分两列的读取次数、这家带回来的真人访客、以及回报比,即读取次数除以带回的访客。比值越大,说明读得多、来的人少。
AI 请求 · 30 天
2,442
出现过的 AI 爬虫
7
带回的访客
171
▲ 64%
AI 内容账本 · 示例月份
服务器日志导入 · 最近 30 天| 厂商 | 训练读取 | 回答读取 | 带回的访客 | 回报比 |
|---|---|---|---|---|
| OpenAI | 1,204 | 188 | 38 | 36.6 |
| Perplexity | 0 | 240 | 112 | 2.1 |
| Anthropic | 0 | 96 | 21 | 4.6 |
| 其他 AI 爬虫 | 714 | 0 | 0 | — |
回报比 = 读取次数 ÷ 带回的访客。示例中 Anthropic 的训练爬虫被禁止,所以没有训练读取。
一锤定音的那一列
本节新增
「带回的访客」这一列把意见变成了数字。示例里,Perplexity 的读取量只是 OpenAI 的一小部分,带回的访客却是三倍,因为它的读取是为了回答问题,不是训练。Anthropic 的训练爬虫被禁止,没有读取。按这个规律做决定:读得多、带不回人的,考虑屏蔽;能带回人的,值得放行,还可以用 llms.txt 文件把它引向你的重点页面。
AI 带来的访问在「来源」报表里也是单独的渠道,按真人会话统计,可以看到助手引用了哪些页面、这些访客是否转化。账本建议每月看一次,厂商每隔几个月就会新增或改名爬虫。
常见错误
本节新增
- 把一家厂商当成一个爬虫:屏蔽 OpenAI 的全部爬虫,也会让你从 ChatGPT 搜索结果里消失。
- 为了不进 AI 去屏蔽 Googlebot:这会让你从 Google 搜索里消失。Gemini 训练和信息支撑用的是 Google-Extended。
- 以为马上生效:爬虫可能缓存 robots.txt 长达 24 小时。
- 规则放错主机:robots.txt 按主机和协议生效,www、主域名和每个子域名都要有自己的文件。
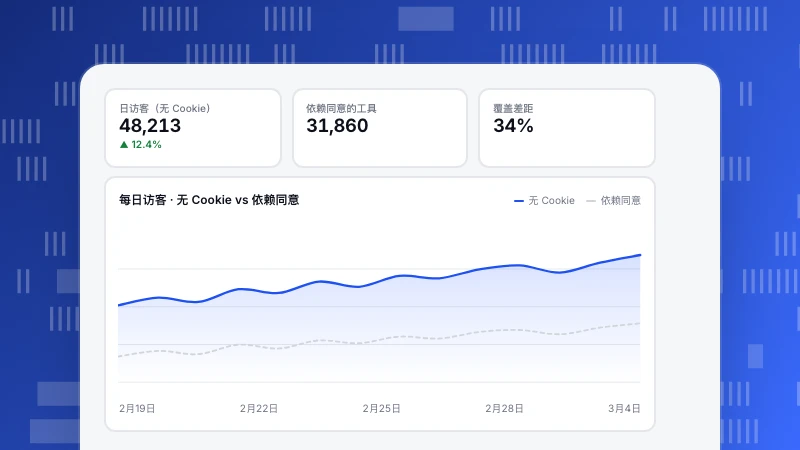
- 只看 JavaScript 数据下结论:大多数爬虫不执行脚本,只靠脚本统计会严重少算。
常见问题
本节新增
屏蔽 GPTBot 或 ClaudeBot 会影响 Google 排名吗?
不会。它们是 OpenAI 和 Anthropic 的训练爬虫,和 Google 搜索无关。按 Google 的说法,连它自己的 Google-Extended 标记也不影响 Google 搜索的收录和排名。
屏蔽 GPTBot 后,ChatGPT 就不会引用我的网站了吗?
单靠它不行。GPTBot 用于训练。ChatGPT 的搜索结果来自 OAI-SearchBot,按用户请求的抓取来自 ChatGPT-User,OpenAI 说后者可能不遵守 robots.txt。
AI 爬虫遵守 robots.txt 吗?
主要厂商说它们的训练和搜索爬虫遵守。按厂商自己的文档,部分用户触发的抓取可能不遵守。用日志核实,需要的话在服务器上拦截。
改了 robots.txt 多久生效?
大约一天以内。RFC 9309 规定爬虫依赖缓存不应超过 24 小时。
robots.txt 有法律约束力吗?
标准本身说这些规则不是访问授权。把 robots.txt 当作公开的策略声明,用服务器规则来执行。
相关阅读
另见:PerplexityBot:它读什么、带回什么,以及要不要放行。
另见:AI 引荐流量:怎么识别和衡量。
更新记录1
- 大改改写为屏蔽 AI 爬虫指南:核实过的 User-Agent 清单、按用途的 robots.txt 写法和核实方法。
- 首次发布
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。