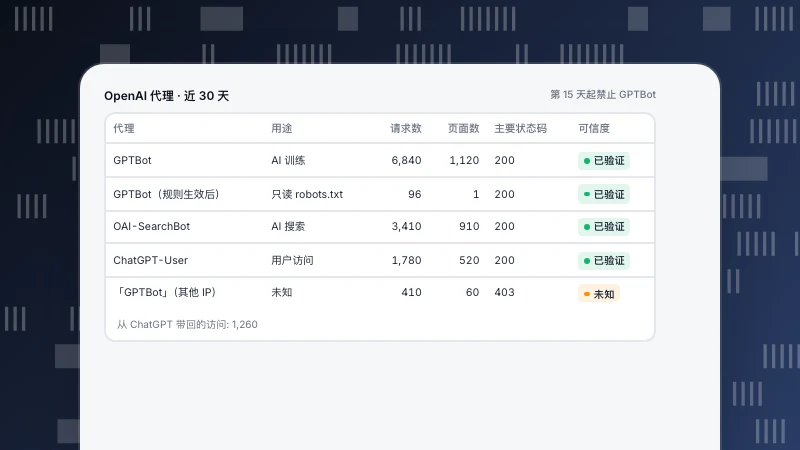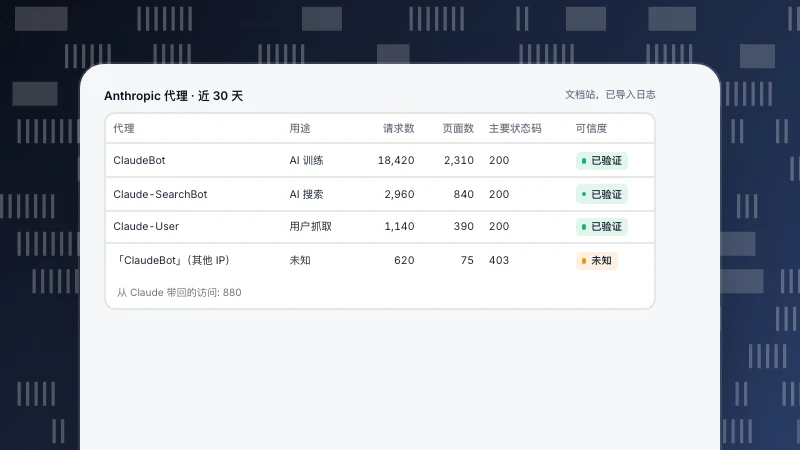
抓取预算是搜索引擎能够并且愿意在你的网站上抓取多少。本文讲清什么时候需要关心、什么在浪费它,以及怎么读服务器日志,看搜索引擎和 AI 爬虫的请求到底花在了哪里。
读完你会知道
- 抓取预算主要对页面极多或变化很快的网站重要
- 服务器错误压低容量上限;失效和重复网址浪费需求
- noindex 省不了抓取;用 robots.txt 和 404 或 410
抓取预算对你的网站重要吗?
对多数网站来说,不重要。Google 的抓取预算指南写明,它主要面向大型网站(约 100 万个以上独立页面、每周有变化)、中型网站(约 1 万个以上页面、每天变化),以及在 Search Console 里有大量网址处于「已发现 - 尚未编入索引」的网站。指南说这些只是粗略估计,不是硬性门槛(见 Google 抓取预算指南)。
如果你的网站规模较小,新页面几天内就会被抓取,抓取预算就不是你的问题,内容和链接才是。本文剩下的部分写给可能受影响的网站,也用来检查爬虫有没有把请求浪费在不该存在的网址上。
抓取预算怎么定
Google 把它分成两部分。抓取容量上限是在不压垮服务器的前提下能抓多少:网站响应快就上调,变慢或报错就下调。抓取需求是它想抓多少,取决于网址的热门程度、新鲜程度以及它知道多少网址。预算按主机名计算,www 和子域名分开算。
实践中有两点很关键:服务器错误和慢响应会压低容量上限;爬虫知道的每一个无用网址,都在和你真正的页面抢抓取。
什么在浪费它
表里列出常见的抓取浪费来源,以及 Google 指南对每一种的建议做法。有一点常让人意外:noindex 省不了抓取预算,因为页面仍然要先被请求,才能看到这个标记。不想让无关网址被抓,用 robots.txt;已删除的页面,返回 404 或 410。
| 浪费来源 | 例子 | 处理 |
|---|---|---|
| 重复网址 | 排序、筛选、追踪参数产生的变体 | 规范网址;合并 |
| 无限网址空间 | 分面组合、日历、站内搜索 | 用 robots.txt 屏蔽 |
| 软 404 | 空分类页返回 200 | 返回真正的 404 |
| 已删除页面 | 下架商品、过期文章 | 404 或 410;删除内链 |
| 重定向链 | A → B → C | 链接和重定向直接指向最终网址 |
| 服务器慢或报错 | 超时、5xx | 修复错误;做缓存;支持 304 |
| 用 noindex 来省抓取 | 带 noindex 的分面页 | 改用 robots.txt;noindex 仍要抓一次 |
处理方式依据 Google 抓取预算指南。
看爬虫实际把请求花在哪里
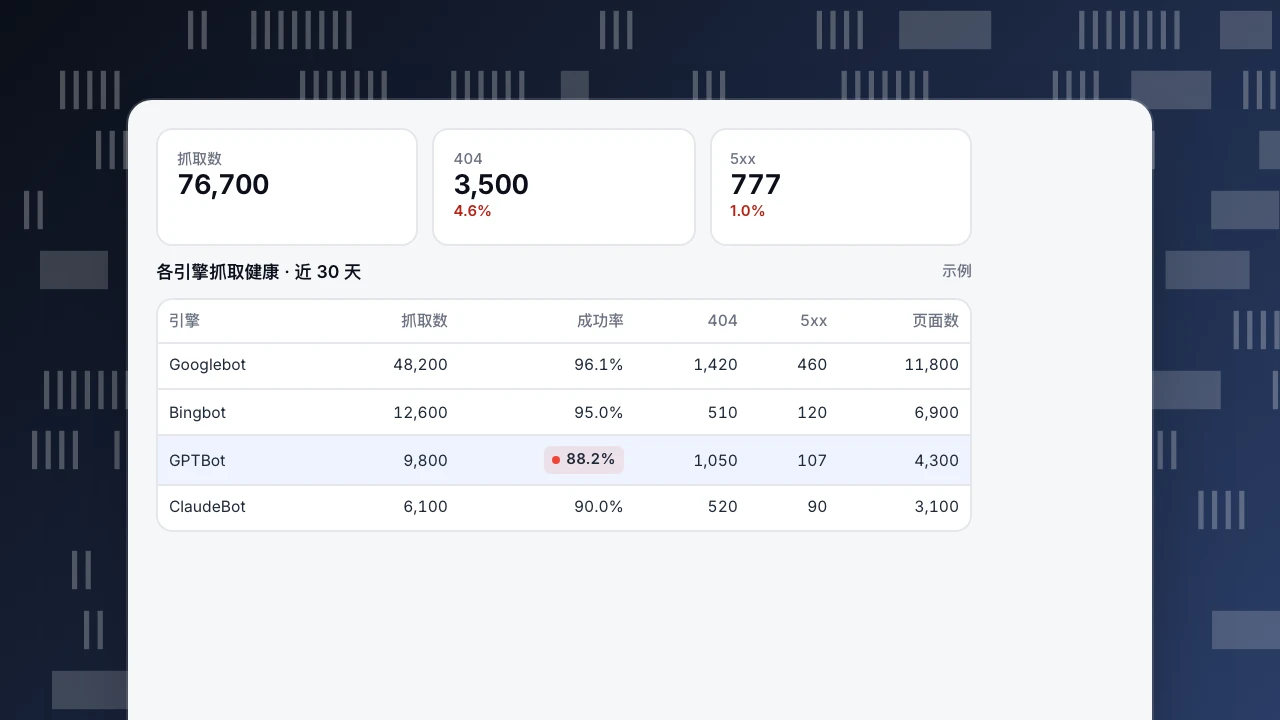
Search Console 显示的是 Google 的视角。服务器日志能看到所有爬虫,包括 AI 爬虫,它们用的是同一份服务器容量。按引擎把抓取分组,看成功率、404、5xx,以及各自抓了多少个不同页面。
示例里,GPTBot 有超过十分之一的请求落在 404 上,大多是旧网址。Googlebot 的 460 次服务器错误更要紧:错误会压低整个主机的容量上限。处理顺序是:先修 5xx,再处理爬虫反复请求的 404(有对应新页面的做重定向,其余返回 404 或 410),然后是重复网址和带参数的网址。AI 爬虫方面,见 GPTBot、ClaudeBot 和 AI 爬虫台账。
抓取数
76,700
404
3,500
4.6%
5xx
777
1.0%
各引擎抓取健康 · 近 30 天
示例| 引擎 | 抓取数 | 成功率 | 404 | 5xx | 页面数 |
|---|---|---|---|---|---|
| Googlebot | 48,200 | 96.1% | 1,420 | 460 | 11,800 |
| Bingbot | 12,600 | 95.0% | 510 | 120 | 6,900 |
| GPTBot | 9,800 | 88.2% | 1,050 | 107 | 4,300 |
| ClaudeBot | 6,100 | 90.0% | 520 | 90 | 3,100 |
一个可行的处理顺序
- 先止住服务器错误。 5xx 和超时会让任何爬虫都少抓。
- 清理失效网址。 删掉指向它们的内链,返回 404 或 410。
- 合并重复页面。 排序、筛选和追踪参数产生的变体指定规范网址。
- 屏蔽无限网址空间。 分面组合、日历和站内搜索用 robots.txt 屏蔽。
- 保持站点地图最新,带上
lastmod,避免重定向链。 - 两周后按引擎再查一次。
在 TapCub 里看抓取健康
抓取报表需要服务端记录,因为页面脚本看不到状态码,也看不到不执行 JavaScript 的爬虫;可以通过日志导入或服务端事件发送。抓取健康按引擎显示总抓取数、成功率(状态码低于 400)、不同页面数、404 和 5xx,并列出每个爬虫抓得多的页面。设置了站点地图网址后,它会对比站点地图里的网址和实际抓取,并显示近 30 天的新页面等了多久才被各引擎首次抓取。
爬虫合规把实际抓取和你的 robots.txt 对比,标出三类违规:全站屏蔽时仍然抓取、抓取了禁止的路径、抓取间隔短于声明的延迟。开启抓取异常提醒后,某个引擎 24 小时内的抓取量低于它 7 天日均的 30% 时会通知你(见文档抓取健康与爬虫合规)。更多见机器人流量和 AI 爬虫。
常见问题
什么是抓取预算?
搜索引擎在一段时间内能够并且愿意在一个网站上抓取的网址数量,由服务器容量和引擎对页面的需求决定。
小网站需要关心抓取预算吗?
很少需要。Google 的指南针对的是页面非常多或变化非常频繁的网站。
noindex 能节省抓取预算吗?
不能。页面仍然要先被请求,才能读到这个标记。不想被抓的网址用 robots.txt。
AI 爬虫会占用我的抓取预算吗?
它们不占 Google 的预算,但用的是同一份服务器容量。如果它们导致报错或响应变慢,会影响 Google 抓多少。
怎么查看自己的抓取预算?
Google 方面看 Search Console 的抓取统计报告,其他引擎看按引擎分组的服务器日志。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。