爬虫决定了你的页面会不会被收录、被 AI 模型使用、被 AI 答案引用,而其中一些并不是它自称的身份。本文讲爬虫怎么工作、日志里会看到哪些类型、怎么验证和控制,并附一周的日志算例。
读完你会知道
- 爬虫抓取页面、提取链接再顺着链接走
- robots.txt 只是请求,采集器不理会
- AI 训练爬虫和 AI 搜索爬虫要分开决定
- 用反向 DNS 或公开 IP 列表验证爬虫
- 很多 AI 爬虫不执行 JavaScript
什么是网络爬虫?
网络爬虫(web crawler,也叫蜘蛛或机器人)是一种自动访问网页的程序:下载页面,提取里面的链接,再顺着链接找到更多页面。搜索引擎用爬虫建索引;AI 公司用爬虫收集训练数据、为回答问题抓取页面;SEO 工具、可用性监控和比价程序也在用。
在一般的网站上,自动化请求占了全部流量的很大一块。知道哪些爬虫来过、抓了什么、是不是它自称的那个,既是 SEO 的事,也是安全的事。
网络爬虫怎么工作
- 种子地址。 爬虫从已知地址出发:以前抓过的页面、站点地图、站长提交的链接。
- 待抓队列。 等待抓取的地址排成队列,按重要性、新鲜度和页面变化频率排序。
- 检查 robots。 抓取前,守规矩的爬虫会读该主机的
/robots.txt,跳过禁止的路径(机器人排除协议,已标准化为 RFC 9309)。 - 抓取。 用自己的 user-agent 字符串请求页面,控制频率,避免把服务器压垮。
- 解析和渲染。 提取正文、链接和元数据。Googlebot 等会在之后再渲染一遍 JavaScript;很多 AI 爬虫不会。
- 存储和排期。 内容进入索引或数据集,新链接加入队列,页面排进下次回访。
网络爬虫的类型
| 类型 | 用途 | 例子(user-agent 标识) |
|---|---|---|
| 搜索引擎 | 建立和更新搜索索引 | Googlebot、Bingbot、Applebot、YandexBot、Baiduspider |
| AI 训练 | 收集内容训练模型 | GPTBot、ClaudeBot、CCBot、Bytespider、Google-Extended(是 robots.txt 标识,不是单独的爬虫) |
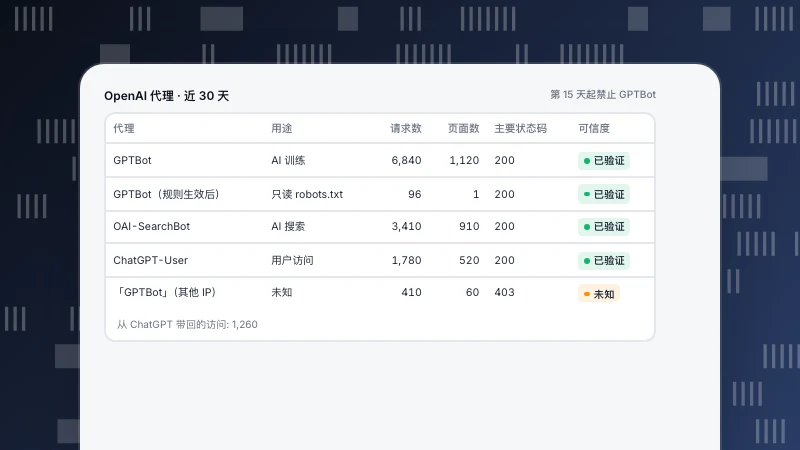
| AI 搜索和用户触发 | 为回答问题或引用来源而抓取页面 | OAI-SearchBot、ChatGPT-User、PerplexityBot、Claude-User |
| SEO 工具 | 为工具用户绘制链接和排名 | AhrefsBot、SemrushBot、MJ12bot |
| 监控 | 可用性、性能和合成监测 | Pingdom、UptimeRobot、Lighthouse 运行器 |
| 采集器和未知 | 比价采集、内容搬运、漏洞扫描 | 常用伪造或通用的 user-agent |
AI 训练爬虫和 AI 搜索爬虫的区别会影响决策:屏蔽训练爬虫,你的内容不进模型训练数据;屏蔽搜索或用户触发的爬虫,你就从那家助手的答案里消失,也拿不到它带来的访问。
| 类型 | 屏蔽后的影响 |
|---|---|
| 搜索引擎 | 页面从搜索结果消失 |
| AI 训练 | 内容不进模型训练 |
| AI 搜索 / 用户触发 | 从 AI 答案消失,也没了它带来的访问 |
| SEO 工具 | 第三方工具里数据变少 |
| 采集器 | 按验证过的身份屏蔽 |
在 robots.txt 里按 user-agent 标识逐个决定。
算例:七天的爬虫流量
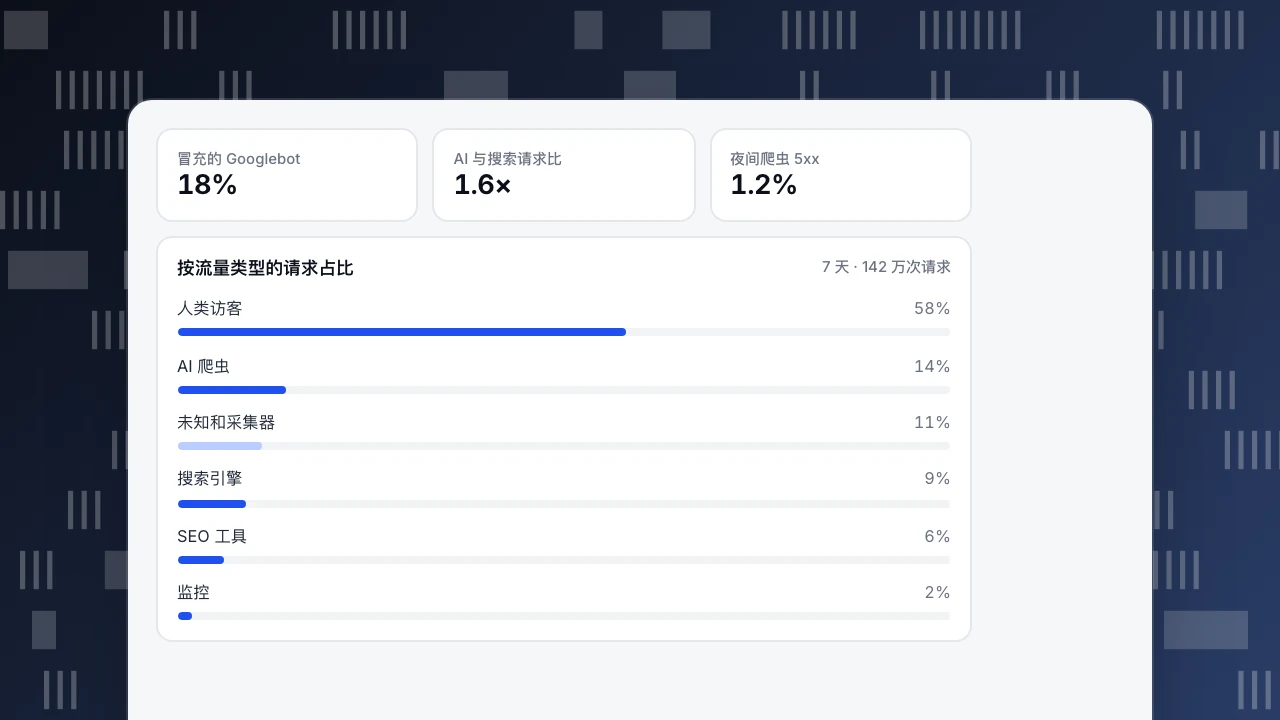
一个内容网站分析了 7 天的服务器日志,共 1,420,000 次请求(示例数字):
| 流量类型 | 请求占比 | 请求数 |
|---|---|---|
| 人类访客 | 58% | 823,600 |
| AI 爬虫(训练和答案) | 14% | 198,800 |
| 未知和采集器 | 11% | 156,200 |
| 搜索引擎爬虫 | 9% | 127,800 |
| SEO 工具 | 6% | 85,200 |
| 监控 | 2% | 28,400 |
日志里看到的情况:
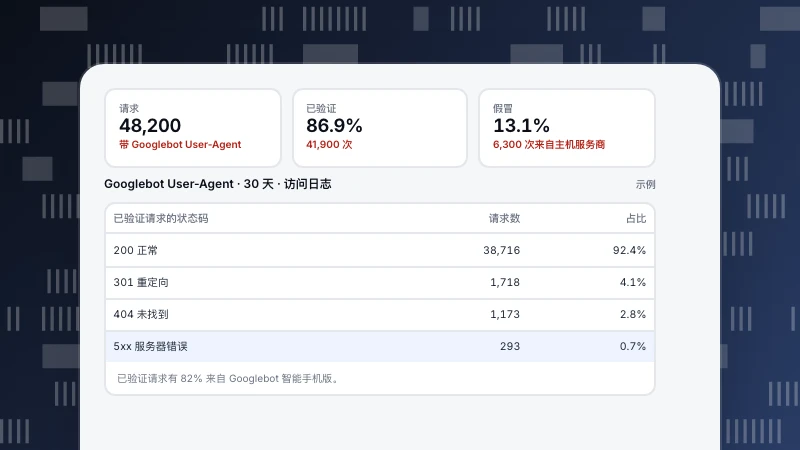
- 自称 Googlebot 的不都是 Google。 21,400 次请求带着 Googlebot 的 user-agent,其中 3,900 次(18%)来自反向 DNS 验证不通过的 IP,是借可信名字躲避屏蔽的采集器。
- AI 爬虫比搜索爬虫多。 AI 机器人的请求数是搜索引擎的 1.6 倍,但大部分抓的是旧的归档页。
- 一个 SEO 工具在抓筛选地址。 SEO 工具 41% 的请求打在
?color=red&size=m这类筛选组合上,这些地址网站本来就不想被收录。 - 错误藏在爬虫流量里。 夜间备份时段,搜索爬虫有 1.2% 的请求拿到 5xx;那个时段几乎没有真人访问,所以一直没人发现。
处理:屏蔽冒充 Googlebot 的 IP,对筛选参数加 Disallow,把备份挪出抓取高峰,AI 搜索类机器人继续放行,训练类机器人另行评估。
冒充的 Googlebot
18%
AI 与搜索请求比
1.6×
夜间爬虫 5xx
1.2%
按流量类型的请求占比
7 天 · 142 万次请求怎么识别和验证爬虫
- User-agent: 头一个线索,但很容易伪造。
- 反向 DNS: 查请求 IP 的主机名,确认以运营商的域名结尾(Google 是
googlebot.com、google.com或googleusercontent.com),再做正向解析,确认能解析回同一个 IP。 - 公开的 IP 段: Google、Bing、OpenAI 等会发布爬虫 IP 的 JSON 列表,拿来比对。
- 行为: 请求频率、是否读取 robots.txt、是否执行 JavaScript、请求了哪些路径。
怎么控制爬虫
- robots.txt 按 user-agent 标识允许或禁止路径。它是请求,不是访问控制:守规矩的爬虫会遵守,采集器不会。
- Meta robots 和 X-Robots-Tag 让已抓取的页面不进索引(
noindex),或不跟随链接。 - 站点地图 把你想被发现的地址和最后修改时间告诉爬虫。
- 限流和 WAF 规则 对付无视 robots.txt 或压垮服务器的爬虫;按验证过的身份屏蔽,不要只看 user-agent。
- 服务端渲染 让你想被 AI 爬虫读到的内容出现在 HTML 里,因为很多 AI 爬虫不执行 JavaScript。
在 TapCub 里查看爬虫
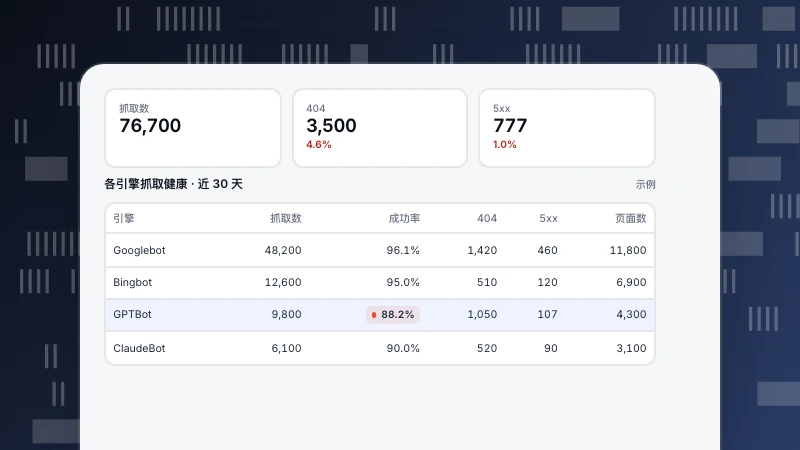
网站统计 › 机器人 默认把已识别的机器人和人类流量分开。「All bots」列出每个爬虫的名称、运营商、用途(搜索、AI 训练、AI 答案引擎、监控)、请求数、页面数、最常见状态码、可信等级(已验证、疑似或未知)和命中的检测层(机器人识别怎么工作)。监测 › 抓取健康 检查成功率,以及抓取是否遵守了你的 robots.txt(检查抓取健康)。
只装页面脚本时,只能看到会执行 JavaScript 的爬虫。大多数搜索和 AI 爬虫只抓 HTML、不跑脚本,要看全就得接入服务端采集或导入服务器日志。具体爬虫见 Googlebot 和 GPTBot;用日志做 SEO 见 日志文件分析。
资料来源
- IETF,RFC 9309: Robots Exclusion Protocol(2022)。
- Google 搜索中心,Verifying Googlebot and other Google crawlers。
- Google 搜索中心,Overview of Google crawlers and fetchers。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。