服务器日志记录的是搜索引擎爬虫实际请求了什么,而不是抓取工具的推测。本文讲怎么拿到日志、验证 Googlebot 是真的,以及用六个问题把原始日志变成 SEO 修复项。
读完你会知道
- 统计之前先用反向和正向 DNS 验证 Googlebot
- 把各栏目的抓取占比和自然访问占比对比
- 先修 5xx 和浪费请求的网址空间
为什么要看日志
Search Console 展示的是 Google 视角的一部分样本。站点抓取工具展示的是爬虫可能找到什么。服务器日志记录的是每个爬虫实际请求了什么,以及你返回的状态码和响应时间。所以像「Googlebot 把时间花在了哪些栏目」「AI 爬虫遵守了我们的 robots.txt 吗」这类问题,只有日志能回答。
拿到日志
向 Web 服务器、负载均衡或 CDN 要原始访问日志,至少覆盖两到四周。常见的 combined 格式依次是:客户端地址、两个占位符、时间、请求行、状态码、字节数、来源页和用户代理;有些服务器会在末尾加上响应时间。如果大部分页面由 CDN 缓存返回,那么能反映爬虫抓取情况的是 CDN 的日志,而不是源站的。
日志里有访客地址,要妥善保管。做 SEO 只需要爬虫的那些行。
验证 Googlebot
任何人都能发一个写着 Googlebot 的用户代理。Google 给出的方法是两步 DNS 检查:对地址做反向解析,得到的主机名必须属于 googlebot.com、google.com 或 googleusercontent.com;再对这个主机名做正向解析,必须得到同一个地址。量大时,改为把地址和 Google 公布的 IP 段文件比对(见验证 Google 抓取工具)。
下面的命令统计自称 Googlebot 的请求的状态码和热门路径,再验证一个地址。在 combined 格式里,第 9 个字段是状态码,第 7 个是路径。
# 自称 Googlebot 的请求,按状态码统计
grep 'Googlebot' access.log | awk '{print $9}' | sort | uniq -c | sort -rn

# Googlebot 请求得多的路径
grep 'Googlebot' access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20

# 验证一个地址:先反向解析,再正向解析
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com
六个要问的问题
表里列出六个问题,覆盖了日志分析的大部分用途,以及每个问题看什么、通常怎么处理。按顺序来:先排除冒充的爬虫,后面的数字才是真实爬虫的。
| 问题 | 看什么 | 通常怎么处理 |
|---|---|---|
| 这些爬虫是真的吗? | 反向和正向 DNS、公布的 IP 段 | 分析时排除冒充者;滥用的在服务器上拦 |
| 爬虫拿到了什么状态码? | 各爬虫 3xx、4xx、5xx 的占比 | 修 5xx;更新会跳转或 404 的链接 |
| 抓取花在了哪里? | 各栏目抓取数和自然访问对比 | 屏蔽或合并低价值栏目 |
| 哪些网址空间在浪费请求? | 参数、站内搜索、分面、日历 | robots.txt、规范网址、减少链接 |
| 哪些重要页面从没被抓? | 站点地图里没有抓取记录的网址 | 加内链;检查站点地图和 robots.txt |
| 对爬虫的响应有多快? | 各栏目响应时间 | 给慢的模板加缓存或提速 |
先回答第一个问题,后面的数字才都是真实爬虫的。
抓取占比和价值对比
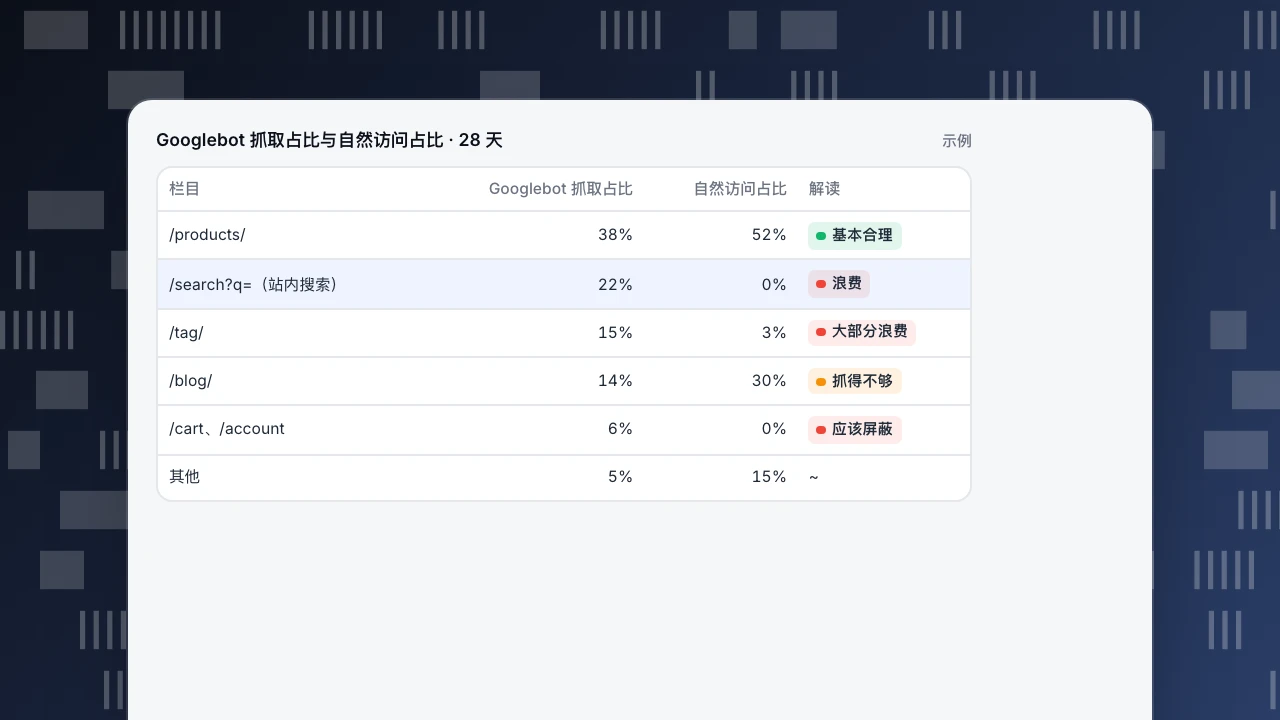
一个很有用的视图,是把每个栏目在已验证 Googlebot 抓取中的占比,和它在自然搜索访问中的占比放在一起。示例里,站内搜索结果占了 Googlebot 22% 的请求,却没有带来任何自然访问;标签页占 15%,只带来 3% 的访问。而博客文章只得到 14% 的抓取,却带来 30% 的自然访问。处理办法:用 robots.txt 屏蔽站内搜索、合并内容单薄的标签页、从常被抓取的页面链接新文章。见抓取预算和 Google 多久抓取一次。
Googlebot 抓取占比与自然访问占比 · 28 天
示例| 栏目 | Googlebot 抓取占比 | 自然访问占比 | 解读 |
|---|---|---|---|
| /products/ | 38% | 52% | 基本合理 |
| /search?q=(站内搜索) | 22% | 0% | 浪费 |
| /tag/ | 15% | 3% | 大部分浪费 |
| /blog/ | 14% | 30% | 抓得不够 |
| /cart、/account | 6% | 0% | 应该屏蔽 |
| 其他 | 5% | 15% | ~ |
在 TapCub 里做日志分析
日志导入接受 combined 格式的日志行(每次最多 5,000 行,请求体不超过 2 MB),末尾可选的耗时会存为响应时间。只保存被识别为爬虫的行;返回结果会告诉你解析了多少行、接受多少、跳过多少,格式不对一眼就能看出来(见文档日志导入)。
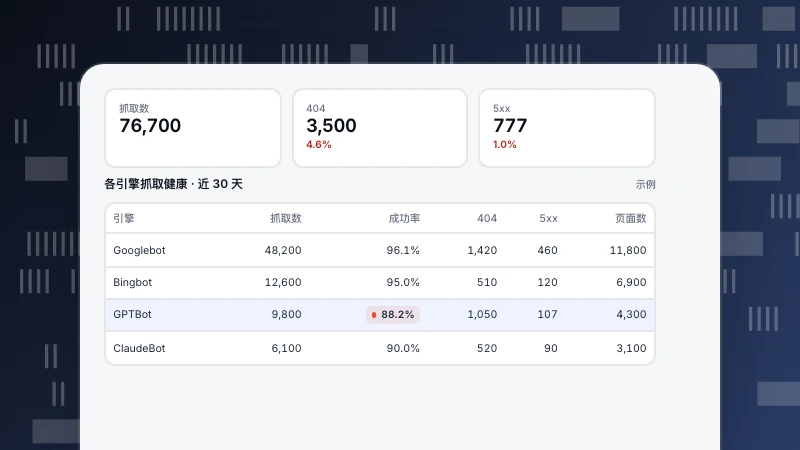
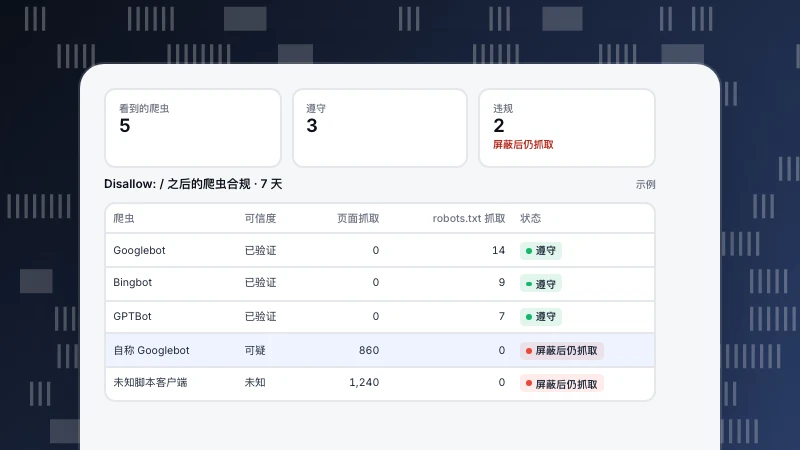
导入的记录会进入抓取健康(按引擎看抓取数、成功率、不同页面数、404 和 5xx,以及抓得多的页面和站点地图覆盖)和爬虫合规(把抓取和你的 robots.txt 对比)(见文档抓取健康与爬虫合规)。爬虫和访客分开统计,并分为已验证、可疑、未知三种可信度。更多见 robots.txt 禁止所有爬虫、机器人流量和 AI 爬虫。
常见问题
SEO 里的日志分析是什么?
读服务器访问日志,看搜索引擎爬虫请求了哪些网址、多频繁,以及拿到了什么状态码和响应时间。
怎么拿到服务器日志?
从 Web 服务器、负载均衡或 CDN 获取,通常是按天切分的访问日志文件。没有权限的话,找主机商或开发同事。
怎么判断 Googlebot 的请求是真的?
对地址做反向 DNS 解析,确认主机名以 googlebot.com、google.com 或 googleusercontent.com 结尾,再做正向解析,确认返回同一个地址。
需要多少日志数据?
两到四周通常足以看出规律。大型网站可以抽样几天。
做日志分析需要专门的工具吗?
起步不需要。命令行工具或表格就能回答基本问题;日志量大或需要持续报表时,工具才更有帮助。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。