ClaudeBot 是 Anthropic 的训练爬虫,但访问你网站的 Anthropic 代理不止它一个。本文介绍三个代理以及屏蔽各自会怎样,常见目标下的 robots.txt 写法,怎么用 Anthropic 公布的 IP 列表核实请求,以及怎么在自己的数据里看到 ClaudeBot。
读完你会知道
- ClaudeBot(训练)、Claude-User(用户抓取)和 Claude-SearchBot(搜索)分开控制
- 用 robots.txt 退出;屏蔽 IP 可能让爬虫读不到你的规则
- 按来源 IP 对照 Anthropic 公布的列表核实,并把规则和实际抓取对照
ClaudeBot 是什么
ClaudeBot 是 Anthropic 用来收集公开网页内容、可能用于训练模型的网络爬虫。它是 Anthropic 列出的三个网络访问 User-Agent 之一,三者的行为不同,所以一行规则屏蔽「Claude」,可能带来你没想到的影响(见 Anthropic 帮助)。
Anthropic 表示,它的爬虫遵守 robots.txt 的禁止抓取规则,并尊重反规避技术,比如不会尝试绕过验证码。
Anthropic 的三个代理
根据 Anthropic 的帮助文章:
- ClaudeBot 收集可能用于训练的公开内容。屏蔽它,表示你今后的内容应被排除在训练数据之外。
- Claude-User 在 Claude 用户提问、需要读某个网页时去抓取。屏蔽它会停止这类由用户发起的抓取,可能降低你的网站在用户向 Claude 提问时的可见度。
- Claude-SearchBot 抓取网页以提升搜索结果质量。屏蔽它会停止这类索引,可能降低你在 Claude 搜索结果中的可见度。
下表把三者并排列出。实际要回答的,很少是「屏蔽不屏蔽 Claude」,而是这三个里你要哪几个。
| 代理 | 做什么 | 屏蔽后 |
|---|---|---|
| ClaudeBot | 收集可能用于训练的公开内容 | 表示今后的内容排除在训练之外 |
| Claude-User | Claude 用户提问时抓取网页 | 这类抓取停止,可能降低在回答里的可见度 |
| Claude-SearchBot | 抓取以改进搜索结果 | 索引停止,可能降低在搜索结果里的可见度 |
来源:Anthropic 帮助文章,2026-04-07 更新。每个代理有自己的 robots.txt 组。
robots.txt 写法
robots.txt 是 Anthropic 支持的退出方式。把它放在每个主机的根目录,想覆盖的每个子域名都要放一份。每个代理单独写一组:
示例屏蔽了训练,但保留用户抓取和搜索。Anthropic 还对 ClaudeBot 支持非标准的 Crawl-delay 规则(「在合适的情况下」),所以如果担心的是负载而不是训练,可以选择让它慢一点。
Anthropic 指出,改为屏蔽它的 IP 地址可能起不到退出作用,因为爬虫这样就读不到你的 robots.txt 了。用 robots.txt 表达决定,用限流处理负载。
# 退出训练,保留回答和搜索
User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

# 或者不屏蔽,只让 ClaudeBot 慢一点
# User-agent: ClaudeBot
# Crawl-delay: 1
核实请求是不是真的 ClaudeBot
任何人都能发送写着 ClaudeBot 的 User-Agent。Anthropic 把爬虫使用的 IP 段公布在一个 JSON 文件里:claude.com/crawling/bots.json;来自列表中地址的请求就是 Anthropic 的。从服务器日志里挑几条请求,把来源地址和列表对照。自称 ClaudeBot、却来自其他地址的请求不是 Anthropic 的,按其他未知机器人处理。
在自己的数据里看 ClaudeBot
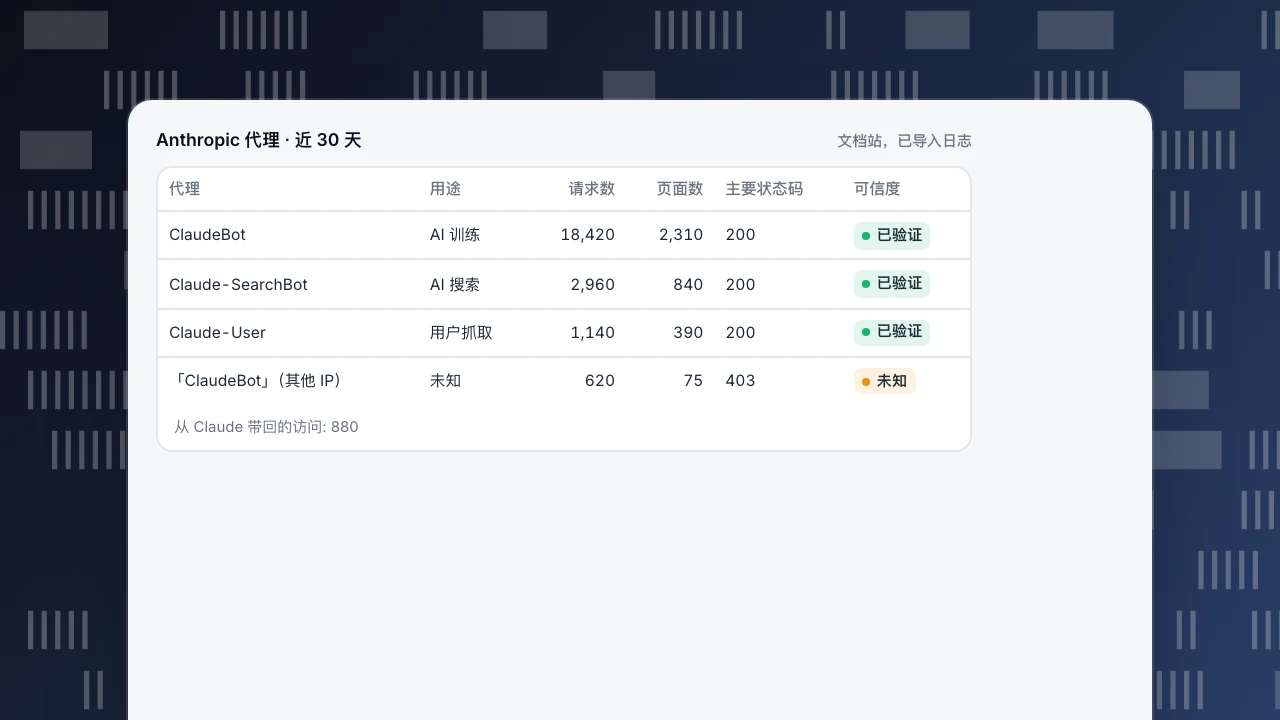
做决定之前,先看它实际读了什么。每个代理值得看的数字:请求数、不同页面数、收到的状态码,以及 Claude 反过来带来多少真人访客。示例是一个文档站一个月的情况:ClaudeBot 读得远多于另外两个,而 Claude-User 的抓取和从 Claude 回来的访问大致对应。
大多数 AI 爬虫不执行 JavaScript,所以靠页面脚本的统计工具几乎看不到它们。要完整计数,需要服务器日志或日志导入。比较抓取量和回流访问,见 AI 爬虫台账。
Anthropic 代理 · 近 30 天
文档站,已导入日志| 代理 | 用途 | 请求数 | 页面数 | 主要状态码 | 可信度 |
|---|---|---|---|---|---|
| ClaudeBot | AI 训练 | 18,420 | 2,310 | 200 | 已验证 |
| Claude-SearchBot | AI 搜索 | 2,960 | 840 | 200 | 已验证 |
| Claude-User | 用户抓取 | 1,140 | 390 | 200 | 已验证 |
| 「ClaudeBot」(其他 IP) | 未知 | 620 | 75 | 403 | 未知 |
从 Claude 带回的访问: 880
要不要屏蔽 ClaudeBot?
取决于你发布的是什么、想从 AI 助手那里得到什么。靠内容赚钱的网站常常屏蔽训练爬虫、保留用户抓取。希望在回答里被引用的网站,通常允许 Claude-User 和 Claude-SearchBot,也可能允许 ClaudeBot。有负载问题的网站可以用 Crawl-delay。无论怎么选,都要确认它生效了:robots.txt 规则只是表达你的意愿,要和实际抓取对照。相关内容:llms.txt、AI 爬虫和 AI 爬虫检查工具。
TapCub 里的 ClaudeBot
机器人报表列出每个机器人的运营方、用途(搜索、AI 训练、AI 回答引擎、监控)、请求数、页面数、最常见的状态码、最近出现时间和可信度(已验证、可疑或未知)。AI 内容台账按运营方列出抓取量和带回的真人访客(见文档机器人与 AI 爬虫)。默认情况下,识别出的机器人不计入真人报表。只装页面脚本时,只能看到会执行 JavaScript 的机器人;状态码和不执行 JavaScript 的爬虫需要服务端采集或日志导入。
爬虫合规会抓取你的 robots.txt,和实际抓取对比,标出三类违规:屏蔽后仍抓取、抓取了禁止的路径、比声明的间隔抓得更快。生成器可以起草「屏蔽训练爬虫」「屏蔽回答引擎」这类规则,由你发布到网站上(见文档抓取健康与合规)。
常见问题
ClaudeBot 是什么?
Anthropic 用来收集可能用于训练模型的公开内容的网络爬虫。Anthropic 还有 Claude-User 和 Claude-SearchBot。
怎么屏蔽 ClaudeBot?
在每个主机和子域名根目录的 robots.txt 里加上 User-agent: ClaudeBot 和 Disallow: /。
屏蔽 ClaudeBot 会让我的网站从 Claude 的回答里消失吗?
单靠它不会。用户发起的抓取用的是 Claude-User,搜索用的是 Claude-SearchBot,各自由自己的 robots.txt 组控制。
ClaudeBot 遵守 Crawl-delay 吗?
Anthropic 表示,在合适的情况下 ClaudeBot 支持非标准的 Crawl-delay 扩展。
怎么判断 ClaudeBot 是真的?
把请求的来源 IP 和 Anthropic 公布在 claude.com/crawling/bots.json 的列表对照。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
