很多 robots.txt 教程里都有 Google-Extended,但它不是爬虫,你也永远不会在日志里看到它。它是一个标记,告诉 Google 抓到的内容能不能用于 Gemini 和其他一些 AI 产品。本文讲清它控制什么、不控制什么,以及怎么安全地设置。
读完你会知道
- Google-Extended 是 robots.txt 里的产品标记;Google 仍然用 Googlebot 抓取
- 屏蔽它不影响 Google 搜索的排名和抓取
- 它管不到搜索里的 AI 概览;AI 概览遵循搜索摘要的控制
Google-Extended 是标记,不是爬虫
Google-Extended 是一个可以写在 robots.txt 里的产品标记。它不是单独的机器人:Google 仍用现有的爬虫(比如 Googlebot)抓取页面,Google-Extended 规则告诉 Google,抓到的内容能不能用于某些 AI 用途。
Google 的文档说,这个标记让发布者管理自己的内容是否用于训练未来的 Gemini 模型,以及是否用于 Gemini 应用和其他一些 Google AI 产品的事实依据(grounding)。覆盖的产品清单会变,以 Google 爬虫文档的最新说法为准。
所以你永远不会在服务器日志里看到「Google-Extended」:没有任何请求带着这个用户代理。
它控制什么、不控制什么
下表总结这个标记的作用范围。
| 范围 | Google-Extended 能控制吗? | 否则用什么控制 |
|---|---|---|
| 用内容训练未来的 Gemini 模型 | 能 | User-agent: Google-Extended |
| Gemini 应用和部分 AI 产品的事实依据 | 能(以 Google 的清单为准) | User-agent: Google-Extended |
| Google 搜索的抓取和收录 | 不能 | Googlebot 规则、noindex |
| 搜索里的 AI 概览 | 不能 | nosnippet、max-snippet(影响所有摘要) |
| 其他公司的 AI 爬虫 | 不能 | 它们各自的 user-agent 规则组 |
Google 会更新覆盖的产品清单,以它的爬虫文档为准。
一份 robots.txt 例子
一个发布者想留在 Google 搜索里,但不想被用于 Gemini 训练。它的 robots.txt(示例):
User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /admin/
改完之后(示例数字):
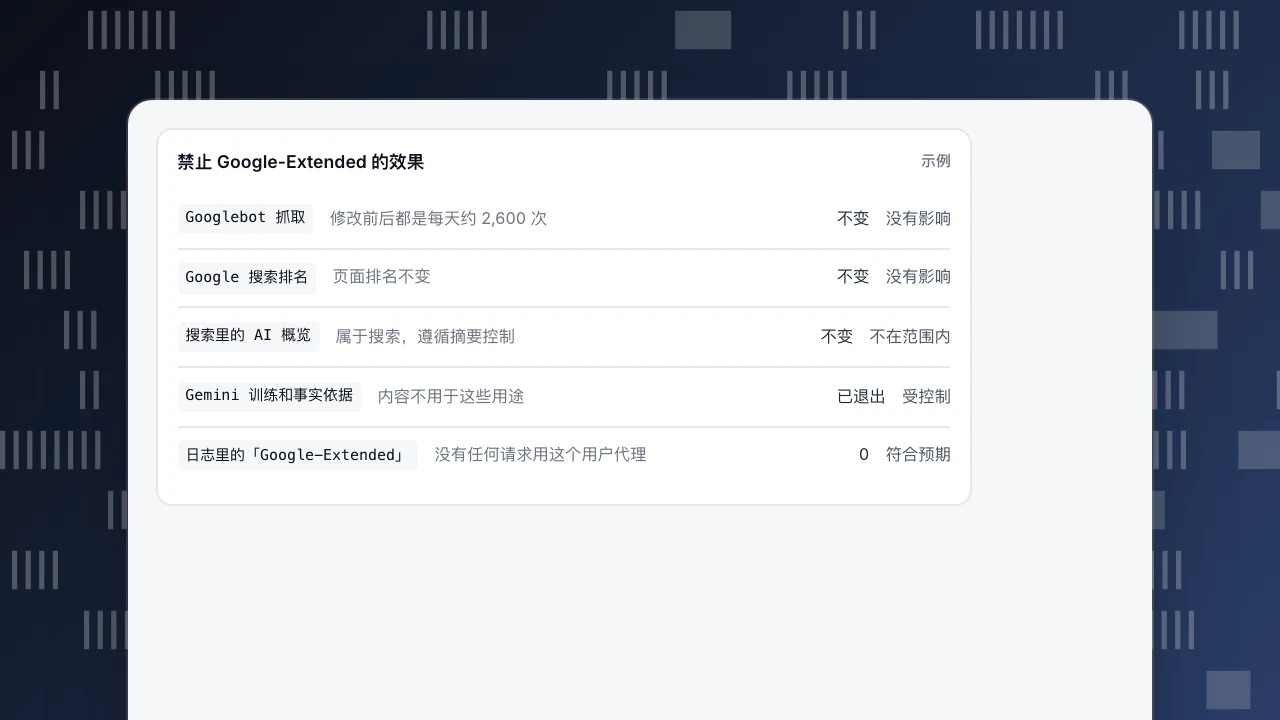
- Googlebot 的抓取在修改前后都是每天约 2,600 次:抓取和搜索都不受影响。
- 和预期一样,没有出现任何带 Google-Extended 用户代理的请求。
- 页面的搜索排名不变,也仍可能出现在 AI 概览里,因为 AI 概览属于搜索的一部分。
常见错误:写了 User-agent: Google-Extended 加 Disallow: /,同时又不小心留了一个屏蔽全部的通配组(User-agent: * / Disallow: /),却没有单独的 Googlebot 组。Googlebot 会遵守通配组,整个网站就从搜索里掉出去了。一定要确认每个爬虫会遵守哪一组规则:爬虫只遵守点了它名字的那一组,如果单独给 Googlebot 写一组,这一组里也要写上它自己的 Disallow。
禁止 Google-Extended 的效果
示例Googlebot 抓取修改前后都是每天约 2,600 次不变没有影响Google 搜索排名页面排名不变不变没有影响搜索里的 AI 概览属于搜索,遵循摘要控制不变不在范围内Gemini 训练和事实依据内容不用于这些用途已退出受控制日志里的「Google-Extended」没有任何请求用这个用户代理0符合预期
要不要用
- 选择退出:出于授权、竞争或编辑上的原因,不希望内容被用来训练 Gemini 模型或作为它的事实依据。
- 保持开放:被 Google 的 AI 产品使用和引用,对你来说比控制权更重要。
- 无论哪种,都不会改变你的搜索排名。
- 如果你关心的是内容在搜索的 AI 概览里怎么出现,Google-Extended 管不到。那里能用的是
nosnippet、max-snippet这类搜索控制,它们也会影响普通的搜索摘要。
其他 AI 爬虫是分开的
Google-Extended 只管 Google。其他公司有各自命名的爬虫,比如 GPTBot、ClaudeBot 和 Meta-ExternalAgent,每个都要写自己的 robots.txt 规则组。见 Meta-ExternalAgent、GPTBot 和 ClaudeBot。
在 TapCub 里监测
Google-Extended 从不抓取,所以没有什么可数的。你能看的是:
- 监测 › 抓取健康:Googlebot 的抓取次数、成功率和错误,确认改 robots.txt 没有让抓取变少。
- 监测 › 爬虫合规:把真实抓取和你的规则文件对比,列出违规;生成器可以起草「禁止训练爬虫」这类规则,由你检查后发布。
- 网站统计 › 来源 的「AI 来源」页签:AI 助手带来的真人访问,看每种选择让你得到或失去了什么。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。