Meta-ExternalAgent 在很多服务器日志里是最活跃的 AI 爬虫之一。本文讲清它做什么、和 Facebook 链接预览背后的爬虫有什么区别、怎么验证,以及怎么通过对比它读取的量和 Meta 带回的访客来决定要不要允许它。
读完你会知道
- Meta-ExternalAgent 为 AI 训练和索引收集内容;facebookexternalhit 抓取链接预览
- 要屏蔽训练爬虫可以用 robots.txt,但要保留 facebookexternalhit 才有链接预览
- 先对比读取量和带回的访客再做决定;规则被无视时在服务器上强制屏蔽
什么是 Meta-ExternalAgent
Meta-ExternalAgent 是 Meta 运营的网络爬虫。Meta 的文档说,它抓取网页用于训练 AI 模型,以及通过直接索引内容来改进产品等用途。它的用户代理里包含 meta-externalagent,例如:
meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler)在很多网站上,它已经成了最活跃的 AI 爬虫之一,所以不少人在日志里看到它之后会去搜。
Meta 的三个爬虫
Meta 文档里有几个分工不同的爬虫。下表对比它们。区分清楚很重要:屏蔽错了,别人在 Facebook、Instagram 或 WhatsApp 分享你的页面时,链接预览可能就没了。
| 爬虫 | 做什么 | robots.txt | 屏蔽之后 |
|---|---|---|---|
| Meta-ExternalAgent | 为 AI 训练和索引抓取 | 按 Meta 的说法会遵守 | 内容不会被收集用于这些用途 |
| FacebookExternalHit | 为链接预览抓取标题、图片和描述 | 预览和安全检查时可能绕过 | 分享的链接可能没有预览 |
| Meta-ExternalFetcher | 用户发起请求时抓取页面(如 AI 助手的请求) | 代表用户行事,不一定适用 | 助手无法为这个用户读取页面 |
以 Meta 文档里的最新列表为准;爬虫名称和用途会变。
怎么验证
用户代理可以伪造。Meta 的文档给了一个方法,按 Meta 的网络(AS32934)列出它的爬虫使用的 IP 段:
whois -h whois.radb.net -- '-i origin AS32934' | grep ^route带 Meta 用户代理、但 IP 不在这些段里的请求,不是 Meta 发的。
完整例子:读取量和带回的访客
某内容网站 30 天的服务端数据(示例数字):
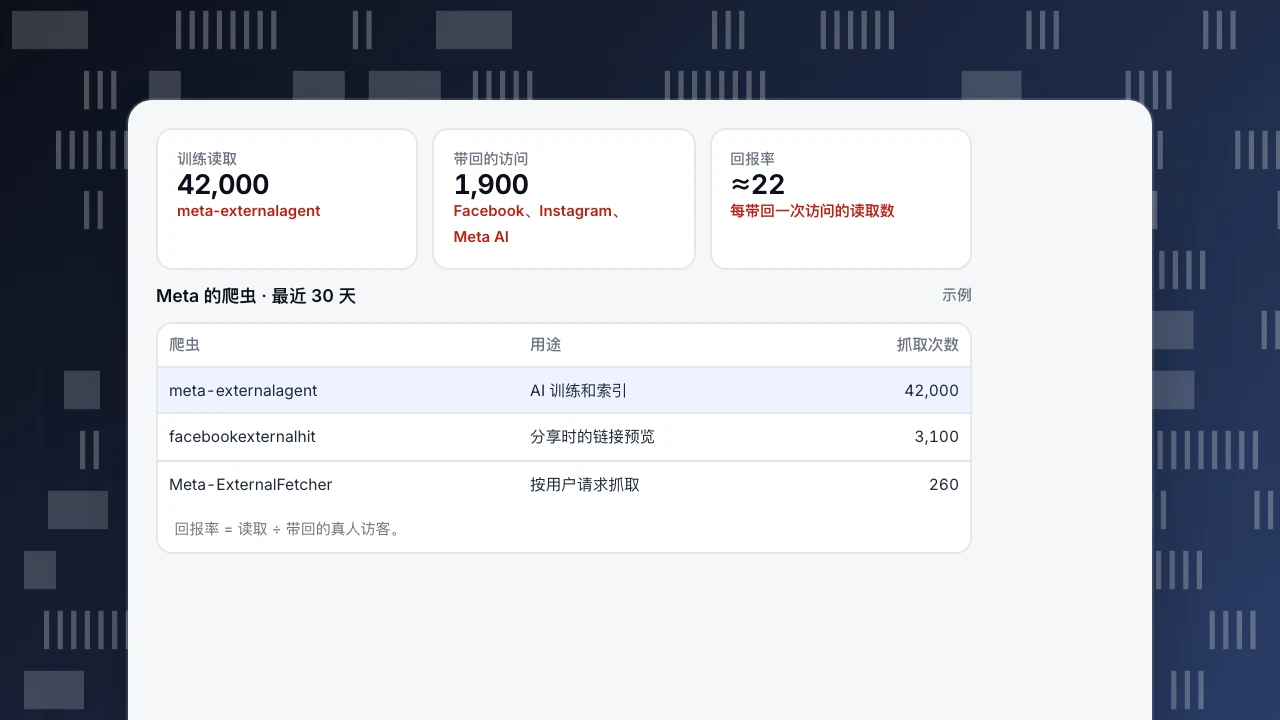
- meta-externalagent:抓取 42,000 次,大多是博客和文档页
- facebookexternalhit:抓取 3,100 次,由用户分享链接触发
- Meta-ExternalFetcher:抓取 260 次
- 来自 Facebook、Instagram 和 Meta AI 的真人访问:1,900 次
怎么读:Meta 的训练爬虫每读约 22 个页面,Meta 才带回一个访客(42,000 ÷ 1,900)。相比之下,链接预览爬虫是直接为访客服务的:每次分享显示出预览,都让点击更有可能发生。
这个网站决定:付费文档屏蔽 Meta-ExternalAgent,公开博客继续允许,facebookexternalhit 不动。
训练读取
42,000
meta-externalagent
带回的访问
1,900
Facebook、Instagram、Meta AI
回报率
≈22
每带回一次访问的读取数
Meta 的爬虫 · 最近 30 天
示例| 爬虫 | 用途 | 抓取次数 |
|---|---|---|
| meta-externalagent | AI 训练和索引 | 42,000 |
| facebookexternalhit | 分享时的链接预览 | 3,100 |
| Meta-ExternalFetcher | 按用户请求抓取 | 260 |
回报率 = 读取 ÷ 带回的真人访客。
用 robots.txt 控制
Meta 表示 Meta-ExternalAgent 遵守 robots.txt。屏蔽整个网站:
User-agent: meta-externalagent
Disallow: /
只屏蔽一部分:
User-agent: meta-externalagent
Disallow: /docs/
Disallow: /members/
想保留链接预览,就继续允许 facebookexternalhit。Meta 说明,代表用户请求的抓取和链接预览的检查,不一定按同样方式遵守 robots.txt。
如果某个爬虫不遵守你的规则,就在服务器、CDN 或防火墙上按验证过的 IP 段和用户代理屏蔽。robots.txt 是请求,不是强制手段。
在 TapCub 里看 Meta 的爬虫
- 网站统计 › 机器人 的「AI & agents」页签:「AI 内容账本」按运营商列出抓取次数(训练爬虫和答案引擎分列)、带回的真人访客和回报率(读取 ÷ 带回的访客)。
- 网站统计 › 机器人 的「All bots」页签:每个爬虫访问的页面、最常见的状态码和可信度(已验证、疑似、未验证)。
- 监测 › 爬虫合规:把真实抓取和你的 robots.txt 对比,列出违规,比如爬虫抓取了被禁止的路径;生成器可以起草「禁止训练爬虫」这类规则,由你发布到网站上。
不执行 JavaScript 的爬虫,只有开启服务端采集或导入日志后才看得到。相关阅读:GPTBot、ClaudeBot 和 AI 爬虫账本。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。