Bytespider 是字节跳动的爬虫,因为请求量大,是站长最常在日志里看到的机器人之一。本文讲清它是什么、怎么在自己的网站上衡量它的负载、怎么检查它是否遵守 robots.txt,以及什么时候该限流或屏蔽。
读完你会知道
- 做决定之前,先在自己的网站上量出 Bytespider 的请求数和占用的服务器时间
- 加上 robots.txt 规则后,过几天检查抓取情况,而不是默认它会遵守
- 规则被无视就在 CDN 或防火墙上强制执行,同时别误伤搜索爬虫
什么是 Bytespider
Bytespider 是字节跳动(TikTok 等应用背后的公司)运营的网络爬虫。据广泛报道,它在大规模收集网页内容,包括用于 AI 模型。它的用户代理里包含 Bytespider,常见的字符串类似:
Mozilla/5.0 (Linux; Android 5.0) AppleWebKit/537.36 (KHTML, like Gecko) Mobile Safari/537.36 (compatible; Bytespider; spider-feedback@bytedance.com)站长通常是在服务器负载突然升高、或者日志里满是它的时候发现它。好几家主机商和网站运营者公开反映过它请求量很大,也有人反映它没有一贯遵守自己的 robots.txt。做决定之前,先在自己的网站上量一量。
完整例子:一周的负载
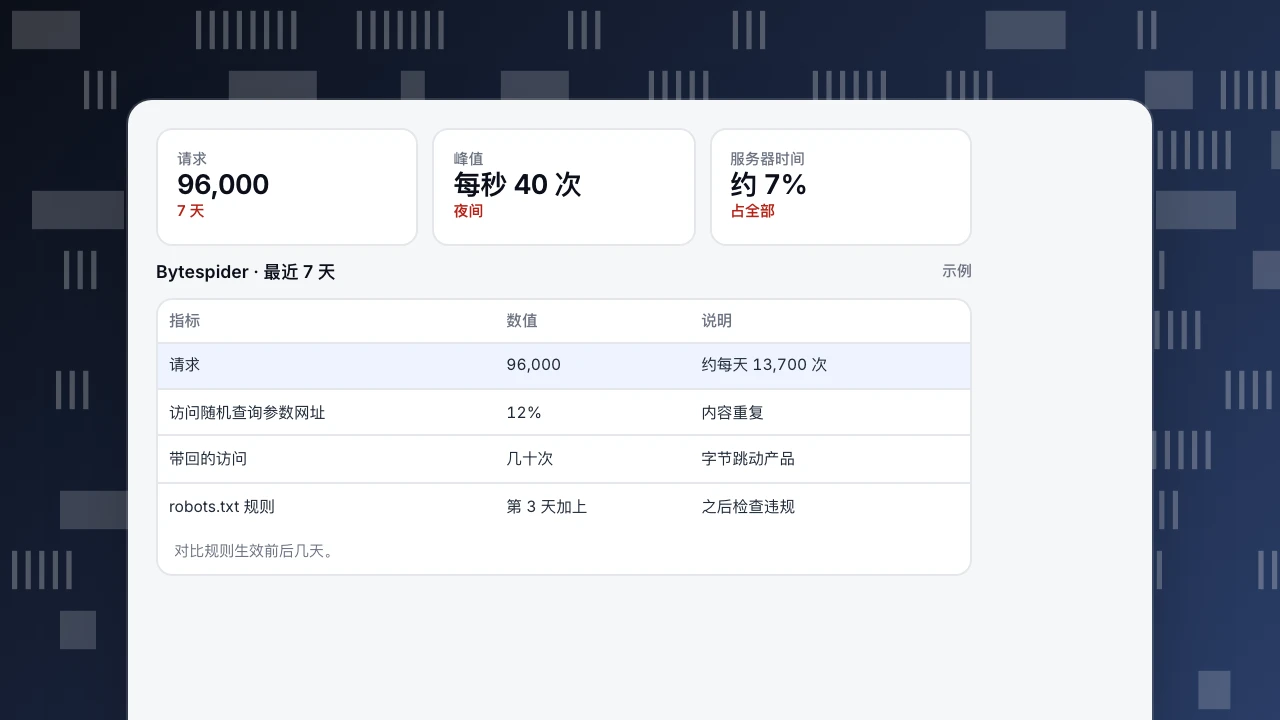
某内容网站 7 天的服务端数据(示例数字):
- Bytespider:96,000 次请求,夜间高峰每秒 40 次
- 占服务器时间:约占全部请求处理时间的 7%
- 白费的请求:12% 访问的是带随机查询参数、内容重复的网址
- 字节跳动产品带来的真人访问:几十次
第 3 天,网站加了一条 robots.txt 规则:
User-agent: Bytespider
Disallow: /然后去检查,不要想当然。对比规则生效前后几天的请求量,看有没有抓取被禁止的路径。几天之后(爬虫会定期重新读取 robots.txt)请求还是差不多,说明规则没有被遵守,需要在服务器上强制执行。
请求
96,000
7 天
峰值
每秒 40 次
夜间
服务器时间
约 7%
占全部
Bytespider · 最近 7 天
示例| 指标 | 数值 | 说明 |
|---|---|---|
| 请求 | 96,000 | 约每天 13,700 次 |
| 访问随机查询参数网址 | 12% | 内容重复 |
| 带回的访问 | 几十次 | 字节跳动产品 |
| robots.txt 规则 | 第 3 天加上 | 之后检查违规 |
对比规则生效前后几天。
可选的做法
下表从轻到重对比几种做法。
| 做法 | 怎么做 | 优点 | 局限 |
|---|---|---|---|
| robots.txt 规则 | User-agent: Bytespider / Disallow: / | 表明态度,零成本 | 只对遵守它的爬虫有效 |
| 修掉抓取陷阱 | 规范网址,屏蔽随机查询参数 | 对所有爬虫都减少白费的请求 | 不会减少正常的抓取 |
| 限流 | 在 CDN 或服务器上按用户代理限制每秒请求数 | 保护性能 | 需要调参 |
| 在 CDN 或防火墙屏蔽 | 按用户代理拒绝 | 强制执行,不管爬虫怎么做 | 挡不住隐藏身份的爬虫 |
| 基于行为的机器人防护 | CDN 的机器人管理 | 能识别伪装的机器人 | 有成本,可能误伤 |
先用 robots.txt 并测量;需要多重就升级到多重。
怎么选
- 读得多、但服务器扛得住:用 robots.txt 规则表明态度,盯着合规情况。
- 拖慢了网站:在 CDN 或网页服务器上限流,不管 robots.txt 怎么写。
- 无视你的规则:在 CDN 或防火墙上按用户代理屏蔽。很多 CDN 都有现成的 AI 爬虫开关。
- 把搜索爬虫隔开。不要写宽到能误伤 Googlebot 或 Bingbot 的规则;用 Bingbot 和 Googlebot 的验证方法核对防火墙规则。
按用户代理屏蔽,只能挡住自报家门的请求。隐藏身份的流量需要基于行为的机器人防护。
在 TapCub 里看 Bytespider
- 网站统计 › 机器人:在「All bots」页签看 Bytespider 的请求数、访问的页面、最常见的状态码和可信度;在「AI & agents」页签,「AI 内容账本」对比各运营商的读取量和带回的真人访客。
- 监测 › 爬虫合规:把抓取和你的规则文件对比,列出三种违规:被全局禁止仍抓取、抓了写明不允许的路径、抓取间隔短于声明的延迟。点开违规的一行,可以复制给服务器用的屏蔽代码。
- 不执行 JavaScript 的爬虫,只有开启服务端采集或导入日志后才看得到。
相关阅读:Meta-ExternalAgent、Google-Extended 和 AI 爬虫账本。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。