抓取错误是失败的搜索引擎请求。少量是正常的;一连串服务器错误,或重要页面上成片的 404,就不正常了。本文讲清类型、常见原因、修复顺序,并用一周的 Googlebot 数据走一遍。
读完你会知道
- 站点级错误(DNS、超时、robots.txt、连续 5xx)很紧急,会拖慢整个网站的抓取
- 把 404 按路径模式归组:一条跳转规则常常能修好几百个
- 用服务端抓取数据看搜索引擎实际请求了什么,而不只是爬虫工具找到了什么
什么是抓取错误
抓取错误是搜索引擎爬虫发出的请求没有拿到它想要的页面。爬虫可能得不到响应(DNS 失败、超时),拿到服务器错误(5xx)、「找不到」(404),或者一个不知道跳到哪去的跳转。
有些错误是正常的。每个网站都会因为旧链接有一些 404。要紧的是类型、数量,以及重要页面有没有受影响。
站点级错误和网址级错误
- 站点级错误让爬虫根本进不了网站:DNS 失败、服务器拒绝连接、超时,或者 robots.txt 返回错误。这类很紧急,因为搜索引擎看到它们会放慢对整个网站的抓取。robots.txt 返回 5xx 时,Google 会暂停抓取。
- 网址级错误只影响单个页面:404、软 404、401/403、跳转链和跳转循环。落在你希望被收录的页面上时最要紧。
主要类型和修复方法
下表列出常见类型、一般原因和修复方法。
| 类型 | 级别 | 一般原因 | 修复方法 |
|---|---|---|---|
| DNS 错误 | 站点 | 域名过期、DNS 服务商故障 | 检查 DNS 记录和服务商状态 |
| 超时 / 拒绝连接 | 站点 | 服务器过载、防火墙拦了爬虫 | 扩容,放行已验证的爬虫 |
| robots.txt 打不开(5xx) | 站点 | robots.txt 路由出错 | 把 robots.txt 作为静态文件返回 200 |
| 5xx 服务器错误 | 站点或网址 | 发版、崩溃、数据库慢 | 不停机发版,维护时返回 503 + Retry-After |
| 404 找不到 | 网址 | 页面删了或搬了、死链 | 有替代页就 301,没有就保持 404 |
| 软 404 | 网址 | 空页面却返回 200 | 返回 404/410,或补上真实内容 |
| 401/403 | 网址 | 登录墙、IP 封锁 | 公开页面保持公开,放行已验证的爬虫 |
| 跳转链或循环 | 网址 | 多层规则叠加(http、www、斜杠) | 链接和跳转直接指向最终网址 |
被 robots.txt 屏蔽是你的选择,不算错误;只有页面需要收录时才要检查。
完整例子:一周的 Googlebot 抓取
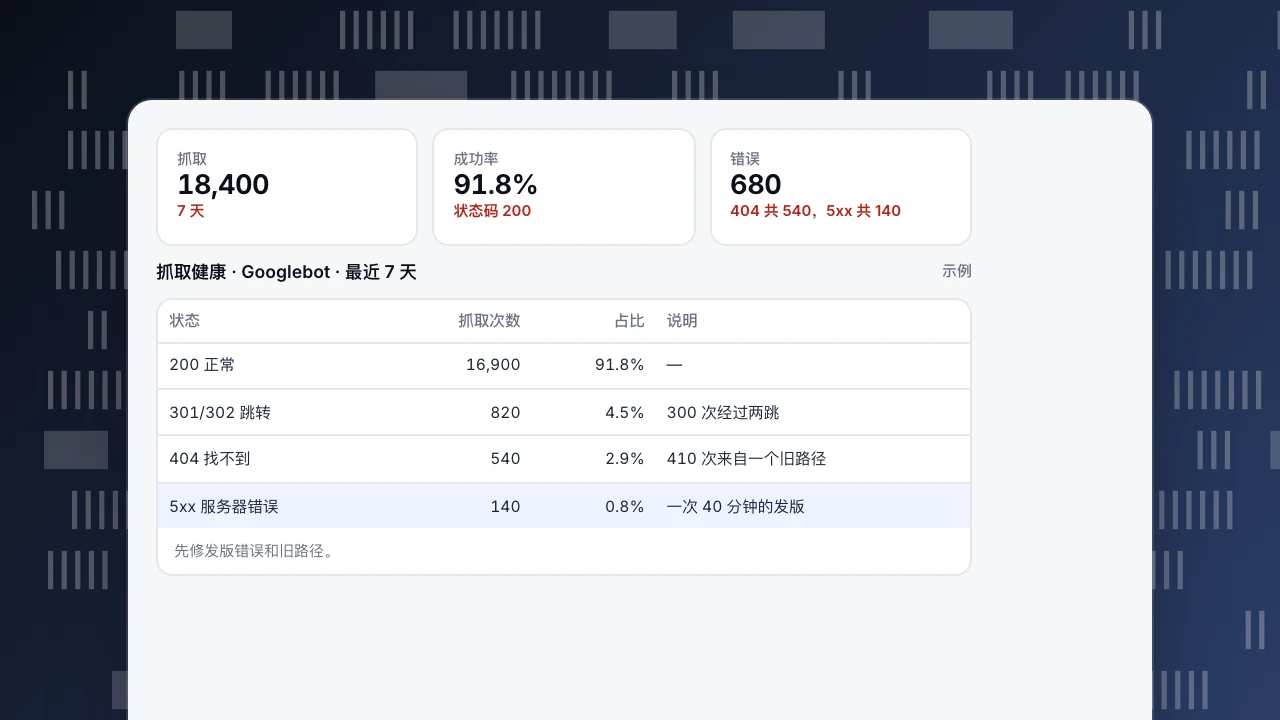
某网站 7 天的服务端数据(示例数字):
- Googlebot 抓取 18,400 次
- 返回 200 的 16,900 次(成功率 91.8%)
- 返回跳转(301/302)的 820 次
- 返回 404 的 540 次
- 返回 5xx 的 140 次
怎么读:
- 140 次服务器错误全部落在一次发版的 40 分钟里。这是发版问题,不是容量问题:改成不停机发版,或者维护期间返回 503 并带上 Retry-After。
- 540 次 404 里,有 410 次来自改版时删掉的一个旧分类路径。这些应该 301 到新分类。其余 130 次很分散,多是旧的错拼链接,保持 404 就行。
- 820 次跳转里有 300 次经过两跳(http → https → 末尾斜杠)。把站内链接和网站地图都改成最终网址。
修完之后,下一周成功率到 96%。Googlebot 的访问更多落在真实页面上,见抓取预算。
抓取
18,400
7 天
成功率
91.8%
状态码 200
错误
680
404 共 540,5xx 共 140
抓取健康 · Googlebot · 最近 7 天
示例| 状态 | 抓取次数 | 占比 | 说明 |
|---|---|---|---|
| 200 正常 | 16,900 | 91.8% | — |
| 301/302 跳转 | 820 | 4.5% | 300 次经过两跳 |
| 404 找不到 | 540 | 2.9% | 410 次来自一个旧路径 |
| 5xx 服务器错误 | 140 | 0.8% | 一次 40 分钟的发版 |
先修发版错误和旧路径。
先修什么
- 站点级错误(DNS、超时、robots.txt 失败、连续的 5xx)。
- 重要页面上的错误:网站地图里的、导航里链到的页面。
- 同一路径模式下的大量 404:一条跳转规则能修好很多。
- 站内链接和网站地图里的跳转链、跳转循环。
- 软 404:返回 200 的空搜索页、空分类页。
- 已删除内容的零散 404 不用管,404 就是正确的回应。
在哪里看抓取错误
- Google Search Console › 网页和抓取统计信息:显示 Google 报告的情况,有几天延迟。
- 服务器日志:实时记录每个请求,见SEO 日志分析。
- 网站爬虫工具:能找出死链和跳转链,但它显示的是爬虫工具看到的,不是搜索引擎实际请求的。
在 TapCub 里怎么看
监测 › 抓取健康 在服务端按搜索引擎统计抓取:抓取总数、成功率、不同页面数、404 和 5xx,以及网站地图里的新网址等多久才第一次被抓取。最近 24 小时的抓取低于 7 天平均的 30% 时,会发出「抓取异常」通知,这常常发生在一连串服务器错误之后。哪些爬虫是真的,在 网站统计 › 机器人 里看(已验证、疑似、未验证)。Google 爬虫怎么工作,见 Googlebot 和 Google 多久抓取一次。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。