CCBot 是 Common Crawl 的爬虫,它建起的免费公开数据集,是 GPT-3、LLaMA、BLOOM 训练语料中有论文出处的来源。屏蔽它只要一行 robots.txt,但影响的只是以后的快照:已发布的 WARC 文件和已训练好的模型都不会变。本文讲怎么核实、怎么屏蔽、怎么在自己的数据里检查。
读完你会知道
- CCBot 建的是 Common Crawl 免费公开数据集;GPT-3、LLaMA(英文 CommonCrawl 占 67%)、BLOOM(OSCAR 占 38%)的训练用途有论文出处
- Disallow: / 只影响以后的快照——已发布的 WARC 不可变,已训练的模型不受影响
- 用反向 DNS(*.crawl.commoncrawl.org)和 ccbot.json 前缀核实;屏蔽后 robots.txt 检查仍会继续
CCBot 是什么
CCBot 是 Common Crawl 的爬虫。Common Crawl 是一家 501(c)(3) 非营利机构,从 2008 年起持续建设免费、公开的网络档案。它的 User-Agent 是 CCBot/2.0 (https://commoncrawl.org/faq/)。它是一个为公开数据集服务的 AI 爬虫,不是搜索索引,也不是答案引擎:它抓来的页面会进入一个任何人都能免费下载的数据集;基金会表示每月新增数十亿页面(opt-out 登记处博文)。
这个用途决定了本文反复回到的一条边界:屏蔽 CCBot 影响的是以后的数据集,管不到已经发布的。
Common Crawl 和数据集
CCBot 跑在 Nutch 和 Hadoop 上(FAQ)。每次抓取以 WARC 文件(原始响应)加 WAT(元数据)、WET(提取文本)衍生物的形式发布,免费放在 S3 的 s3://commoncrawl/,可直接下载。快照按 CC-MAIN-YYYY-WW 命名,大约每 4–5 周发布一版;档案本身从 2008 年就开始积累(get-started)。它抓的是网络的随机子集,不是把你整站抓完(FAQ)。基金会表示这份档案已被一万多篇论文引用(opt-out 登记处博文)。
至于下游谁在用这份数据,下面三个模型的训练语料都有论文原文可查:
- GPT-3:训练数据里包含经过过滤、去重的 Common Crawl,做法写在论文的数据附录里(arXiv 2005.14165)。
- LLaMA:英文 CommonCrawl 占预训练数据的 67%,取自 2017–2020 年的五个 dump(arXiv 2302.13971)。
- BLOOM:ROOTS 语料的 38% 来自 OSCAR 21.09,而 OSCAR 21.09 派生自 2021 年 2 月的 Common Crawl 快照(arXiv 2211.05100)。
边界在这里很关键:已发布的 WARC 文件不可变,所以移除请求只作用于后续抓取,不会改写已发布的快照;对已有数据,Common Crawl 说会让被移除的地址在它的公开工具和索引里查不到(透明度博文,2025-11-04)。
| 对象 | 屏蔽 CCBot 之后 |
|---|---|
| 以后的抓取和 CC-MAIN 快照 | 排除——CCBot 先读 robots.txt,遵守 Disallow |
| 已发布的快照(如 CC-MAIN-2026-43) | 不变——WARC 文件不可变,移除只过滤后续抓取 |
| 已训练的模型(如用 2017–2020 年 dump) | 不受影响——训练数据在你的规则生效前就已固定 |
| AI 答案引擎的引用 | 无直接影响——CCBot 是数据集爬虫,不是答案引擎 |
边界依据 Common Crawl 透明度博文(2025-11-04)与 FAQ,2026-11-15 核对。
robots.txt 写法
CCBot 先读 robots.txt 再抓取,不执行 JavaScript、不用 Cookie,遵守 Crawl-delay,也尊重 nofollow(FAQ)。robots.txt 要放在每个主机各自的根目录下,子域名算独立主机:example.com 上的规则管不到 blog.example.com。想让页面不进以后的快照:
不想屏蔽、只想限速,就把 Disallow 那行换成 Crawl-delay: 2(请求间隔秒数)。屏蔽之后,有两件事要提前有预期:CCBot 仍会周期性检查 robots.txt,这类抓取会继续(FAQ);规则文件撤不回已抓走的内容——那要走 Common Crawl 的 opt-out 登记处,或联系 info@commoncrawl.org(opt-out 登记处博文)。
User-agent: CCBot
Disallow: /

# Slow it down instead of blocking:
# User-agent: CCBot
# Crawl-delay: 2
核实请求是不是真的 CCBot
User-Agent 可以随便伪造,Common Crawl 官方明确提醒有自称 CCBot 的假请求(CCBot 说明页)。用正向确认的反向 DNS(FCrDNS)核实:
host 18.97.14.84
# 84.14.97.18.in-addr.arpa domain name pointer 18-97-14-84.crawl.commoncrawl.org.
host 18-97-14-84.crawl.commoncrawl.org
# 18-97-14-84.crawl.commoncrawl.org has address 18.97.14.84
反向解析出的域名必须以 .crawl.commoncrawl.org 结尾,再正向解析回同一个 IP。不想敲命令的话,也可以直接把日志里的来源地址和 ccbot.json 公布的前缀列表对照(5 个前缀,creationTime 2026-08-11)。IPv6 地址没有反向 DNS,那里实际可行的就是查前缀列表。来自这些前缀之外的请求,无论 User-Agent 写什么,都不是 Common Crawl。
检查自己的数据
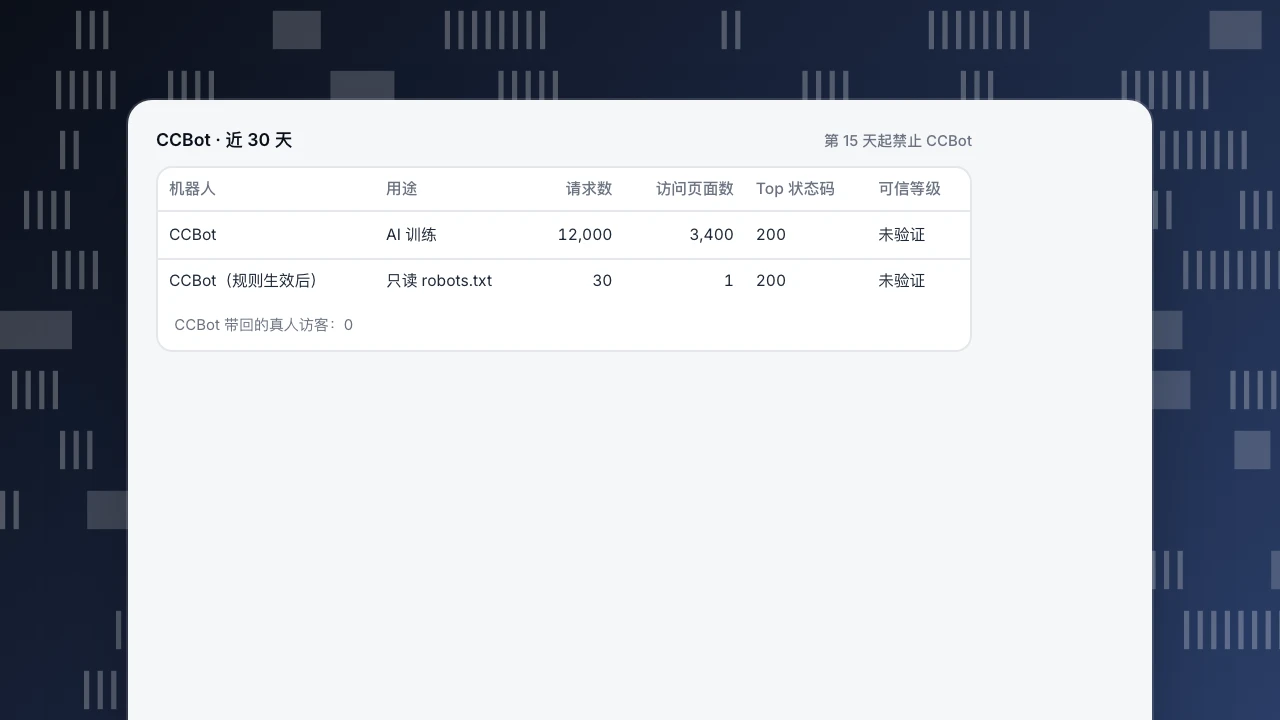
下面是一组示例数据,取自同一个 30 天窗口,每个数字都可以复算:CCBot 发起 12,000 次请求,覆盖 3,400 个不同页面,带回的真人访客是 0。12,000 ÷ 30 = 每天 400 次;读取与带回访客之比是 12,000 : 0——这是语料采集,不是流量来源。
第 15 天加上 Disallow: /,后半个月就变了:约 6,000 次页面抓取消失(400 × 15),只剩约 30 次 robots.txt 检查(每天 2 次 × 15 天)。剩下这些检查是预期行为,不是违规。看的时候把状态码和请求次数放在一起读:大多是 200,说明页面正在进入档案;一片 403,说明上游已经有东西在拦截。
CCBot 不执行 JavaScript,靠页面脚本的统计会少算它;完整数字要看服务器日志。
CCBot · 近 30 天
第 15 天起禁止 CCBot| 机器人 | 用途 | 请求数 | 访问页面数 | Top 状态码 | 可信等级 |
|---|---|---|---|---|---|
| CCBot | AI 训练 | 12,000 | 3,400 | 200 | 未验证 |
| CCBot(规则生效后) | 只读 robots.txt | 30 | 1 | 200 | 未验证 |
CCBot 带回的真人访客:0
按目标决定
- 内容不进以后的数据集:
Disallow: /。这一行会覆盖以后所有快照,以及这些快照的下游使用者。 - 留在公开档案里:允许(默认就是)。即便如此,也只抓你页面的随机子集。
- 不退出、只降负载:
Crawl-delay: 2。 - 移除已抓走的内容:robots.txt 做不到,走 opt-out 登记处。
- 保住 AI 答案里的引用:CCBot 不是答案爬虫,屏蔽它对引用没有直接影响——那条线走的是 PerplexityBot、OpenAI 的 OAI-SearchBot(见 GPTBot)这类答案引擎爬虫。谷歌单独管 AI 用途的 token 是 Google-Extended。
把屏蔽放进时间线,边界就更具体了。2026-11-15 屏蔽:已发布的 CC-MAIN-2026-43 快照不变(WARC 不可变);下一版快照大约在 4–5 周后(示意编号 CC-MAIN-2026-47),不再包含你的网站;用 2017–2020 年 dump 训练的模型不受影响。屏蔽改变的是接下来抓什么,不是已经发布了什么。
TapCub 里的 CCBot
把上面那个示例月放进 TapCub 走一遍:
- 先接服务端记录。 CCBot 不执行 JavaScript,页面脚本永远看不到它。用服务端上报访问记录,或通过接口导入访问日志(见 机器人与 AI 爬虫);不接的话,CCBot 这一行是空的。默认情况下,已识别的机器人不进真人访客和转化数字。
- 看账本。 在 网站统计 › 机器人 的「AI 与智能体」页签里有「AI 内容账本」。Common Crawl 在训练列:读取 12,000 次,带回访客 0,标为「无回访」。训练爬虫和答案引擎分列统计,CCBot 一眼就是只读不带人。同一页签的「Top 被读页面」能看出 3,400 个页面里它读得最多的是哪些。
- 核对这一行。 在「全部机器人」页签,CCBot 的运营商是 Common Crawl,用途「AI 训练」,另有请求数、访问页面数、Top 状态码、最后发现、可信等级和命中检测层。TapCub 对 CCBot 不做 DNS 校验,所以真假请求的可信等级都显示「未验证」;要分开,用上文的反向 DNS 或 ccbot.json 核对。认错了可以点「报告误判」。
- 屏蔽后查合规。 监测 › 爬虫合规 页的「规则文件生成器」有「禁止所有 AI 训练爬虫」选项,名单里有 CCBot。发布 Disallow 两周后,这一页不应再列出被禁止后仍抓取的记录;「全部机器人」里 CCBot 那一行应该只剩 robots.txt 检查。如果来自 ccbot.json 地址段的请求还在抓页面,那才是真违规。
TapCub 不做的事:它只衡量,不替你屏蔽爬虫,也没法把你的内容从 Common Crawl 已发布的数据集、或已经用这些数据训练好的模型里删掉。
常见问题
CCBot 是什么?
Common Crawl 的爬虫。Common Crawl 是 501(c)(3) 非营利机构,2008 年起发布免费网络档案;CCBot 为这个数据集抓页面,不是为搜索索引。User-Agent 是 CCBot/2.0 (https://commoncrawl.org/faq/)。数据集可以免费下载和复用。
怎么屏蔽 CCBot?
在每个主机根目录的 robots.txt 里加 User-agent: CCBot 和 Disallow: /。CCBot 抓取前先读这个文件,之后还会周期性检查,所以 robots.txt 请求会继续,页面抓取停止。不想屏蔽、只想限速,就用 Crawl-delay: 2。
CCBot 遵守 robots.txt 吗?
遵守。Common Crawl 的 FAQ 写明:先读 robots.txt、遵守 Crawl-delay、尊重 nofollow,不执行 JavaScript、不用 Cookie。屏蔽之后它仍会继续检查 robots.txt。在自己的日志里确认:屏蔽后应当只剩 robots.txt 抓取。
CCBot 抓的数据被用于 AI 训练吗?
CCBot 建的是数据集;训练用途有论文可查:GPT-3 的数据附录写了 Common Crawl 的过滤做法;LLaMA 报告英文 CommonCrawl 占 67%,来自 2017–2020 年五个 dump;BLOOM 的 ROOTS 语料 38% 是 OSCAR 21.09,来自 2021 年 2 月快照。这三个数字都出自论文自己的描述。
屏蔽 CCBot 能把我的内容从已训练的模型里删掉吗?
不能。按 Common Crawl 透明度博文的说法,已发布的 WARC 文件不可变,移除请求只过滤后续抓取。用早期 dump 训练的模型保留它学到的东西;你的 Disallow 只影响以后的收集。对已抓走的数据,走 Common Crawl 的 opt-out 登记处。
怎么核实一个 CCBot 请求?
做正向确认的反向 DNS:IP 反向解析出以 .crawl.commoncrawl.org 结尾的域名,再正向解析回同一 IP;或者对照 ccbot.json 的前缀。只有 CCBot 的 User-Agent 说明不了什么。IPv6 没有反向 DNS,那里就查前缀列表。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
