PerplexityBot 是 Perplexity 的答案引擎爬虫:它读取网页,让 Perplexity 搜索能展示并链接你的网站;官方说明它不用于抓取 AI 基础模型的训练内容。屏蔽它,你就在 Perplexity 答案里少一个可能被引用的来源——放不放行,用「读了多少 vs 带回多少访客」来算。
读完你会知道
- PerplexityBot 是答案引擎爬虫,不是训练爬虫——屏蔽它,就在 Perplexity 答案里少一个可能被引用的来源
- Perplexity-User 按用户请求抓页,一般不遵守 robots.txt;两个代理设置互相独立,改动最长 24 小时生效
- 用自己的数据决定:带回访客 ÷ 读取量(示例:120 ÷ 8,000 = 1.5%);连续 2–3 个月≈0 才是屏蔽的信号
PerplexityBot 是什么
PerplexityBot 是 Perplexity 用来在它的 AI 答案引擎搜索结果里展示并链接网站的爬虫。Perplexity 官方文档写明,它「不用于抓取 AI 基础模型的内容」:它读取网页,是为了让答案能引用这些页面,而不是为了积累训练语料(见 Perplexity 爬虫说明,2026-11-15 核对)。它的 User-Agent 是 Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)。
这个用途,正是「放不放行」这件事值得算一算的原因。屏蔽 PerplexityBot,你的页面就不再被读取用于生成答案,于是你在 Perplexity 里少了一个可能被引用的来源。这笔交易划不划算,你自己的日志就能回答:它读了多少页,又带回了多少访客。
Perplexity 的两个代理
Perplexity 官方列出了两个代理,各自有独立的 robots.txt 设置;改一个不会影响另一个,改动最长 24 小时生效(见官方文档)。
- PerplexityBot 是自动抓取的答案引擎爬虫。它让网站出现在 Perplexity 搜索结果里并被链接,官方说明它不用于抓取 AI 基础模型内容。它遵守 robots.txt。
- Perplexity-User 在用户向 Perplexity 提问时抓取网页,并可能在回答里附上该页链接。它不做自动抓取,也不收集训练内容;Perplexity 表示它一般不遵守 robots.txt。它的 User-Agent 标识为
Perplexity-User/1.0。
所以「屏蔽 Perplexity」其实是两个决定:一个针对爬虫的 rules 文件分组,以及——如果你还想限制用户发起的抓取——服务器上的访问控制。本节后面的表格把两者放在一起对比。
| 代理 | 做什么 | robots.txt |
|---|---|---|
| PerplexityBot | 抓取以便在 Perplexity 搜索结果中展示并链接网站;官方说明不用于抓取 AI 基础模型内容 | ✓ 遵守 robots.txt;可允许或禁止 |
| Perplexity-User | 用户提问时抓取网页,可能在回答里附上链接;不做自动抓取,也不收集训练内容 | ~ 一般不遵守 robots.txt |
来源:Perplexity 爬虫官方文档,2026-11-15 核对。各项设置互相独立,改动最长 24 小时生效。
robots.txt 写法
每个代理单独写一组。默认情况——没有任何规则——就是允许 PerplexityBot;如果你希望页面有资格成为 Perplexity 答案的来源,这正是你要的。想退出,就禁止它;本节后面的代码块给出两种写法。
官方文档里有两点要注意。其一,各项设置互相独立,改动最长 24 小时才生效,所以别拿改完后一小时的日志下结论。其二,Perplexity-User 一般不遵守 robots.txt;要限制它,得靠服务器上的访问控制,而不是规则文件。
如果你用了 WAF 或机器人防护,光在 robots.txt 里放行还不够——见下面的核实一节。同样的「允许或退出」写法也适用于 GPTBot、ClaudeBot 这类训练爬虫,但它们的用途是训练而非答案,所以下面那笔账对它们会算出不同的结果。
User-agent: PerplexityBot
Allow: /

# To opt out, use this group instead:
# User-agent: PerplexityBot
# Disallow: /
核实请求是不是真的 PerplexityBot
User-Agent 可以伪造。Perplexity 把每个代理的 IP 段公布成 JSON 文件,并说明以这些文件为准、定期更新:perplexitybot.json(2026-11-15 核对时为 13 个 IPv4 /32 段)和 perplexity-user.json(10 个段)。把请求的来源 IP,和它 User-Agent 所写代理对应的文件对照;来自列表之外地址、却自称「PerplexityBot」的请求,不是 Perplexity 的。和 Applebot 不同,Perplexity 没有公布反向 DNS 验证方法——User-Agent 加公布的 IP,就是官方给出的核实方式。
如果你用 WAF,要把公布的 IP 和 User-Agent 一起加入放行名单;Perplexity 的指引覆盖了 Cloudflare WAF,以及带 UA 匹配的 AWS WAF IP 集。注意:Cloudflare 的 Bot Fight Mode 即便在 robots.txt 放行时,也可能拦截合法的 PerplexityBot 流量,而 Perplexity 文档指出它无法用自定义规则跳过。
看自己的数据:读了多少 vs 带回多少
放不放行,本质是一道算术题:爬虫读了多少页,又有多少真人访客是从引用了你的 Perplexity 答案里点过来的?带回的访客,是点了答案里引用链接的真人——要把他们和爬虫读取分开计。
示例数据,一个月:
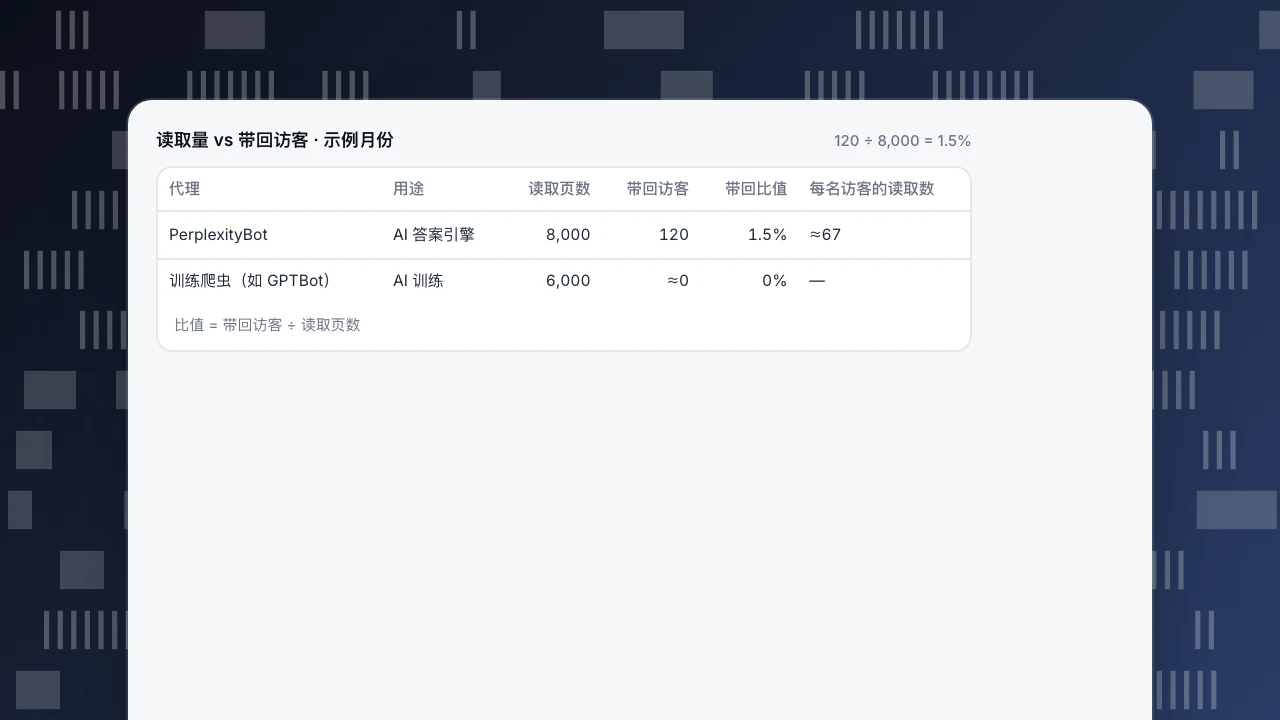
- PerplexityBot 读取 8,000 页,带回 120 名访客。比值 = 120 ÷ 8,000 = 1.5%;每名访客的读取成本 = 8,000 ÷ 120 ≈ 67 次。
- 某训练爬虫(比如 GPTBot)读取 6,000 页,带回访客 ≈ 0。比值 = 0 ÷ 6,000 = 0%。
答案引擎的读取,可能换来引用和回流;训练爬虫的读取则几乎不带回任何访客。不执行 JavaScript 的爬虫不会触发页面脚本,只靠脚本的统计工具可能少算读取量,完整数字得靠服务器日志。本节后面的表格把两者并排放在一起。
读取量 vs 带回访客 · 示例月份
120 ÷ 8,000 = 1.5%| 代理 | 用途 | 读取页数 | 带回访客 | 带回比值 | 每名访客的读取数 |
|---|---|---|---|---|---|
| PerplexityBot | AI 答案引擎 | 8,000 | 120 | 1.5% | ≈67 |
| 训练爬虫(如 GPTBot) | AI 训练 | 6,000 | ≈0 | 0% | — |
比值 = 带回访客 ÷ 读取页数
按目标决定
- 想被 Perplexity 答案引用,且比值持续大于零:允许 PerplexityBot。读取是被引用的成本;例子里的 1.5% 意味着大约 67 次读取换 1 名访客,对一个还能带来可见度的回流渠道来说,这个价格不高。
- 连续 2–3 个月比值≈0,且你不愿内容被使用:可以禁止它,但要接受代价——在 Perplexity 答案里少一个可能被引用的来源。
- 训练爬虫:它们的带回比值本来就≈0,所以该按你是否同意训练使用来决定,而不是按流量账。
- 服务器负载:在服务器上限流,而不是屏蔽一个会带回访客的爬虫。
无论怎么选,规则文件只是表达你的意愿;要确认它有没有被遵守,就得检查实际抓取。相关内容:AI 爬虫台账、AI 可见度和 AI 爬虫。
TapCub 里的 PerplexityBot
上面那笔账,8,000 次读取换 120 个访客,正是 TapCub 机器人报表在记的账。按步骤走一遍:
- 把读取收全。 只装页面脚本时,TapCub 只能看到会执行 JavaScript 的机器人。要把 PerplexityBot 的每次读取都计进来,用服务端上报访问记录,或通过接口导入访问日志(见 机器人与 AI 爬虫)。默认情况下,已识别的机器人不进访客、会话和转化的真人数字。
- 看账本。 在 网站统计 › 机器人 的「AI 与智能体」页签里有「AI 内容账本」:按运营商列出抓取次数(训练爬虫和答案引擎分列)、引流回访 UV,以及「回报率(N 次读取 : 1 访客)」。示例里 Perplexity 这一行是答案引擎读取 8,000 次、带回 120 人,约 67 : 1。这一列也算上了 Perplexity-User 的抓取;在「全部机器人」页签里,PerplexityBot(用途「AI 答案引擎」)和 Perplexity-User(「AI Agent」)是两行,能看出 8,000 里有多少是爬虫读的。
- 换到可见性视角。 「AI 可见性」页签反过来除:「抓取→访问比」= AI 带来的访问 ÷ AI 爬取,示例里是 1.5%。「按 AI 品牌」表按品牌重复这笔账,「被引用页面」列出被 AI 助手带来访问的落地页,能看出是哪几篇文章在换来点击。
- 对照训练爬虫那一行。 GPTBot 这类训练爬虫在训练列,读取 6,000 次、带回约 0 人。Perplexity 这一行的读取换来了访客,对应上文判断清单里「放行」那一种。
- 改完要复查。 如果禁止了 PerplexityBot,等 24 小时,再打开 监测 › 爬虫合规:它会列出被全局禁止仍抓取、抓了写明不允许的路径这类违规。TapCub 对 Perplexity 不做 DNS 校验,可信等级显示「未验证」;来源 IP 要自己对照 perplexitybot.json。
TapCub 不做的事:不替你屏蔽爬虫,也不替你发布 robots.txt;它说不出哪条 Perplexity 答案引用了你的页面,也不能保证会被引用。带回的访问指来源是 AI 助手的真人会话,不是引用次数。
常见问题
PerplexityBot 是什么?
Perplexity 的答案引擎爬虫。它读取网页,让 Perplexity 搜索能在答案里展示并链接你的网站;官方文档说明它不用于抓取 AI 基础模型内容。它是 Perplexity 两个代理之一,各自有独立的 robots.txt 设置。
怎么屏蔽 PerplexityBot?
在每个主机根目录的 robots.txt 里,加一组 User-agent: PerplexityBot 和 Disallow: /。改动最长 24 小时生效。Perplexity-User 一般不遵守 robots.txt,所以要限制用户发起的抓取,得靠服务器上的访问控制。
屏蔽 PerplexityBot,会让我的网站从 Perplexity 答案里消失吗?
它会让你少一个可能被引用的来源:PerplexityBot 再也读不到你的页面,无法在答案里展示并链接它们。Perplexity-User 仍可能在用户问起时抓取页面并在回答里附链接,所以引用并非完全不可能——但你已经退出了让页面有资格被引用的自动读取。
Perplexity-User 遵守 robots.txt 吗?
Perplexity 文档表示,Perplexity-User 一般不遵守 robots.txt,因为它的抓取由用户提问发起。如果确实需要限制它,要用服务器上的访问控制,而不是规则文件,并按 perplexity-user.json 核实请求。
PerplexityBot 会被用来训练 AI 模型吗?
不会。Perplexity 文档写明,PerplexityBot 不用于抓取 AI 基础模型内容;它的用途是在 Perplexity 搜索结果里展示并链接网站。GPTBot 这类训练爬虫是另一类,用途不同,放不放行的算法也不同。
robots.txt 改动多久生效?
Perplexity 表示,每个代理的设置互相独立,改动最长 24 小时生效。改完文件后,隔一天再看日志判断规则是否起作用,并按公布的 IP 文件核实抓取。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
