Applebot 是苹果给 Spotlight、Siri 和 Safari 搜索抓内容的爬虫;Applebot-Extended 只是 robots.txt 里的 AI 训练开关。屏蔽错了,会把搜索一起关掉。本文讲两个代理各做什么、三种规则写法、怎么核实请求,以及一个能复算的损失算例。
读完你会知道
- Applebot 为 Spotlight、Siri、Safari 搜索抓取;Applebot-Extended 从不抓取,只决定 Applebot 抓到的数据能不能用于训练苹果的 AI 模型
- 禁止 Applebot-Extended 即可退出训练、保留苹果搜索;直接禁止 Applebot,会让它带回的访问承压
- 用 *.applebot.apple.com 反向 DNS 加正向解析核实,或对照苹果的 CIDR JSON;留意 Googlebot 回退规则会悄悄屏蔽 Applebot
Applebot 是什么
Applebot 是苹果的网页爬虫。它抓取的数据为 Spotlight、Siri 和 Safari 里的搜索提供内容;苹果同时说明,同一批抓取数据也可能用于训练苹果基础模型(Apple Intelligence、Services、Developer Tools 里的生成式 AI 功能),并为 AI 生成的回答提供上下文(About Applebot,2026-09-04 发布,2026-11-15 核对)。
这个名字其实对应两样东西。Applebot 是你在日志里看到的爬虫;Applebot-Extended 不是爬虫,它只是 robots.txt 里的一个 token,决定 Applebot 抓到的数据能不能拿去训练 AI。多数站长要拨的是 Extended 这个开关。直接禁止 Applebot,会关掉给苹果搜索供内容的抓取——屏蔽错了,损失的是 Applebot 带回的访问;只屏蔽训练,则一次访问都不损失。
苹果的两个代理
按苹果官方文档:
- Applebot(搜索):为 Spotlight、Siri 和 Safari 搜索抓取页面,也可能渲染页面。在 robots.txt 里允许它,内容才能出现在这些搜索结果里。
- Applebot-Extended:不抓取网页。它只决定 Applebot 抓到的数据可以怎么用——具体来说,能不能用于训练苹果的生成式基础模型。禁止 Extended 的页面仍然可以出现在搜索结果里;苹果明确说明,Applebot-Extended 的站点规则不参与搜索排名。
- iTMS(Apple Podcasts):只抓取在 Apple Podcasts 登记过的 URL,不遵守 robots.txt。
Google 的 Google-Extended 也是同样的「纯 token」模式:一个管数据用途的 robots.txt 名字,而不是一个独立的爬虫。所以无论加不加规则,你的日志里都不会出现 Applebot-Extended 的请求——它的作用是给已抓取数据打用途标记,不是流量。
| 代理 | 做什么 | robots.txt 效果 |
|---|---|---|
| Applebot | 为 Spotlight、Siri、Safari 搜索抓取(也可能渲染);抓到的数据也可能用于训练苹果基础模型、驱动 AI 回答 | Disallow 会停掉抓取 → 内容失去苹果搜索可见度 |
| Applebot-Extended | 不抓取;决定 Applebot 抓到的数据能否用于训练苹果基础模型的 token | Disallow = 退出训练;搜索保留;不参与搜索排名 |
| iTMS(Apple Podcasts) | 只抓取在 Apple Podcasts 登记的 URL | 不遵守 robots.txt |
来源:苹果《About Applebot》,2026-09-04 发布,2026-11-15 核对。两个 token 互相独立。
robots.txt 写法:三种选择
每个 token 单独写一组。三种目标,三套规则(本节后面附可直接复制的版本):
- 只屏蔽训练,保留苹果搜索:
User-agent: Applebot-Extended加Disallow: /。Applebot 继续抓取,Siri、Spotlight、Safari 的可见度不变。 - 屏蔽全部苹果抓取:
User-agent: Applebot加Disallow: /。这会停掉给苹果搜索供内容的抓取,是让搜索可见度承压的选择。 - 全部放行:两个 token 都不写——默认状态。
三个有官方文档依据的坑:
- Googlebot 回退。 如果 robots.txt 里写了 Googlebot 却没写 Applebot,Applebot 会照 Googlebot 的规则执行。一条为 Googlebot 写的 Disallow,可能在不点名 Applebot 的情况下悄悄关掉苹果搜索。
- 不支持 crawl-delay。 Applebot 不遵守 crawl-delay;网站变慢或返回错误时,它会自动调整抓取速率。
- 渲染。 Applebot 可能在浏览器里渲染页面。屏蔽页面需要的 JS、CSS、XHR 资源会破坏渲染——这些资源要保持可访问。
训练和 AI 回答是两个开关:nosnippet(meta 标签或 X-Robots-Tag: applebot: nosnippet)退出 AI 生成的回答和摘要;Extended 退出训练。两者可以叠加——和 GPTBot 与 OAI-SearchBot 的训练/搜索分工是同一回事。
# Option 1 - block training only, keep Siri / Spotlight / Safari (active)
User-agent: Applebot-Extended
Disallow: /

# Option 2 - block all Apple crawling (also turns off Apple search)
# User-agent: Applebot
# Disallow: /

# Option 3 - allow all: leave both tokens unlisted (default)
核实请求是不是真的 Applebot
User-Agent 可以伪造。苹果文档给了两种核实方法:
- 反向 DNS,再正向确认。 主机名必须以
.applebot.apple.com结尾,再把这个主机名正向解析,必须回到同一个 IP。苹果自己的示例:
$ host 17.58.101.179
179.101.58.17.in-addr.arpa domain name pointer 17-58-101-179.applebot.apple.com.
$ host 17-58-101-179.applebot.apple.com
17-58-101-179.applebot.apple.com has address 17.58.101.179.- CIDR 对照。 苹果把 IP 段公布在 search.developer.apple.com/applebot.json:24 个 IPv4 前缀,全部在 17.x 段,creationTime 2026-09-15(2026-11-15 核对)。把每条请求的来源 IP 和这份清单对照。
搜索用的 User-Agent 看起来像 Safari 加一个 Applebot 后缀,桌面示例:
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.4 Safari/605.1.15 (Applebot/0.1; +http://www.apple.com/go/applebot)
移动端把设备换成 iPhone; CPU iPhone OS 17_4_1 like Mac OS X,并加上 Mobile/15E148。苹果会不定期更新 UA 里对外声明的浏览器版本号,所以认 Applebot/ 这个 token,用 DNS 或 IP 核实,别认版本号。
检查自己的数据
改规则之前,先数清楚 Applebot 抓了多少、带回多少。示例数据,30 天窗口,服务器日志导入:
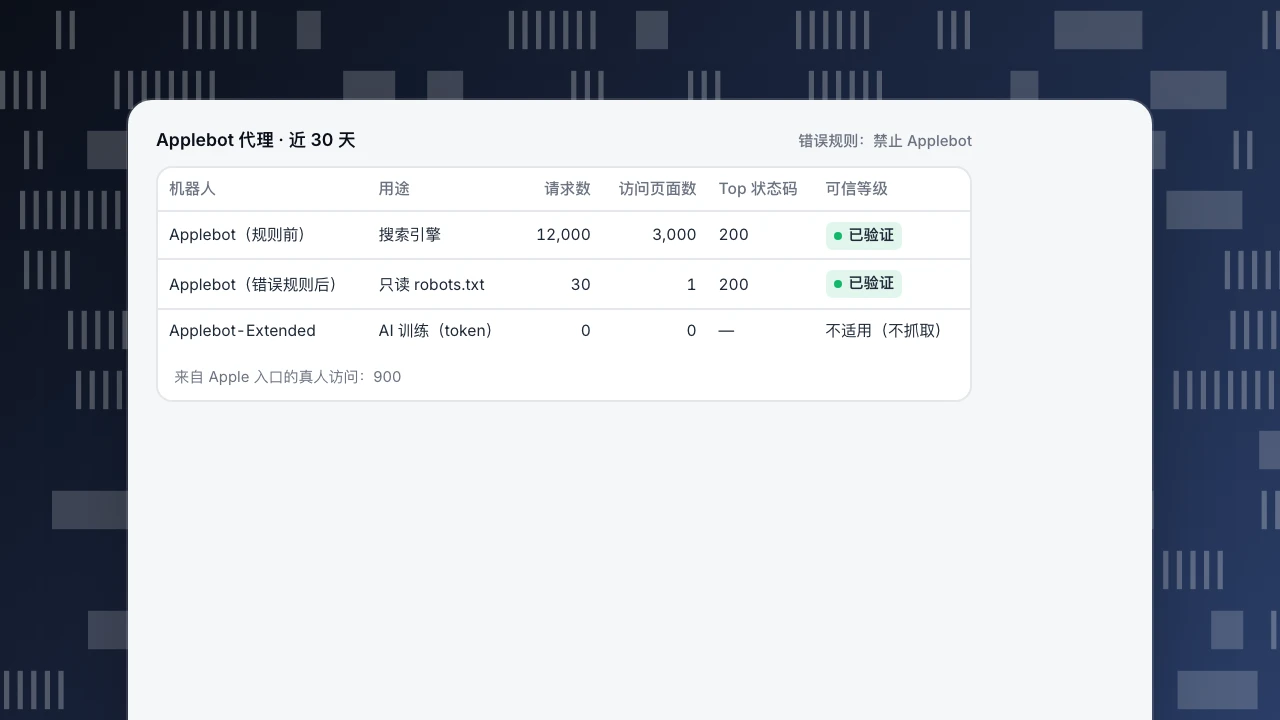
- 已验证的 Applebot:12,000 次请求,覆盖 3,000 个页面,主要状态码 200。
- 来自 Apple 入口(Siri / Spotlight / Safari)的真人访问:900。
- 读取带回比:900 ÷ 12,000 = 7.5%,即每 1,000 次搜索读取带回 75 次访问。
- 按 2.0% 的目标转化率:900 × 2.0% = 每月 18 次转化。
- Applebot-Extended:0 次请求——它从不抓取。
对比两条规则:
- 屏蔽错了(对 Applebot 写
Disallow: /)。 Applebot 仍会读 robots.txt,大约每天一次:1 × 30 = 30 次请求、1 个页面,不再有新的内容抓取。900 次访问和 18 次转化承压——这是 Apple 入口流量全部损失时的上限。苹果没有公布索引衰减的时间表,这里也不假设任何时间表。 - 屏蔽对了(对 Applebot-Extended 写
Disallow: /)。 Applebot 保持 12,000 次请求 / 3,000 个页面;访问保持 900;转化保持 18。Extended 的请求在规则前后都是 0,所以验收看的是规则在不在 robots.txt 里,不是流量有没有掉。 - Googlebot 回退陷阱。 robots.txt 里禁止 Googlebot 却不提 Applebot,会悄悄复现同样的 12,000 → 30 崩塌。
完整计数要靠服务器日志:页面脚本统计只能看到执行 JavaScript 的那部分抓取。
Applebot 代理 · 近 30 天
错误规则:禁止 Applebot| 机器人 | 用途 | 请求数 | 访问页面数 | Top 状态码 | 可信等级 |
|---|---|---|---|---|---|
| Applebot(规则前) | 搜索引擎 | 12,000 | 3,000 | 200 | 已验证 |
| Applebot(错误规则后) | 只读 robots.txt | 30 | 1 | 200 | 已验证 |
| Applebot-Extended | AI 训练(token) | 0 | 0 | — | 不适用(不抓取) |
来自 Apple 入口的真人访问:900
按目标决定
| 目标 | 规则 | 保住什么 / 损失什么 |
|---|---|---|
| 不进 AI 训练,留在苹果搜索里 | Applebot-Extended + Disallow: / | 搜索可见度不变;示例里 900 次访问、18 次转化保住 |
| 苹果入口可见度尽量高 | 两个 token 都不写规则 | 关键页面保持返回 200、可渲染 |
| 完全退出苹果搜索 | Applebot + Disallow: / | 示例里每月 900 次访问、18 次转化承压 |
| 不进 AI 回答,但仍被收录 | nosnippet meta 或 X-Robots-Tag: applebot: nosnippet | 仍可搜索;建议只显示标题 |
| 付费墙页面可搜索、不进 AI 上下文 | JSON-LD isAccessibleForFree: false | 可进搜索,不作 AI 回答上下文;不支持 hasPart 分段标记 |
| 降低服务器负载 | 不支持 crawl-delay;出错时自动调速 | 规则保持简单;必要时在服务器限流 |
上面示例里,屏蔽错了会让每月 900 次访问、18 次转化承压;只屏蔽训练的规则,一次访问都不损失——你要拨的开关是 Extended,不是 Applebot。拿不准某个爬虫属于哪一类?先查 AI 爬虫术语表。规则只是表达意愿;它有没有被遵守,要看实际抓取。
TapCub 里的 Applebot
动 robots.txt 之前,先在 TapCub 里把上面的例子走一遍:Applebot 抓得正不正常,规则有没有打中对的 token?
- 接上服务端记录。 只装页面脚本时,TapCub 只能看到会执行 JavaScript 的机器人。用服务端上报访问记录,或通过接口导入访问日志,Applebot 的 12,000 次请求才能全部计入(见 机器人与 AI 爬虫)。默认情况下,已识别的机器人不进真人访客数和转化率的分母。
- 找到对的那一行。 在 网站统计 › 机器人 打开「全部机器人」页签。Applebot 这一行运营商是 Apple,用途「搜索引擎」。对服务端记录,TapCub 做的就是上文那套校验:反向 DNS 到 applebot.apple.com,再正向解析回原 IP;通过时可信等级显示「已验证」,不通过显示「疑似」。Applebot-Extended 也在 TapCub 的名单里,用途「AI 训练」,但它从不抓取,所以这个名字下不会有请求。
- 盯住搜索这一头。 Applebot 是搜索引擎,所以会出现在「全部机器人」里的搜索引擎抓取健康小表和 监测 › 抓取健康 里:抓取次数、成功率、404 和 5xx。示例里是 12,000 次抓取,状态码 200。
- 发布只拦 Extended 的规则,再查打中的是哪个 token。 监测 › 爬虫合规 页的「规则文件生成器」有一个「禁止所有 AI 训练爬虫」选项,它的名单里有 Applebot-Extended,不含 Applebot。发布之后,Applebot 在「全部机器人」和抓取健康里应该仍在 12,000 次左右。如果掉到只剩约 30 次 robots.txt 请求,说明拦到了 Applebot 本身,或者踩了 Googlebot 回退规则:恢复 Applebot,只禁止 Applebot-Extended。爬虫合规页也会列出在路径被禁止期间仍发生的抓取。
TapCub 不做的事:它负责衡量和核对,不改 robots.txt,也影响不了排名。Siri、Spotlight 带来的访问不会单独列成一个来源,例子里 900 次访问那一头要靠你自己按引荐来源和落地页分析。苹果没有站长后台,监测 › 搜索表现 只能连 Google Search Console 或 Bing Webmaster,所以看 Applebot 靠的是服务端记录加机器人报表。
常见问题
Applebot 是什么?
苹果的网页爬虫。它抓取页面、也可能渲染页面,为 Spotlight、Siri 和 Safari 里的搜索提供内容。苹果说明,同一批数据也可能用于训练基础模型、为 AI 回答提供上下文;每种用途都有各自的控制开关。
Applebot 和 Applebot-Extended 有什么区别?
Applebot 负责为搜索抓取。Applebot-Extended 从不抓取网页——它是 robots.txt 里的一个 token,决定 Applebot 抓到的数据能不能用于训练苹果的生成式 AI 基础模型。禁止 Extended,页面仍然有资格出现在苹果搜索结果里。
屏蔽 Applebot 会让我的网站从 Siri 和 Spotlight 里消失吗?
它会停掉给这些入口供内容的抓取。苹果说明,在 robots.txt 里允许 Applebot,内容才能出现在 Spotlight、Siri 和 Safari 搜索里,所以一刀切禁止 Applebot 会让这份可见度承压。只想退出训练,就改为禁止 Applebot-Extended。
Applebot 遵守 robots.txt 吗?
一般搜索抓取遵守,但有两个写进文档的例外:robots.txt 里写了 Googlebot 却没写 Applebot 时,Applebot 照 Googlebot 的规则执行;另外 Applebot 不遵守 crawl-delay。Apple Podcasts 用的 iTMS 是另一个 User-Agent,不遵守 robots.txt。
怎么核实一条请求是不是真的 Applebot?
对来源 IP 做反向 DNS:主机名必须以 .applebot.apple.com 结尾。再把这个主机名正向解析,确认回到同一个 IP。也可以把 IP 和苹果公布的 CIDR 清单 search.developer.apple.com/applebot.json 对照。只有 User-Agent 对得上,不算证据。
屏蔽 Applebot-Extended 会影响苹果搜索排名吗?
不会。苹果明确说明,Applebot-Extended 的站点规则不参与搜索排名,禁止 Extended 的页面仍可被收录进搜索结果。这个 token 只决定 Applebot 抓到的内容能不能用于训练苹果的基础模型。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
