Amazonbot 是亚马逊用来改进产品与服务的爬虫,亚马逊自己的文档写明:它读取的内容可能用于训练 Amazon AI 模型。用途就写在那份官方说明里——放行之前先读它,再用自己的数据看它到底读了什么。本文覆盖三个亚马逊代理、robots.txt 写法、IP 核实和一个可复算的算例。
读完你会知道
- 亚马逊文档列出三个互相独立的代理:Amazonbot(可能训练 Amazon AI 模型)、Amzn-SearchBot(Alexa 搜索,不用于生成式 AI 训练)、Amzn-User(替用户实时抓取,不用于训练)
- 禁止 Amazonbot、允许 Amzn-SearchBot,即可退出训练、保留 Alexa 搜索资格;规则可能滞后最多 30 天
- 按亚马逊公布的 IP 文件核实请求,再用自己的读取量和带回访问做判断,而不是只看爬虫名字
Amazonbot 是什么
Amazonbot 是亚马逊用来改进产品与服务的爬虫。亚马逊自己的文档写明,这"有助于向客户提供更准确的信息,并可能用于训练 Amazon AI 模型"(亚马逊爬虫文档,更新于 2026-10-26)。它的 User-Agent 里带有 Amazonbot/0.1,版本号可能会变;旧字符串里附带的 developer.amazon.com/support/amazonbot 链接,如今会重定向到同一份文档页。
用途就写在亚马逊自己的说明里:放行之前先读那份说明,再用自己的数据看它到底读了什么。Amazonbot 是亚马逊文档列出的三个代理之一,各项设置互相独立——屏蔽 Amazonbot 不会挡住 Alexa 搜索,允许搜索也不等于允许训练。
亚马逊文档里的三个代理
下面的对照表只采用亚马逊自己的表述。写规则时有三个细节要注意:
- 每个代理的设置互相独立,改动可能需要约 24 小时才会反映到亚马逊的系统里。
- 如果你的 robots.txt 没有点名 Amzn-SearchBot,但允许其他搜索爬虫,Amzn-SearchBot 会按照给其他搜索爬虫的指令来抓取。
- Amzn-User 替用户实时抓取页面——比如为 Alexa 的提问取回最新信息——因此它可能不完全遵守 robots.txt 指令。
| 代理 | 亚马逊怎么说 | AI 训练? | robots.txt 说明 |
|---|---|---|---|
| Amazonbot | 改进产品与服务;可能用于训练 Amazon AI 模型 | 可能用于 | ✓ 禁止即退出训练 |
| Amzn-SearchBot | 改进 Alexa 等搜索体验 | 不用于生成式 AI 训练 | 未点名时,跟随给其他搜索爬虫的规则 |
| Amzn-User | 替用户实时取页,如 Alexa 提问 | 不用于生成式 AI 训练 | ~ 可能不完全遵守 robots.txt 指令 |
来源:亚马逊爬虫文档,更新于 2026-10-26,2026-11-15 核对。各项设置互相独立(约 24 小时生效)。
robots.txt 写法
上面这组规则退出 Amazon AI 训练,同时保留内容出现在 Alexa 搜索里的资格。亚马逊的 robots.txt 政策还有五个细节:
- 规则按主机读取。亚马逊的爬虫会分别找 example.com/robots.txt 和 site.example.com/robots.txt,所以想控制哪个主机,就在哪个主机上发布规则文件。
- 它们可能使用最近 30 天内的缓存副本,新规则可能滞后生效;发布后过一段时间再核对真实抓取。
- 如果 robots.txt 取不到,它们会当它不存在——规则文件打不开,等于全部放行。
- 不支持 crawl-delay 指令;限流要在服务器上做。
- 它们遵守链接级的 rel=nofollow,以及页面级的 noarchive("不将该页用于模型训练")、noindex 和 none 元标签。
Amzn-User 可能不完全遵守指令,要限制它,得靠服务器上的访问控制,而不是规则文件。
User-agent: Amazonbot
Disallow: /

User-agent: Amzn-SearchBot
Allow: /
核实请求是不是真的 Amazonbot
User-Agent 可以伪造。亚马逊公布了每个代理的 IP 地址;三个文件均于 2026-11-15 抓取并解析:
- Amazonbot IP 文件:1,292 个 IPv4 地址,键名
ipv4Prefix,creationTime 为 2026-09-08。 - Amzn-SearchBot IP 文件:816 个 /32 前缀,键名
ip_prefix——和另外两个文件的键名不同,解析器要兼容两种——creationTime 为 2026-09-08。 - Amzn-User IP 文件:1,023 个地址,键名
ipv4Prefix,creationTime 停在 2025-11-04,比另外两个旧;依赖它之前先重新抓取。
把每条请求的来源地址,和 User-Agent 所写代理对应的文件对照。来自列表之外地址、自称 Amazonbot 的请求不是亚马逊的。2024 年 AWS re:Post 社区的一个回答建议用反向 DNS 查到 crawl.amazonbot.amazon 子域、再正向回查(re:Post);现行官方文档给的是 IP 文件。
检查自己的数据
决定之前,先数清 Amazonbot 到底读了什么。示例数据:30 天,演示项目,已导入服务器日志,因为页面脚本只能看到执行 JavaScript 的爬虫。
已验证的 Amazonbot 共读取 4,800 次:产品页 2,880 次(2,880 ÷ 4,800 = 60%)、博客 1,440 次(30%)、文档 480 次(10%)。独立页面:产品 480 + 博客 360 + 文档 120 = 960 个,整体每页 5.0 次读取(4,800 ÷ 960)。
| 路径类别 | 读取次数 | 占比 | 独立页面数 | 每页读取 |
|---|---|---|---|---|
| /products/ | 2,880 | 60% | 480 | 6.0 |
| /blog/ | 1,440 | 30% | 360 | 4.0 |
| /docs/ | 480 | 10% | 120 | 4.0 |
产品页被反复读取得最多:2,880 ÷ 480 = 每页 6.0 次,博客是 1,440 ÷ 360 = 4.0 次。从亚马逊带回的真人访问:6 次,即 6 ÷ 4,800 = 0.125%,约等于零——它是内容读取方,不是流量渠道。
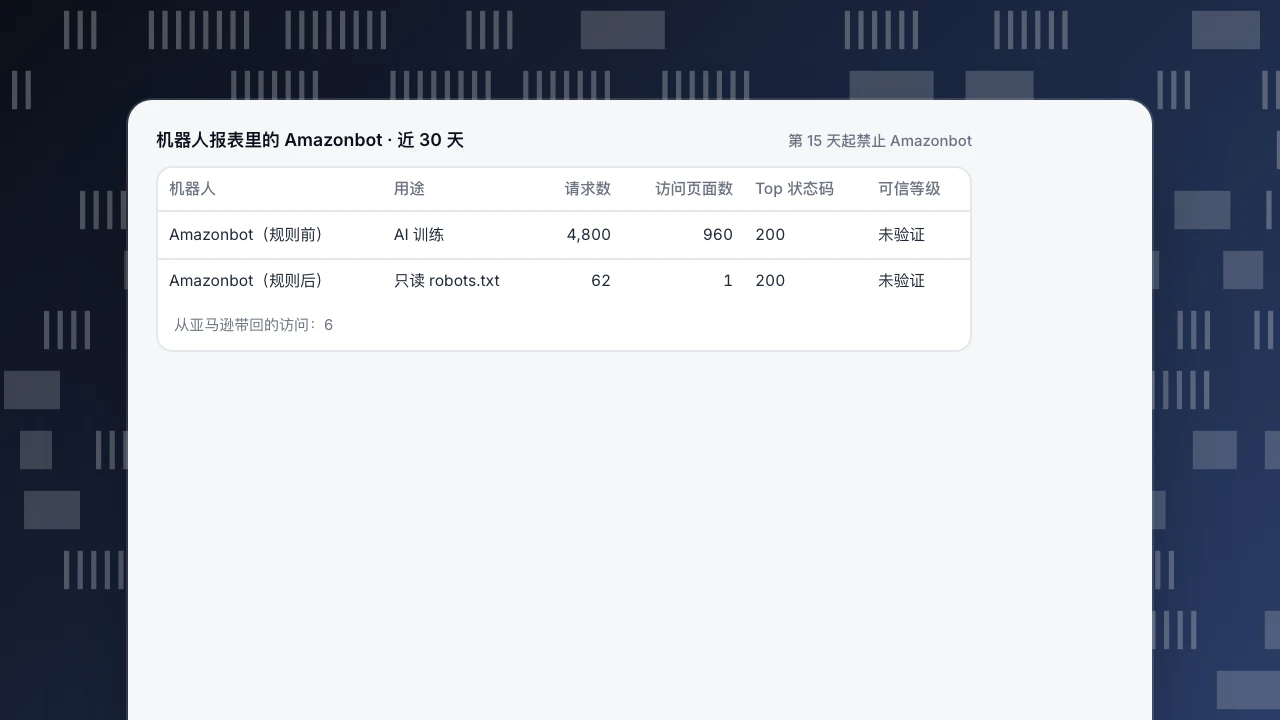
第 15 天发布了 Disallow 规则。之后,已验证的亚马逊 IP 只剩 62 次抓取,全部是 /robots.txt,内容页为 0 个。这属正常:爬虫仍会读规则文件。如果已验证 IP 还在抓内容页,那是合规问题;来自其他 IP、自称"Amazonbot"的请求则根本不是亚马逊。
机器人报表里的 Amazonbot · 近 30 天
第 15 天起禁止 Amazonbot| 机器人 | 用途 | 请求数 | 访问页面数 | Top 状态码 | 可信等级 |
|---|---|---|---|---|---|
| Amazonbot(规则前) | AI 训练 | 4,800 | 960 | 200 | 未验证 |
| Amazonbot(规则后) | 只读 robots.txt | 62 | 1 | 200 | 未验证 |
从亚马逊带回的访问:6
按目标决定
先读官方说明里的用途,再看自己的数据。亚马逊说 Amazonbot 可能用于训练 Amazon AI 模型;上面的算例显示读取集中在产品页、带回的流量几乎为零。据此:
- 不进训练,但保留 Alexa 搜索资格:禁止 Amazonbot,允许 Amzn-SearchBot。
- 在亚马逊和 Alexa 的体验里可见:两个都允许,并确认关键页面对它们返回 200。
- 折中:放行抓取,但对选定页面加 noarchive——亚马逊把它定义为"不将该页用于模型训练"。
- 降低负载:不支持 crawl-delay;在服务器上限流,并联系 amazonbot@amazon.com。
一个来自官方的变量:文档说,在 robots.txt 里放行 Amazonbot,可能符合 Amazon Content Partners 计划的资格——符合条件的销售额 +1% 联盟佣金加成、托管额度和 AI 流量工具。把它和你的读取分布、回流比值放在一起权衡;不要只为激励放行一个训练爬虫。
robots.txt 只是表达意愿;核对真实抓取,才知道它有没有被遵守。同样的"先读用途"思路也适用于 GPTBot 和 Bytespider;名词解释见 AI 爬虫和机器人。
TapCub 里的 Amazonbot
把上面的例子在 TapCub 里按步骤走一遍:
- 接上服务端记录。 只装页面脚本时,TapCub 只能看到会执行 JavaScript 的机器人。用服务端上报访问记录,或通过接口导入访问日志,4,800 次读取才能全部计入(见 机器人与 AI 爬虫)。默认情况下机器人单独统计,Amazonbot 的读取不会抬高真人访客数,也不会进转化率的分母。
- 看账本。 在 网站统计 › 机器人 的「AI 与智能体」页签里有「AI 内容账本」。Amazon 在训练列,读取 4,800 次,对照带回的真人访客;账本把比值写成「N 次读取 : 1 访客」,带回 6 人就是 4,800 ÷ 6 = 800 : 1。训练爬虫有这样的比值很正常,把它读成「内容消费者」,不要读成丢了流量。
- 看它读了什么。 Amazonbot 属于 AI 爬虫,会出现在 监测 › 抓取健康 里;点开它那一行,能看到它抓得最多的页面。TapCub 不按路径前缀汇总单个爬虫的读取,/products/、/blog/、/docs/ 各占多少,要从这份清单或你的日志里自己加。在「全部机器人」页签,Amazonbot 这一行(运营商 Amazon,用途「AI 训练」)有请求数、访问页面数、Top 状态码、最后发现、可信等级和命中检测层。TapCub 对 Amazon 不做 DNS 校验,可信等级显示「未验证」;真假要用亚马逊的 IP 文件分开。
- 屏蔽后查合规。 监测 › 爬虫合规 页的「规则文件生成器」有「禁止所有 AI 训练爬虫」选项,名单里有 Amazonbot;Amzn-SearchBot 的
Allow那一组要自己保留。发布 Disallow 之后,同一页会把 robots.txt 和实际抓取对比,列出被禁止后仍抓取、抓了写明不允许的路径这类违规。亚马逊可能用最长 30 天的缓存,判定违规之前要把这段时间算进去。
TapCub 不做的事:它只衡量,不拦截,执行靠 robots.txt 加服务器限流。亚马逊文档里的三个代理,TapCub 按名字认的是 Amazonbot;Amzn-SearchBot 和 Amzn-User 没有单独的行。
常见问题
Amazonbot 是用来做什么的?
亚马逊的文档说,Amazonbot 用于改进亚马逊的产品与服务,帮助向客户提供更准确的信息,它读取的内容可能用于训练 Amazon AI 模型。这就是官方口径的用途;本文不作超出文档的猜测。
怎么屏蔽 Amazonbot?
在每个主机根目录的 robots.txt 里加一组 User-agent: Amazonbot 和 Disallow: /。想保留 Alexa 搜索资格,就继续允许 Amzn-SearchBot。亚马逊的爬虫可能使用最长 30 天前的缓存副本,发布后要再核对真实抓取。
屏蔽 Amazonbot 会让我的网站从 Alexa 里消失吗?
不会。Alexa 搜索资格来自 Amzn-SearchBot,它有自己独立的 robots.txt 设置;禁止 Amazonbot 只是退出训练爬虫。如果你的 robots.txt 没有点名 Amzn-SearchBot,但允许其他搜索爬虫,它会跟随那些搜索爬虫的规则。
Amazonbot 用于 AI 训练吗?
亚马逊的文档说,Amazonbot 读取的内容"可能用于训练 Amazon AI 模型",在 robots.txt 里禁止它即表示退出。另外两个代理 Amzn-SearchBot 和 Amzn-User,文档明确写着不为生成式 AI 模型训练抓取内容。
Amazonbot 遵守 robots.txt 吗?
亚马逊说,列出的代理遵守 Robots Exclusion Protocol,包括 user-agent 与 allow/disallow 指令、rel=nofollow 和 noarchive 元标签;不支持 crawl-delay。例外是 Amzn-User:它的抓取可能由用户发起,因此可能不完全遵守 robots.txt 指令。
怎么核实一条请求是不是真的 Amazonbot?
User-Agent 可以伪造,所以要把请求的来源 IP 和 User-Agent 所写代理对应的官方 IP 文件对照:Amazonbot 1,292 个地址、Amzn-SearchBot 816 个、Amzn-User 1,023 个(2026-11-15 解析)。来自这些列表之外的请求不是亚马逊的。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
