AhrefsBot 是 Ahrefs 的 SEO 爬虫:它替 Ahrefs 用户(包括竞争对手)读取你的链接和内容,不会给你带回访客,所以放不放行取决于你自己用不用 Ahrefs、服务器扛不扛得住,而不是流量。本文讲两个爬虫各做什么、robots.txt 怎么写、怎么验真、怎么决定。
读完你会知道
- AhrefsBot 为 Ahrefs 链接索引和 Yep 搜索供料;示例里 41,800 次请求,带回访客 0
- AhrefsBot 和 AhrefsSiteAudit 是两个爬虫;都遵守 robots.txt 和 Crawl-delay,但间隔只限 HTML
- 按自己用不用 Ahrefs、服务器负载决定,不看流量;用 rDNS(ahrefs.com / ahrefs.net)或官方 IP JSON 验真
AhrefsBot 是什么
AhrefsBot 是 Ahrefs 用来建链接索引、并为旗下搜索引擎 Yep 供料的爬虫,不是 AI 训练爬虫。它的 User-Agent 是 Mozilla/5.0 (compatible; AhrefsBot/7.0; +http://ahrefs.com/robot/),版本号可能会变(见 Ahrefs Bots 官方说明)。
日志里全是它,说明 Ahrefs 的用户——可能包括你的竞争对手——在查你网站的外链数据,或者用 Site Audit 审计你的网站。AhrefsBot 不会给你带回访客:它读你的页面和链接,是为了别人的报告。所以放不放行不是流量问题,而是你自己用不用 Ahrefs、服务器扛不扛得住的问题。
Ahrefs 的两个爬虫
Ahrefs 官方文档列了两个爬虫,名字像、分工不同,robots.txt 里也要分开写:
- AhrefsBot:为 Ahrefs SEO 工具背后的链接索引抓取,也供 Yep 搜索索引。UA 标记是
AhrefsBot/7.0。 - AhrefsSiteAudit:为验证过的站长跑按需 Site Audit 审计,有桌面和移动两个 User-Agent,都带
AhrefsSiteAudit/6.1,抓取速度不超过每分钟 30 个 URL。默认遵守 robots.txt;验证过的站长可以要求 Ahrefs 为自己的审计破例放行(见 Ahrefs Bots)。
两者都遵守 robots.txt 和 Crawl-delay,服务器返回 4xx 或 5xx(比如 HTTP 500 错误)时都会自动降速。对照表汇总了两者的差别。
| 爬虫 | User-Agent | 用途 | robots.txt / Crawl-delay | 速度与例外 |
|---|---|---|---|---|
| AhrefsBot | AhrefsBot/7.0 | Ahrefs 链接索引 + Yep 搜索 | 遵守;Crawl-delay 只对 HTML 生效 | 4xx/5xx 自动降速;官方未公布速度上限 |
| AhrefsSiteAudit | AhrefsSiteAudit/6.1(桌面 + 移动) | 为验证站长跑按需 Site Audit | 默认遵守;验证站长可申请例外 | 上限 30 URLs/分钟;4xx/5xx 自动降速 |
来源:Ahrefs Bots 官方页与帮助文章 78158,2026-11-15 核对。Crawl-delay 只限 HTML 抓取;JS 渲染的资源请求不受限。
robots.txt 写法
不写规则就是放行:两个爬虫都只跟随链接、始终用 GET 抓取(见 帮助文章 78158)。三种常见写法:
- 放行(默认):robots.txt 不动,或写
User-agent: AhrefsBot加Allow: /。 - 全部屏蔽:
User-agent: AhrefsBot加Disallow: /;想连审计一起停,再给AhrefsSiteAudit单独写一组。 - 限速:
Crawl-Delay: 10表示每 10 秒抓一个 HTML 页面,即每分钟 6 个。
本节末尾的 robots.txt 片段保持 AhrefsBot 放行但限速,同时让 Site Audit 不进私有目录。
照官方文档,有两个边界要记住。其一,Crawl-delay 只对 HTML 页面生效:AhrefsBot 渲染 JavaScript 时并发抓取的资源请求,不受这个间隔限制。其二,robots.txt 本身有错误时,Ahrefs 说爬虫会照旧抓取——规则文件写坏了不等于屏蔽。改动在下次计划抓取前生效,不是立即生效。
User-agent: AhrefsBot
Crawl-Delay: 10

User-agent: AhrefsSiteAudit
Disallow: /private/
核实请求是不是真的 AhrefsBot
User-Agent 字符串随手就能伪造,所以验真要查请求的来源地址,不能只看字符串:
- 反向 DNS:主机名必须以
ahrefs.com或ahrefs.net结尾;再把这个主机名正向解析一遍,确认能解析回原来的 IP。 - 官方 IP 段:Ahrefs 把爬虫 IP 段公布成 JSON:crawler-ip-ranges 和 crawler-ips(见 IP 段帮助文章)。把日志里的来源地址和名单对照;按 IP 放白名单时,要覆盖全部公布的段。
来自这些段之外、自称 AhrefsBot 的请求不是 Ahrefs 的。下结论前先把已验证和未验证的请求分开数——未验证的那部分不该影响你的决定。
检查自己的数据
决定放行还是屏蔽之前,先算一笔抓取量和带回访客的账。下面是示例数据,近 30 天:
- AhrefsBot:38,400 次请求,覆盖 6,200 个页面。
- AhrefsSiteAudit:3,400 次请求,覆盖 1,150 个页面。
- 合计:38,400 + 3,400 = 41,800 次请求;6,200 + 1,150 = 7,350 个页面。
- 从 ahrefs.com 或 yep.com 来的真人访客:0。每次抓取带回的访客:0 ÷ 41,800 = 0;「多少次抓取换一个访客」根本算不出来,因为一个都没带回。
再算服务器负载这一头。一次覆盖全部 7,350 页的全站审计,按 Site Audit 每分钟 30 个 URL 的上限,需要 7,350 ÷ 30 = 245 分钟 ≈ 4.1 小时。加上 Crawl-Delay: 10,HTML 请求降到每分钟 6 个:7,350 ÷ 6 = 1,225 分钟 ≈ 20.4 小时——拉长到 5 倍,JS 渲染的资源抓取除外。
这笔账把本文的核心观点算实了:41,800 次抓取换来 0 个访客。流量不是放行 AhrefsBot 的理由;真正的决定变量,是你自己用不用 Ahrefs、服务器还有多少余量。
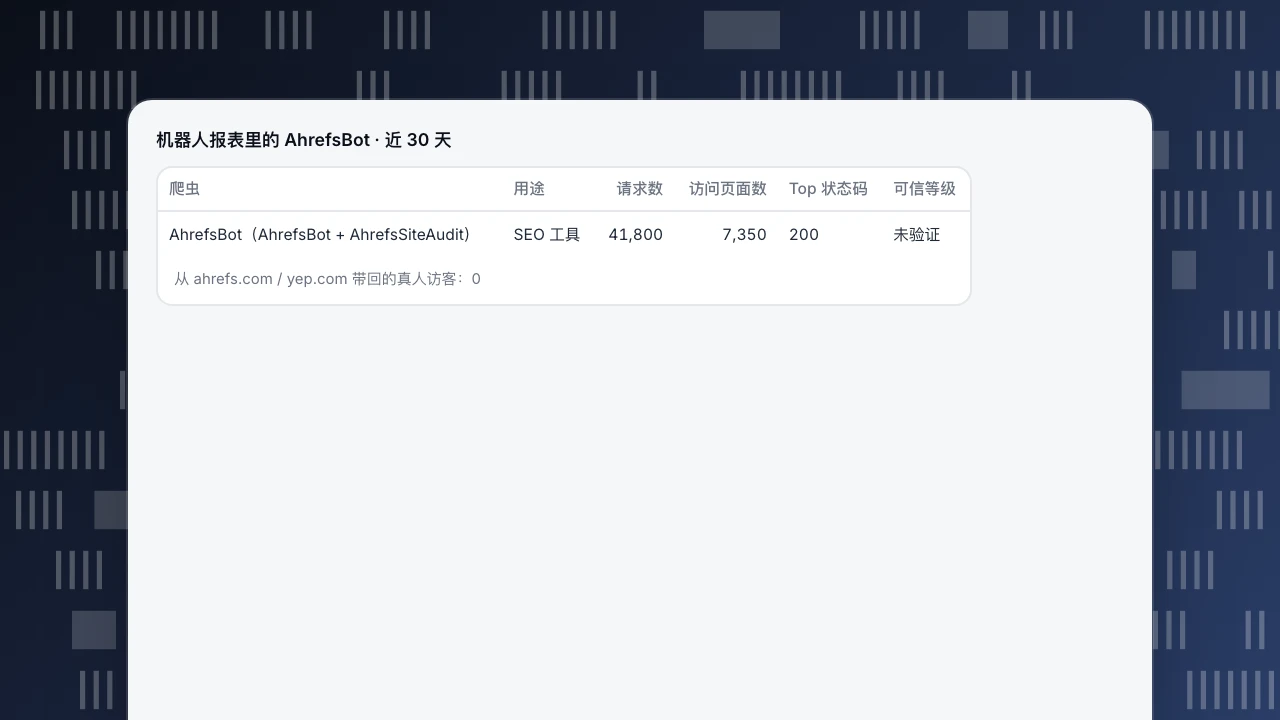
机器人报表里的 AhrefsBot · 近 30 天
| 爬虫 | 用途 | 请求数 | 访问页面数 | Top 状态码 | 可信等级 |
|---|---|---|---|---|---|
| AhrefsBot(AhrefsBot + AhrefsSiteAudit) | SEO 工具 | 41,800 | 7,350 | 200 | 未验证 |
从 ahrefs.com / yep.com 带回的真人访客:0
按目标决定
| 你的目标 | 写法 | 代价 |
|---|---|---|
| 自己在用 Ahrefs(外链、Site Audit) | 两个爬虫都放行 | 无;自己的外链数据和审计保持新鲜 |
| 自己不用 Ahrefs | 屏蔽损失很小,没有自己的报表会停更 | 失去 Yep 这条间接渠道 |
| 被竞争对手跑 Site Audit | 给 AhrefsSiteAudit Disallow: 敏感路径 | 公开页面仍会进对方的审计 |
| 服务器吃紧 | Crawl-Delay: 10(只对 HTML);4xx/5xx 本就会触发降速 | 自己在 Ahrefs 里的数据更新变慢 |
| 想要 Yep 搜索收录 | 放行 AhrefsBot | 无;Yep 是独立的搜索渠道 |
| 完全不想被爬 | 两个爬虫都 Disallow: / | 自己的 Ahrefs 外链和审计数据停更 |
官方页面还有一个细节:AhrefsBot 同时为 Yep 索引供料,所以放行它可能带来 Yep 的间接搜索访客——那是 Yep 渠道的流量,不是爬虫带回的访问(见 Ahrefs Bots)。
示例把规则说清了:AhrefsBot 不带流量,所以为自己的 Ahrefs 数据或 Yep 收录就放行,为负载就限速,两者都不在乎就屏蔽。robots.txt 只是表达意愿;要知道有没有被遵守,得查实际抓取。整站屏蔽的写法见 robots.txt Disallow: /,抓取量的取舍见 抓取预算。
TapCub 里的 AhrefsBot
上面那道题,41,800 次抓取、0 个访客,放还是拦,在 TapCub 里分三页看:
- 找到这一行。 打开 网站统计 › 机器人,切到「全部机器人」页签。TapCub 把 AhrefsBot 和 AhrefsSiteAudit 两种 User-Agent 都归到同一行 AhrefsBot,运营商 Ahrefs,用途「SEO 工具」:示例里是 41,800 次请求,另有访问页面数、Top 状态码、最后发现、可信等级和命中检测层。要看 38,400 / 3,400 的拆分,得按 User-Agent 筛原始日志。TapCub 对 Ahrefs 不做 DNS 校验,所以可信等级显示「未验证」;这不等于伪装,验真用上文的反向 DNS 或 IP 名单。认错了可以点「报告误判」。
- 两头的账都看。 默认情况下,已识别的机器人不进访客、会话和浏览量的真人合计,所以 41,800 次请求不会抬高访客数,也不会稀释转化率。AhrefsBot 是 SEO 工具,不是 AI 爬虫,所以不出现在「AI 内容账本」里。带回的访客去 网站统计 › 来源 看有没有 ahrefs.com、yep.com 的引荐,示例里一个都没有。
- 发布规则,再查有没有被遵守。 加上
Crawl-Delay或Disallow那一组之后,打开 监测 › 爬虫合规。它拉取你的 robots.txt,按爬虫和路径列出三类违规:被全局禁止仍抓取、抓了写明不允许的路径、抓取间隔短于声明的延迟。
TapCub 不做的事:它只衡量抓取,不负责屏蔽。屏蔽要写在 robots.txt 里或在服务器上做;把爬虫加入 TapCub 的排除规则,只是让 TapCub 不再统计它。AhrefsBot 不出现在 监测 › 抓取健康 里,那一页只看搜索引擎和 AI 爬虫。只装页面脚本时,只能看到会执行 JavaScript 的机器人;完整计数、状态码和合规检查要接服务端采集或日志导入(见 机器人与 AI 爬虫)。
常见问题
AhrefsBot 是什么?
Ahrefs 的 SEO 爬虫,为 Ahrefs 链接索引收集链接和内容,也供 Yep 搜索。它不给你带回访客,也不是 AI 训练爬虫。
AhrefsBot 遵守 robots.txt 和 Crawl-delay 吗?
按官方文档:遵守。但 Crawl-delay 只限 HTML 抓取,渲染 JavaScript 时并发抓资源不受间隔限制。robots.txt 有错误时,爬虫会照旧抓取。
怎么核实请求是不是真的 AhrefsBot?
对来源 IP 做反向 DNS,主机名必须以 ahrefs.com 或 ahrefs.net 结尾;或把 IP 对照 Ahrefs 公布的 JSON 段(crawler-ip-ranges / crawler-ips)。名单之外的都不是 Ahrefs。
屏蔽 AhrefsBot 会影响 SEO 或 AI 可见度吗?
不影响 Google 排名,也不影响 AI 答案,更不会损失爬虫流量——它本来就不带访客。代价是你自己的 Ahrefs 外链和审计数据停更;Yep 收录是另一笔取舍。
AhrefsBot 和 AhrefsSiteAudit 有什么区别?
AhrefsBot 建链接索引、供 Yep;AhrefsSiteAudit 给验证站长跑按需审计,有桌面和移动两个 UA,上限每分钟 30 个 URL。robots.txt 里分开写两组控制。
相关阅读
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
