报表里出现从没见过的奇怪来源,通常就是引荐垃圾流量。本文把它分成三种(幽灵请求、爬虫访问和脚本化的浏览器访问),说明每种在报表里的迹象,以及该在哪一层处理,从采集白名单到报表筛选。
读完你会知道
- 幽灵垃圾从不访问你的网站,只有采集白名单能拦住它
- 垃圾来源会跳出、时长 0 秒,还常落在不存在的页面上
- 采集规则修正新数据;过去的时间段用报表筛选
什么是引荐垃圾流量
引荐垃圾流量(referral spam,也叫 referrer spam)是把某个网站伪装成来源的虚假流量,让这个网站的名字出现在你的统计报表里。目的通常是勾起你的好奇心去访问它(见维基百科)。它会扭曲流量、跳出率和渠道报表,而且有一部分根本就不是访问。
引荐垃圾流量的三种类型
处理办法取决于是哪一种:
- 幽灵垃圾:用你网站的统计 ID,直接向统计采集接口发送伪造的请求。发送者从没加载过你的页面,所以你服务器上的任何措施都拦不住它。
- 爬虫垃圾:机器人带着伪造的来源头请求你的页面。它会出现在服务器日志里,只有执行了你的脚本才会出现在统计里。
- 脚本化的浏览器访问:无头浏览器加载页面并执行脚本,看上去就像带来源的真实访客。
下表列出每种类型的迹象,以及能在哪一层拦住它。
| 类型 | 原理 | 迹象 | 在哪拦 |
|---|---|---|---|
| 幽灵垃圾 | 向统计接口发送伪造请求 | 主机名不对;页面不存在 | 只接受自己域名的采集白名单 |
| 爬虫垃圾 | 机器人带伪造来源请求页面 | 服务器日志;机器人报表 | 机器人识别;服务器屏蔽 |
| 脚本化浏览器访问 | 无头浏览器执行你的脚本 | 全部跳出、0 秒、奇怪的 User-Agent | 机器人识别;排除规则 |
| 任何类型的历史数据 | 已经存下 | 来自陌生域名的冲高 | 报表筛选 |
服务器屏蔽拦不住幽灵垃圾。
在报表里识别
垃圾来源有一些真实来源很少具备的共同特征:
- 每个会话都跳出,时长为 0 或接近 0。
- 落地页根本不存在,或者主机名不是你的(幽灵请求)。
- 从没听说过的来源域名,常带「traffic」「seo」「buttons」之类的词,有时每周换一个域名后缀。
- 某几天突然冲高,然后销声匿迹。
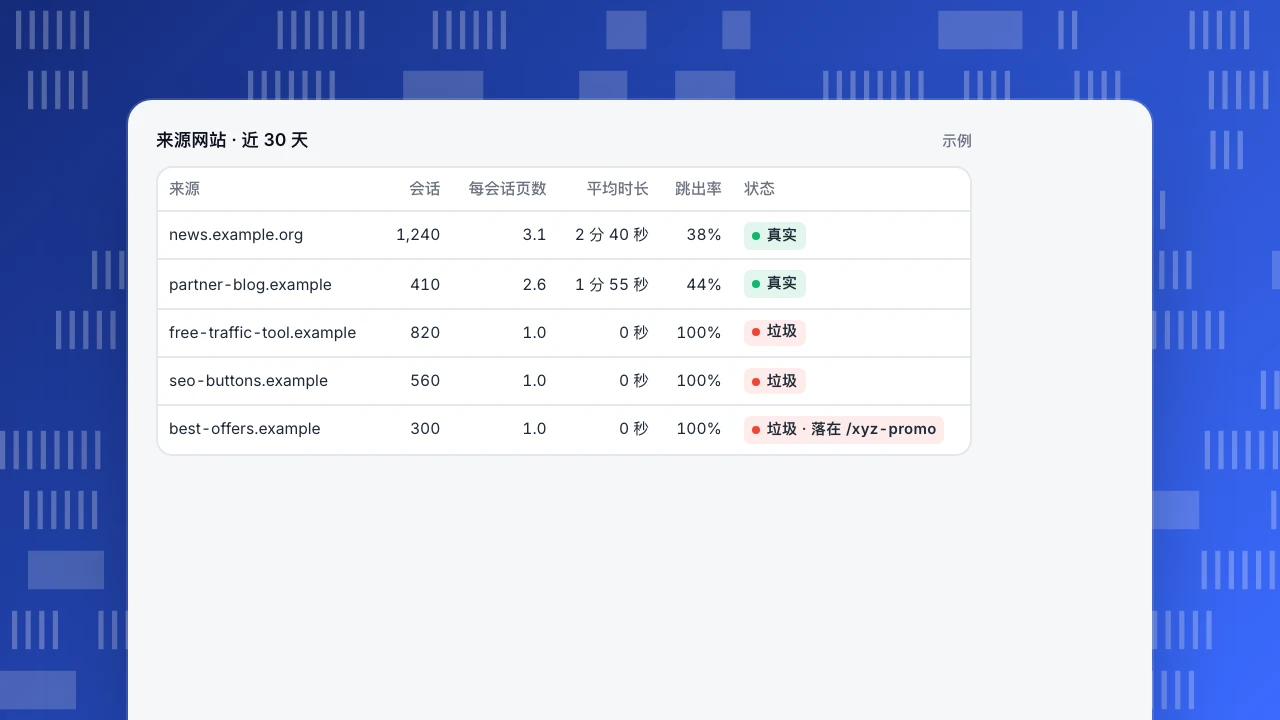
示例里,前两个来源是真实的:会话持续几分钟,访问好几个页面。后三个是垃圾:每个会话一个页面、0 秒,其中一个落在网站根本没有的路径上。
来源网站 · 近 30 天
示例| 来源 | 会话 | 每会话页数 | 平均时长 | 跳出率 | 状态 |
|---|---|---|---|---|---|
| news.example.org | 1,240 | 3.1 | 2 分 40 秒 | 38% | 真实 |
| partner-blog.example | 410 | 2.6 | 1 分 55 秒 | 44% | 真实 |
| free-traffic-tool.example | 820 | 1.0 | 0 秒 | 100% | 垃圾 |
| seo-buttons.example | 560 | 1.0 | 0 秒 | 100% | 垃圾 |
| best-offers.example | 300 | 1.0 | 0 秒 | 100% | 垃圾 · 落在 /xyz-promo |
在对的那一层处理
- 采集时:只接受来自自己域名的请求。幽灵请求来自别处,在存储前就会被拒绝。这是最有效的一道控制。
- 机器人识别:把识别出的机器人和真人报表分开,爬虫垃圾就不会抬高访客数。
- 排除规则:规律明确时,按主机名、User-Agent、IP 或路径丢弃请求。
- 报表筛选:调查期间先在报表视图里隐藏某个来源,不删数据。
- 在服务器上:屏蔽爬虫的 IP 或 User-Agent 能减轻服务器负载,但拦不住幽灵垃圾,因为它根本不会到你这里。
避免一个常见错误:不要去访问垃圾域名「看看」。
清理要分享的报表
采集层的规则只影响新数据。过去的时间段,用一个排除垃圾来源的已保存筛选,并在分享的内容里注明日期范围。对比处理前后的总数:如果垃圾占比大,渠道占比和跳出率都会明显变化。相关内容:直接访问(来源缺失时,部分垃圾会落到那里)和网站访客追踪。
TapCub 里的引荐垃圾流量
TapCub 会把每个请求和项目的允许域名对照:请求的来源主机(以及页面网址的主机)不在列表里,事件就会被丢弃。采集端仍然返回 202,所以发送者无法判断请求有没有被存下(见文档项目设置)。这就挡住了用你的站点密钥、从其他来源发来的幽灵垃圾。
识别出的机器人默认进入单独的机器人报表,不计入真人访客、会话和浏览量(见文档机器人与 AI 爬虫)。排除规则可以按地址、路径、主机名或 User-Agent 丢弃事件;调查期间可以用筛选收窄任意报表(见文档筛选与分享)。要同时排除自己团队的访问,见排除内部流量。更多见机器人和渠道。
常见问题
什么是引荐垃圾流量?
把发送者的网站显示为来源的虚假流量,让它出现在你的统计报表里。
什么是幽灵垃圾?
用你的统计 ID 直接发到采集接口的伪造请求,从没真正访问过你的网站。
怎么拦截引荐垃圾流量?
只接受来自自己域名的请求,把机器人和真人报表分开,对明确的规律加排除规则。服务器屏蔽只对爬虫垃圾有用。
引荐垃圾流量有害吗?
主要伤害你的数据:抬高流量和跳出率,污染渠道报表。不要去访问那些来源网站。
能从历史数据里去掉引荐垃圾吗?
采集规则只作用于新数据。过去的时间段,用报表筛选把垃圾来源排除掉。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。