只要是比较计数,比如各设备转化和没转化的人数、实验每组的用户数,卡方检验就能告诉你差距是不是比偶然更大。本文把两个统计算例一格一格算出来,再讲效应量、前提条件、什么时候换别的检验,以及常见错误。
读完你会知道
- 卡方检验处理类别里的计数,不处理平均值
- 期望值 = 行合计 × 列合计 ÷ 总数
- 自由度 =(行数 − 1)×(列数 − 1)
- 要报告效应量:样本大时小差距也会显著
- 用拟合优度检验发现样本比例失衡
什么是卡方检验?
卡方检验(Chi-square Test,χ² 检验)用来判断各个类别里的计数和「纯属偶然时应有的计数」是否不同。它处理的是频数,比如转化和没转化的访客数、各设备的会话数、分到每个实验版本的用户数,而不是平均值。
主要有两种:
| 检验 | 问题 | 统计里的例子 |
|---|---|---|
| 独立性检验 | 两个分类变量有没有关系? | 转化和设备类型有关吗? |
| 拟合优度检验 | 观测计数是否符合预期分布? | 50/50 的实验真的把流量分成 50/50 了吗? |
两者用同一个统计量:
χ² = Σ(观测值 − 期望值)² / 期望值
观测和期望的差距相对期望值越大,χ² 越大,这个模式越不可能是偶然。把 χ² 和对应自由度(df)的卡方分布比较,就得到 p 值。
算例 1:转化和设备有关吗?
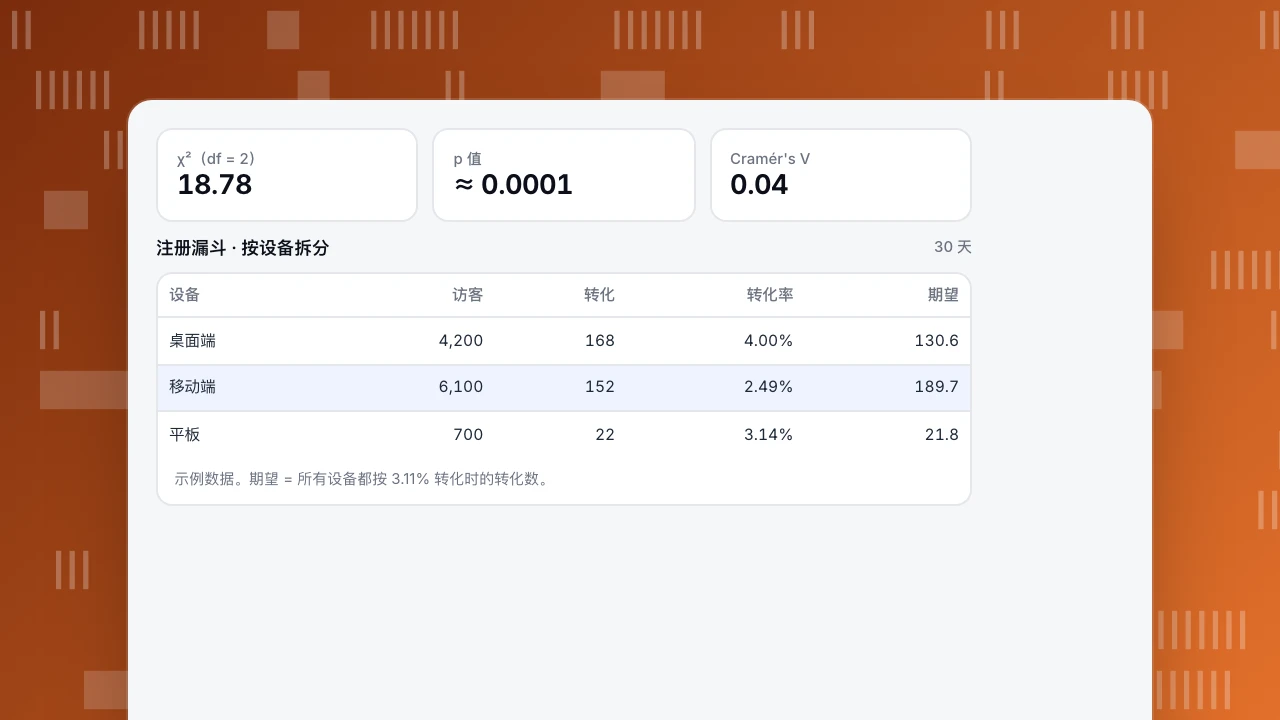
一个月的落地页流量(示例数据):
| 设备 | 访客 | 转化 | 未转化 | 转化率 |
|---|---|---|---|---|
| 桌面端 | 4,200 | 168 | 4,032 | 4.00% |
| 移动端 | 6,100 | 152 | 5,948 | 2.49% |
| 平板 | 700 | 22 | 678 | 3.14% |
| 合计 | 11,000 | 342 | 10,658 | 3.11% |
第 1 步:算期望值。 如果设备和转化无关,每种设备都应该按整体的 3.11% 转化。期望值 = 行合计 × 列合计 ÷ 总数。桌面端转化:4,200 × 342 ÷ 11,000 = 130.6;移动端转化 189.7;平板转化 21.8。未转化的格子用减法得到(4,069.4、5,910.3、678.2)。
第 2 步:把每格的贡献加起来。
| 格子 | 观测 | 期望 | (O − E)² / E |
|---|---|---|---|
| 桌面端,转化 | 168 | 130.6 | 10.72 |
| 桌面端,未转化 | 4,032 | 4,069.4 | 0.34 |
| 移动端,转化 | 152 | 189.7 | 7.48 |
| 移动端,未转化 | 5,948 | 5,910.3 | 0.24 |
| 平板,转化 | 22 | 21.8 | 0.00 |
| 平板,未转化 | 678 | 678.2 | 0.00 |
| χ² | 18.78 |
第 3 步:自由度。 df =(行数 − 1)×(列数 − 1)=(3 − 1)×(2 − 1)= 2。df = 2 时 5% 的临界值是 5.99。
第 4 步:判断。 18.78 远大于 5.99,p ≈ 0.0001。转化和设备不独立。
第 5 步:差在哪里,差多少? 看每格贡献:桌面端转化比预期多,移动端比预期少,平板和预期一样。效应量 Cramér's V = √(χ² ÷ (N × (k − 1))) = √(18.78 ÷ 11,000) = 0.04,很小。有 11,000 个访客时,不大的差距也会「显著」。业务上要问的是:移动端低 1.5 个百分点值不值得修(通常值得:每月 6,100 个移动访客 × 1.5 个百分点 ≈ 92 个转化)。
χ²(df = 2)
18.78
p 值
≈ 0.0001
Cramér's V
0.04
注册漏斗 · 按设备拆分
30 天| 设备 | 访客 | 转化 | 转化率 | 期望 |
|---|---|---|---|---|
| 桌面端 | 4,200 | 168 | 4.00% | 130.6 |
| 移动端 | 6,100 | 152 | 2.49% | 189.7 |
| 平板 | 700 | 22 | 3.14% | 21.8 |
示例数据。期望 = 所有设备都按 3.11% 转化时的转化数。
算例 2:样本比例失衡
某个实验设置为 50/50 分流。两周后:对照组 50,410 人,实验组 49,180 人(共 99,590)。按 50/50 的期望各 49,795 人。
χ² = (50,410 − 49,795)² ÷ 49,795 + (49,180 − 49,795)² ÷ 49,795 = 7.60 + 7.60 = 15.19,df = 1,p ≈ 0.0001。
50.6 / 49.4 看起来无伤大雅,但用户这么多时,偶然出现的可能性很小。这就是样本比例失衡(SRM):分组或埋点某处坏了(某一组的跳转丢了用户、机器人、脚本加载太晚)。出现 SRM 的实验,在找到原因之前,结果都不能信。很多实验团队会自动做这个检查,并用 p < 0.001 这样严格的阈值。
前提条件和不适用的情况
- 用计数,不用百分比或平均值。 先把比率换回计数。
- 观测相互独立。 每个人只算一次。一个用户有很多会话时,按用户计数,或者用能处理重复的方法。
- 每个格子的期望值至少为 5(常用规则;也有教材允许不超过 20% 的格子在 1 到 5 之间)。否则合并类别,或者改用 Fisher 精确检验,小样本 2×2 表的标准做法。
- 类别互斥。 同一张表里一个访客不能既是移动端又是桌面端。
卡方检验和其他检验
| 数据 | 检验 |
|---|---|
| 各类别的计数 | 卡方检验(小样本用 Fisher 精确检验) |
| 两组的两个比例 | 两比例 z 检验(和不做连续性校正的 2×2 卡方检验结果一样) |
| 两组的平均值 | t 检验 |
| 三组及以上的平均值 | 方差分析(ANOVA) |
| 结果怎么随多个输入变化 | 回归,比如逻辑回归 |
| 数据 | 检验 |
|---|---|
| 各类别的计数 | 卡方检验或 Fisher 精确检验 |
| 两个比例 | 两比例 z 检验 |
| 两个平均值 | t 检验 |
| 多个平均值 | 方差分析 |
| 多个输入 | 回归 |
不做连续性校正的 2×2 卡方值,等于两比例 z 检验的 z 值平方。
常见错误
- 把「显著」当「重要」。 统计数据样本大,很小的差距也会显著;要同时报告效应量和实际差距。
- 测了很多拆分,只报碰上的那个。 10 个分群各按 α = 0.05 检验,很可能出一个假阳性,要做 Bonferroni 校正之类的修正,另见I 类和 II 类错误。
- 把会话当成独立的人。 会虚增样本和 χ²。
- 忽略构成差异。 设备差距可能来自渠道构成(移动流量大多来自社交),要在各渠道内部再看一遍,避免辛普森悖论。
- 只停在「有差异」。 检验只说明这张表不是随机的;看每格贡献和比率才知道差在哪里。
用 TapCub 的数据做检验
建一个按设备、渠道或国家拆分的漏斗或目标报表,读出每一步到达和没到达的人数,直接填进上面的表;表格(CHISQ.TEST)或 Python(scipy.stats.chi2_contingency)就能算完。TapCub 本身不做 A/B 实验,但如果你在实验工具里把版本名作为事件属性发过来(自定义事件),就能按版本数人数,跑算例 2 的 SRM 检查。
另见:推断统计。
参考资料
- NIST/SEMATECH. e-Handbook: chi-square goodness-of-fit test.
- Penn State STAT 500. Chi-square test of independence.
- Fabijan, A. et al. (2019). Diagnosing sample ratio mismatch in online controlled experiments. KDD 2019.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。