回归把一团散点变成能拿来做预算的数字:每个驱动因素变动一个单位,结果动多少,以及有多大把握。本文用 12 周的广告花费、自然流量和注册数演示:只看花费的模型说每 1,000 美元带来 14 个注册,控制了自然需求的模型说是 10.6 个。
读完你会知道
- 回归估计效应大小、不确定性,还能做预测
- 漏掉一个相关的驱动因素,系数会被带偏
- 比较变量个数不同的模型,用调整后 R²
- 检查线性、独立、正态和方差相等
- 观测数据得出的系数是关联,不是因果
什么是回归分析?
回归分析(Regression Analysis)是一类统计方法,用来估计一个结果(因变量)会随一个或多个输入(自变量或预测变量)怎么变化。它给出图表给不了的三样东西:每个关系有多大、这个大小有多不确定,以及给定新的输入时怎么预测结果。
在数据分析里,常见的问题是:在自然流量不变的情况下,广告每多花 1,000 美元能多带来多少注册?加载时间每多 1 秒,转化损失多少?哪些客户行为能预测流失?
最简单的形式就是散点图里的一条直线:
y = β₀ + β₁x + ε
β₀ 是截距,β₁ 是斜率(x 每变化一个单位,y 变化多少),ε 是直线解释不了的误差。普通最小二乘法(OLS)选出让误差平方和最小的那条线。
回归的种类
| 类型 | 结果 | 统计里的例子 |
|---|---|---|
| 简单线性回归 | 连续值,一个预测变量 | 注册数和广告花费 |
| 多元线性回归 | 连续值,多个预测变量 | 注册数和花费、自然流量、节假日 |
| 逻辑回归 | 是 / 否 | 这个试用会不会转付费?这个账号会不会流失? |
| 泊松 / 负二项回归 | 计数 | 每个账号每月的工单数 |
| 多项式 / 样条回归 | 曲线关系 | 转化率和加载时间,边际递减 |
| 带时间项的回归 | 时间序列 | 带趋势和季节性的周销售额 |
| 类型 | 结果 | 例子 |
|---|---|---|
| 简单线性回归 | 连续值,一个预测变量 | 注册数和花费 |
| 多元线性回归 | 连续值,多个预测变量 | 注册数和花费、自然流量 |
| 逻辑回归 | 是 / 否 | 试用会不会转付费 |
| 泊松回归 | 计数 | 每个账号的工单数 |
按要建模的结果选回归类型。
计算示例:广告花费能带来注册吗?
某 SaaS 网站 12 周的数据(示例数据):每周广告花费(千美元)、自然搜索会话(千次)和注册数。
| 周 | 广告花费(千美元) | 自然会话(千次) | 注册数 |
|---|---|---|---|
| 1 | 2.0 | 8.0 | 109 |
| 2 | 2.5 | 9.6 | 116 |
| 3 | 3.0 | 8.6 | 121 |
| 4 | 2.2 | 10.4 | 121 |
| 5 | 3.5 | 9.0 | 131 |
| 6 | 4.0 | 11.2 | 140 |
| 7 | 3.2 | 10.8 | 135 |
| 8 | 4.5 | 10.0 | 139 |
| 9 | 5.0 | 12.2 | 162 |
| 10 | 4.2 | 11.6 | 142 |
| 11 | 5.5 | 11.0 | 158 |
| 12 | 6.0 | 12.8 | 170 |
模型 1:只用花费解释注册
注册数 = 83.1 + 14.2 × 花费。斜率的标准误 1.2,R² = 0.93。
直接读:每多花 1,000 美元多 14 个注册,一个注册大约 70 美元。
模型 2:加上自然会话
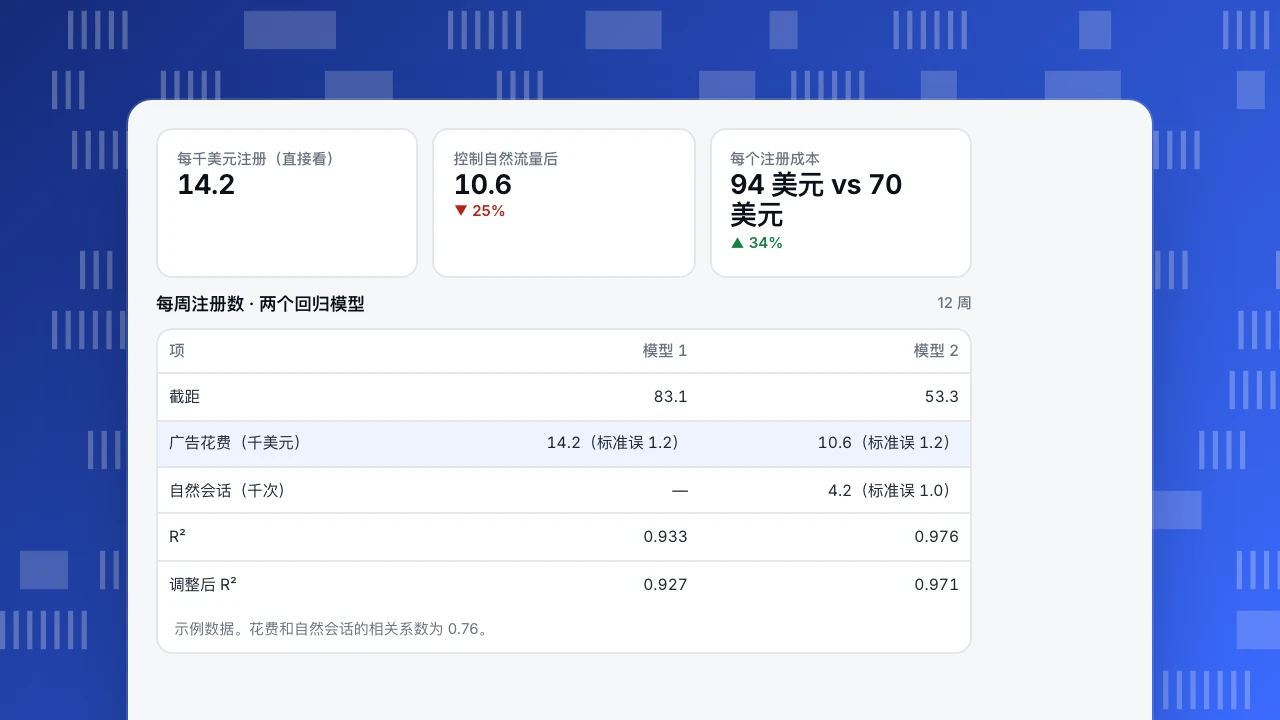
注册数 = 53.3 + 10.6 × 花费 + 4.2 × 自然会话(千次)。标准误分别为 1.2 和 1.0,R² = 0.976,调整后 R² = 0.971。
花费的系数降了四分之一。为什么?这个季度里花费和自然流量一起上涨(相关系数 0.76),因为团队在旺季加了预算,而旺季本来自然搜索的兴趣就高。模型 1 把旺季自然需求带来的注册也算到了广告头上。自然流量是一个混杂变量,漏掉它让估计偏高,这就是遗漏变量偏差。
在自然会话不变时,多花 1,000 美元大约带来 10.6 个注册:每个注册的成本更接近 94 美元而不是 70 美元,这个差距足以改变预算决定。
预测: 某周花费 5,000 美元、自然会话 11,000 次,模型 2 预测 53.3 + 53.0 + 45.8 ≈ 152 个注册。残差标准误大约是 3 个注册,偏离这个范围很多的周值得查一查。
每千美元注册(直接看)
14.2
控制自然流量后
10.6
▼ 25%
每个注册成本
94 美元 vs 70 美元
▲ 34%
每周注册数 · 两个回归模型
12 周| 项 | 模型 1 | 模型 2 |
|---|---|---|
| 截距 | 83.1 | 53.3 |
| 广告花费(千美元) | 14.2(标准误 1.2) | 10.6(标准误 1.2) |
| 自然会话(千次) | — | 4.2(标准误 1.0) |
| R² | 0.933 | 0.976 |
| 调整后 R² | 0.927 | 0.971 |
示例数据。花费和自然会话的相关系数为 0.76。
怎么读回归结果
| 输出 | 告诉你什么 | 注意 |
|---|---|---|
| 系数 | 其他变量不变时,x 每变一个单位 y 变多少 | 单位:每 1 美元还是每 1,000 美元? |
| 标准误 | 系数的不确定性 | 样本小,误差就大 |
| t 值 / p 值 | 系数和 0 能不能区分开 | 显著不等于大,见效应量 |
| 置信区间 | 系数的合理范围 | 往往比 p 值更有用,见怎么算置信区间 |
| R² | y 的方差被解释了多少 | 加变量一定会变大 |
| 调整后 R² | 对多余变量做了惩罚的 R² | 比较变量个数不同的模型时用它 |
| 残差 | 模型漏掉了什么 | 残差有规律,说明模型少了东西 |
要检查的假设
线性回归依赖四个假设,常记作 LINE:
- 线性(Linearity): 关系大致是一条直线。用散点图或「残差对拟合值」图检查。
- 独立(Independence): 误差之间互不相关。每日、每周数据常常违反这一条,因为这周像上周;要用带时间项的回归或专门的时间序列模型。
- 正态(Normality): 残差大致服从正态分布(样本小、要算区间时最重要)。
- 方差相等(Equal variance): 残差的离散程度不随预测值变大。收入数据经常不满足,取对数会有帮助。
还要检查多重共线性:两个预测变量高度相关时,模型分不清各自的作用,数据稍有变化系数就大幅摆动。例子里 0.76 的相关在 12 周的数据上还能接受,到 0.95 就不行了。
常见错误
- 把系数当因果效应。 对观测数据做回归,只能说明控制了你放进去的变量之后的关联。没测到的混杂变量照样会带偏结果,见相关不等于因果。
- 外推。 模型是用每周 2–6 千美元的数据拟合的,对 2 万美元的一周说明不了什么,到那时投放早就饱和了。
- 过拟合。 用 10 个变量去拟合 12 周数据,会拟合得完美,却什么也预测不了。经验上每个预测变量至少要 10 到 20 个观测。
- 让离群点主导直线。 一周埋点出错就能把斜率带歪,检查残差和离群值。
- 忽略均值回归。 因为某周表现最差而被选出来优化的页面,下周无论如何都会看起来好一些。
- **追求高 R²。** 时间序列里 R² 很高,常常只是两个变量都在上涨。
用 TapCub 的数据做回归
TapCub 提供回归需要的输入:按渠道的每日或每周会话、目标转化、收入、页面性能和 UTM 活动数据。用 SQL 查询或导出拿到这些数,再加上广告平台的花费数据,到表格(LINEST)、Python(statsmodels)或 R(lm)里拟合。UTM 参数要命名一致,花费和转化才能按活动对上。当某个系数会影响预算决定时,用实验确认一下,比如按地区或按时间留出对照组,因为只有实验能排除你没测到的混杂因素。
参考资料
- NIST/SEMATECH. e-Handbook: linear least squares regression.
- James, G., Witten, D., Hastie, T. and Tibshirani, R. (2021). An Introduction to Statistical Learning, 2nd ed., chapter 3. Springer.
- Penn State STAT 501. Regression methods.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。