I 型错误是宣布了不存在的赢家,II 型错误是错过了真实的效果。本文用 2×2 表讲清两者,用 100 个 A/B 测试算出高效能和低效能下有多少赢家是假的,并列出把两类错误都压低的习惯。
读完你会知道
- I 型 = 假阳性(alpha,通常 5%);II 型 = 假阴性(beta;效能 = 1 − beta)
- 效能低会提高假赢家所占的比例,而不只是多错过几个
- 提前算样本量,不要提前停,只选一个主要指标
两种错误,各一句话
做 A/B 测试时,你是在两种说法之间做判断:「改动没有带来差别」(原假设)和「改动带来了差别」。错,有两种错法。
- I 型错误(I 型错误,假阳性):改动其实没用,你却认为它有效。你上线了一个其实只是噪声的「赢家」。
- II 型错误(II 型错误,假阴性):改动其实有用,你却认为它没效果。你扔掉了一个真实的改进。
两种错误的概率都在测试前由你设定。I 型错误的概率叫 alpha(α),通常是 5%。II 型错误的概率叫 beta(β),1 − β 就是这次测试的检验效能(power),通常设为 80%。
2×2 表
每次测试的结局都落在四个格子之一,取决于真实情况和你的结论。两个格子是正确的判断,两个是错误。
这张表也说明了其中的取舍:把宣布赢家的门槛定得更严(更低的 alpha),假阳性会变少,但假阴性会变多,除非你同时收集更多数据。
| 没有真实效果(原假设为真) | 有真实效果(原假设为假) | |
|---|---|---|
| 你宣布有赢家 | I 型错误:假阳性(概率 = α) | 正确:真阳性(概率 = 效能) |
| 你宣布没有差别 | 正确:真阴性(概率 = 1 − α) | II 型错误:假阴性(概率 = β) |
alpha 和效能在测试前选定,样本量把两者联系起来。
示例:你的赢家有多少是真的?
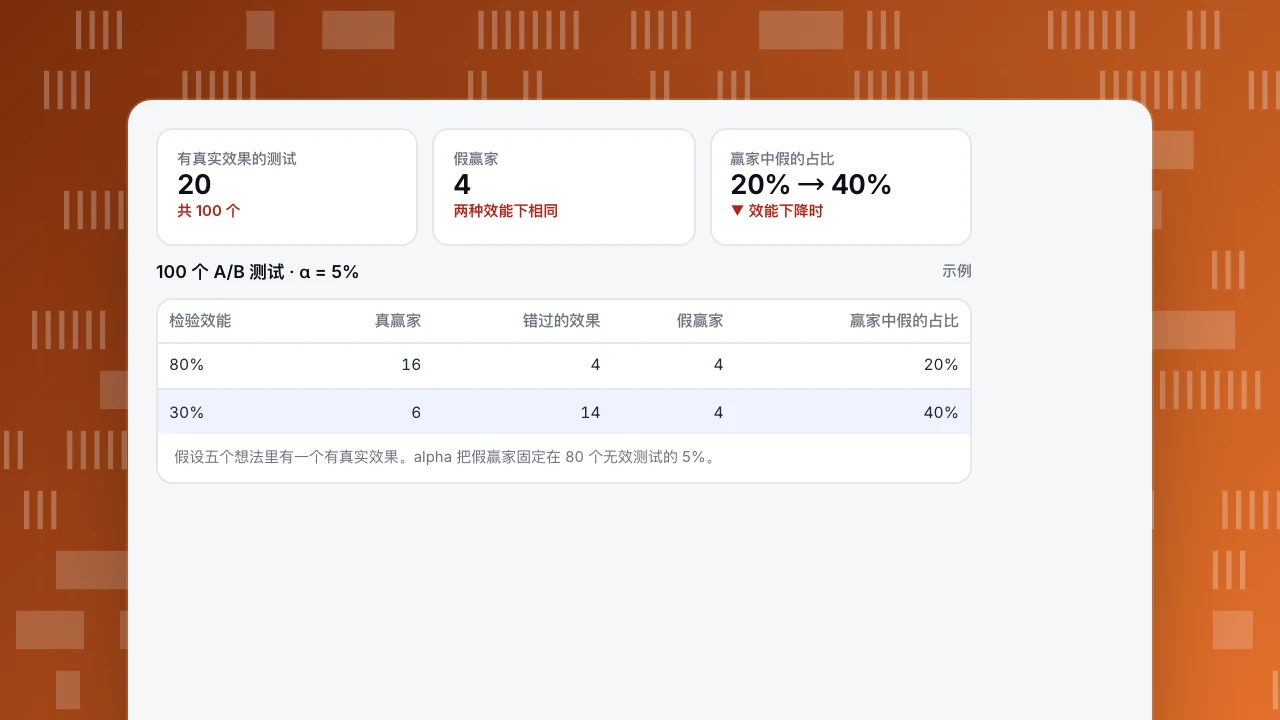
假设一个团队一年做 100 个 A/B 测试。按经验,大约五个想法里有一个真能推动指标,所以 20 个测试有真实效果,80 个没有。他们按 α = 5% 做检验。
检验效能 80% 时(样本量按预期的效果算过):
- 80 个没有真实效果的测试里,5% 会因为偶然显得「显著」:4 个假赢家(I 型错误)。
- 20 个有真实效果的测试里,80% 被检出:16 个真赢家;4 个真实效果被错过(II 型错误)。
- 一共宣布 20 个赢家,其中 4 个、也就是 20% 是假的。
检验效能 30% 时(测试提前停了,或者流量太少):
- 80 个无效测试里还是 4 个假赢家,alpha 没变。
- 20 个真实效果里只检出 6 个,错过 14 个。
- 现在宣布 10 个赢家,其中 4 个、也就是 40% 是假的。
效能低不只是会错过好想法,还会让你找到的赢家更不可信,因为假赢家占的比例更大了。这就是为什么一个做了很多小而短的测试的团队,常常发现那些「胜利」加起来在季度数字里看不出来。
有真实效果的测试
20
共 100 个
假赢家
4
两种效能下相同
赢家中假的占比
20% → 40%
▼ 效能下降时
100 个 A/B 测试 · α = 5%
示例| 检验效能 | 真赢家 | 错过的效果 | 假赢家 | 赢家中假的占比 |
|---|---|---|---|---|
| 80% | 16 | 4 | 4 | 20% |
| 30% | 6 | 14 | 4 | 40% |
假设五个想法里有一个有真实效果。alpha 把假赢家固定在 80 个无效测试的 5%。
把两类错误都压低的四个习惯
- 开始前先算样本量。 定下值得行动的最小效果、基线转化率、alpha 和效能,算出每个版本需要多少访客。在 3% 的转化率上要检出 10% 的相对提升,每个版本需要几万访客。
- 看着不错时别急着停。 每天看结果、第一次出现「显著」就停,会让实际的I 型错误率远高于 5%。跑到计划的样本量,或者用专门为持续监控设计的方法。
- 只选一个主要指标。 在 α = 5% 下检验十个指标,至少有一个因为运气显得显著的概率大约是 40%。事先选定用来做决定的指标,其余的只作参考。
- 大的胜利要复测或留保留组。 准备在其基础上继续做的改动,用第二次测试或保留组确认一遍。真实的效果经得起复测,运气带来的通常会缩水。
哪种错误更糟?
取决于每种错误的代价。价格改动上的假阳性,可能让收入受损好几个月,这时用更严的 alpha、多花一些样本是值得的。廉价文案改动上的假阴性代价很小,门槛放宽一点、多做几个测试可能才是更好的安排。在测试前就定好这个取舍,而不是看到结果后再定。
常见问题
假阳性是 I 型还是 II 型错误?
I 型。假阳性是在原假设为真时拒绝了它:看到了不存在的效果。假阴性,即错过真实效果,是II 型错误。
alpha、beta 和检验效能是什么关系?
alpha 是犯I 型错误的概率,beta 是犯II 型错误的概率,效能等于 1 − beta。样本量固定时,降低 alpha 会提高 beta。增大样本可以在不改变 alpha 的情况下降低 beta。
p 值能告诉我结果是假阳性的概率吗?
不能。p 值是「假设没有真实效果,看到至少这么极端的结果」的概率。赢家里有多少是假的,还取决于你的想法里有多少真的有效、以及检验效能,就像上面的例子。
不增加流量,怎么减少II 型错误?
测更大的改动;用离改动更近的指标(新按钮的点击,而不是收入);过滤机器人和内部流量来降低噪声;或者把测试跑得更久。
另见:实验者偏差。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。