统计显著性告诉你,两个转化率的差距是否超出了偶然通常会造成的范围。本文给出两比例检验的五个步骤,用手算和代码演示:同样 15% 的提升,只有样本更大时才显著,并说明怎么算样本量。
读完你会知道
- 显著性问的是:如果没有真实差别,这个差距有多意外
- 用两比例 z 检验:转化率、合并转化率、标准误、z、p 值
- 先算样本量;同样的提升可能显著,也可能不显著
统计显著性是什么意思
你做了一个 A/B 测试:A 版本的访客转化率是 3.0%,B 版本是 3.45%。B 看起来更好,但就算两个页面一模一样,任意两组访客的转化率也会略有不同。统计显著性要问的是:如果真的没有差别,出现这么大的差距有多意外?
这个「意外程度」用 p 值衡量:假设两个版本实际表现相同,看到至少这么大差距的概率。如果 p 值低于你事先设定的阈值,也就是显著性水平 alpha(通常是 0.05),就说结果在统计上显著。
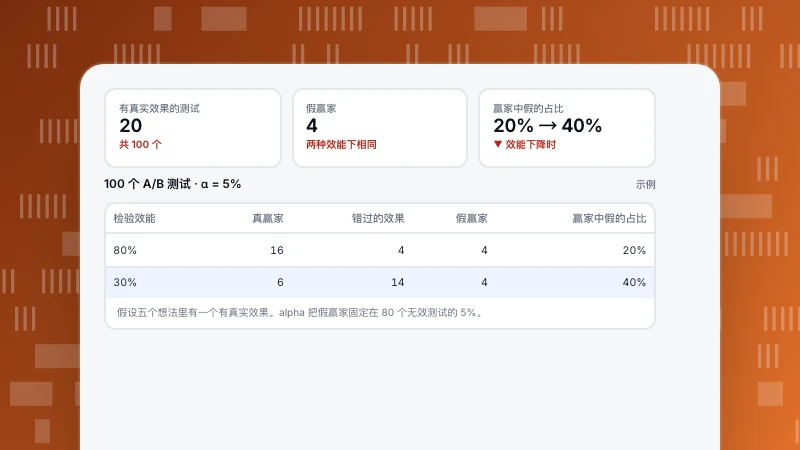
显著不等于差距大或重要,不显著也不等于「没有效果」。它的意思是:在你选的水平上,数据够不够强,能不能排除偶然。可能出错的两种情况,见 I 型错误和 II 型错误。
转化率的五个计算步骤
比较两个转化率,标准方法是两比例 z 检验:
- 分别算出两个转化率。 pA = A 的转化数 ÷ A 的访客数;pB = B 的转化数 ÷ B 的访客数。
- 算合并转化率(假设没有差别):p =(A 转化数 + B 转化数)÷(A 访客数 + B 访客数)。
- 算差值的标准误: SE = √[ p × (1 − p) × (1/nA + 1/nB) ]。
- 算 z 值: z = (pB − pA) ÷ SE。它表示两个转化率相差几个标准误。
- 把 z 换成 p 值。 双侧检验时,p = 2 × (1 − Φ(|z|)),Φ 是标准正态分布。alpha = 0.05 时,|z| 大于 1.96 即为显著。
只要每组的转化和未转化都至少有几十个,正态近似就适用,几乎所有网站测试都满足。
示例
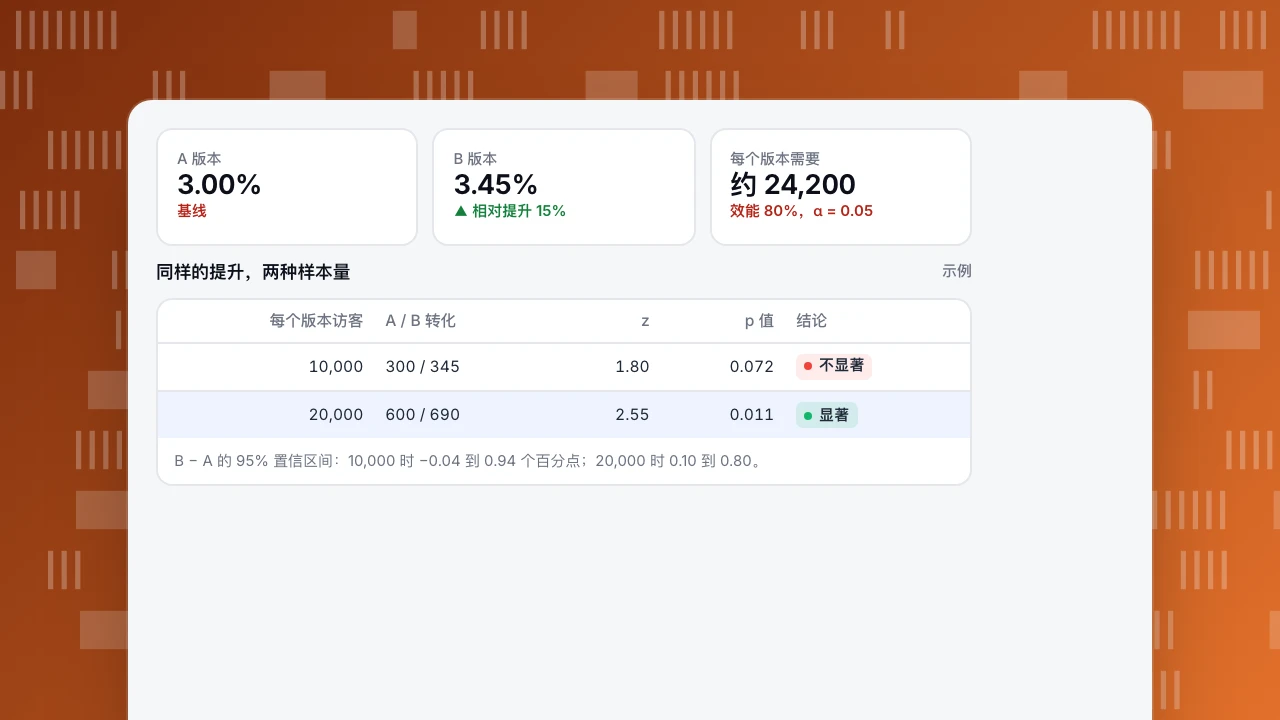
测试 1:每个版本 10,000 个访客。 A:300 次转化(3.00%)。B:345 次转化(3.45%),相对提升 15%。
- 合并转化率:645 ÷ 20,000 = 0.03225。
- SE = √(0.03225 × 0.96775 × 0.0002) = 0.00250。
- z = 0.0045 ÷ 0.00250 = 1.80;p = 0.072。
大于 0.05,所以结果不显著。差值的 95% 置信区间是 −0.04 到 +0.94 个百分点:数据既符合 B 略差一点,也符合 B 好将近一个百分点。
测试 2:同样的转化率,每个版本 20,000 个访客(600 对 690 次转化)。标准误降到 0.00177,z 升到 2.55,p 降到 0.011:显著。置信区间收窄到 +0.10 到 +0.80 个百分点。
同样的提升,不同的结论。决定测试能不能把真实效果和噪声分开的,是样本量,而不只是提升幅度。
A 版本
3.00%
基线
B 版本
3.45%
▲ 相对提升 15%
每个版本需要
约 24,200
效能 80%,α = 0.05
同样的提升,两种样本量
示例| 每个版本访客 | A / B 转化 | z | p 值 | 结论 |
|---|---|---|---|---|
| 10,000 | 300 / 345 | 1.80 | 0.072 | 不显著 |
| 20,000 | 600 / 690 | 2.55 | 0.011 | 显著 |
B − A 的 95% 置信区间:10,000 时 −0.04 到 0.94 个百分点;20,000 时 0.10 到 0.80。
用代码计算
下面的函数跑完五个步骤,返回 z 值和双侧 p 值。它用一个标准的多项式近似来算正态分布,精确到小数点后约四位,做测试决策完全够用。在表格软件里,同样的 p 值是 \=2*(1-NORM.S.DIST(ABS(z),TRUE))\。
// 转化率的两比例 z 检验
function twoProportionTest(convA, nA, convB, nB) {
  const pA = convA / nA, pB = convB / nB;
  const p = (convA + convB) / (nA + nB);           // 假设 A 和 B 相同时的转化率
  const se = Math.sqrt(p * (1 - p) * (1 / nA + 1 / nB));
  const z = (pB - pA) / se;
  const pValue = 2 * (1 - normalCdf(Math.abs(z))); // 双侧 p 值
  return { pA, pB, z, pValue };
}

// 标准正态分布函数(Abramowitz–Stegun 近似)
function normalCdf(x) {
  const t = 1 / (1 + 0.2316419 * x);
  const d = 0.3989423 * Math.exp(-x * x / 2);
  const q = d * t * (0.3193815 + t * (-0.3565638 + t * (1.781478 + t * (-1.821256 + t * 1.330274))));
  return 1 - q;
}

twoProportionTest(300, 10000, 345, 10000); // z ≈ 1.80, p ≈ 0.072
twoProportionTest(600, 20000, 690, 20000); // z ≈ 2.55, p ≈ 0.011
开始前先算样本量
每个版本需要多少访客,取决于基线转化率、值得检出的最小提升、alpha 和检验效能(通常 80%):
每个版本的 n ≈ (1.96 + 0.84)² × [p1(1 − p1) + p2(1 − p2)] ÷ (p2 − p1)²
基线 3.0%、目标 3.45% 时,大约是每个版本 24,200 个访客。上面的测试 1 只有 10,000,本来就没多大机会达到显著;测试 2 的 20,000 接近计划的样本量。上线前就算好,结果第一次看起来显著时也别提前停:反复查看、一看到好结果就停,会让假阳性大大增加。
干净的输入和公式一样重要。机器人、内部访问和重复转化会给两组都加噪声,让真实效果更难被检出。
常见问题
p 值多少算统计显著?
按惯例是低于 0.05(5% 显著性水平)。代价高的决定有的团队用 0.01,便宜、可撤回的改动用 0.10。在测试前选定。
90% 的置信度够吗?
这意味着在没有真实效果的测试上,接受 10% 的假阳性率。能很快撤回的低风险改动,很多团队可以接受;价格或大改版,用 95% 或更严。
测试不显著怎么办?
它说明数据排除不了偶然,而不是两个版本一样。看置信区间:如果区间排除了任何值得要的提升,就停;如果区间很宽,说明测试太小了。
能直接用显著性计算器吗?
能。计算器跑的是同一个检验。知道步骤,能帮你核对输入(如果按访客随机分组,填访客数而不是会话数),并且读懂区间,而不只是结论。
相关阅读:I 型与 II 型错误、p 值。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。