标准差和标准误长得像,报告里经常被混用。本文讲清两者各衡量什么,用三种样本量下的客单价示例和一个转化率例子演示计算,并列出常见误区。
读完你会知道
- 标准差描述数值有多分散,标准误描述平均数估得有多准
- SE = SD ÷ √n:数据变成四倍,标准误减半,标准差不变
- 描述客户用标准差,平均数的误差线用标准误或置信区间
一句话说清区别
标准差(SD)说明单个数值有多分散。标准误(SE)说明你对平均数的估计有多精确。
标准差是数据本身的属性;标准误是你这个估计的属性,数据越多它越小。有人问「我们的客户差别有多大?」,要看标准差;问「我们对这个平均值有多大把握?」,要看标准误。
公式
标准差 SD = √( Σ(x − 平均数)² ÷ (n − 1) )
平均数的标准误 = SD ÷ √n
比例的标准误 = √( p × (1 − p) ÷ n )
关键在 √n。想让标准误减半,需要四倍的观测量。标准差不会这样随 n 变化:数据多了,只是把同一个分散程度估得更准。
一个例子:平均客单价
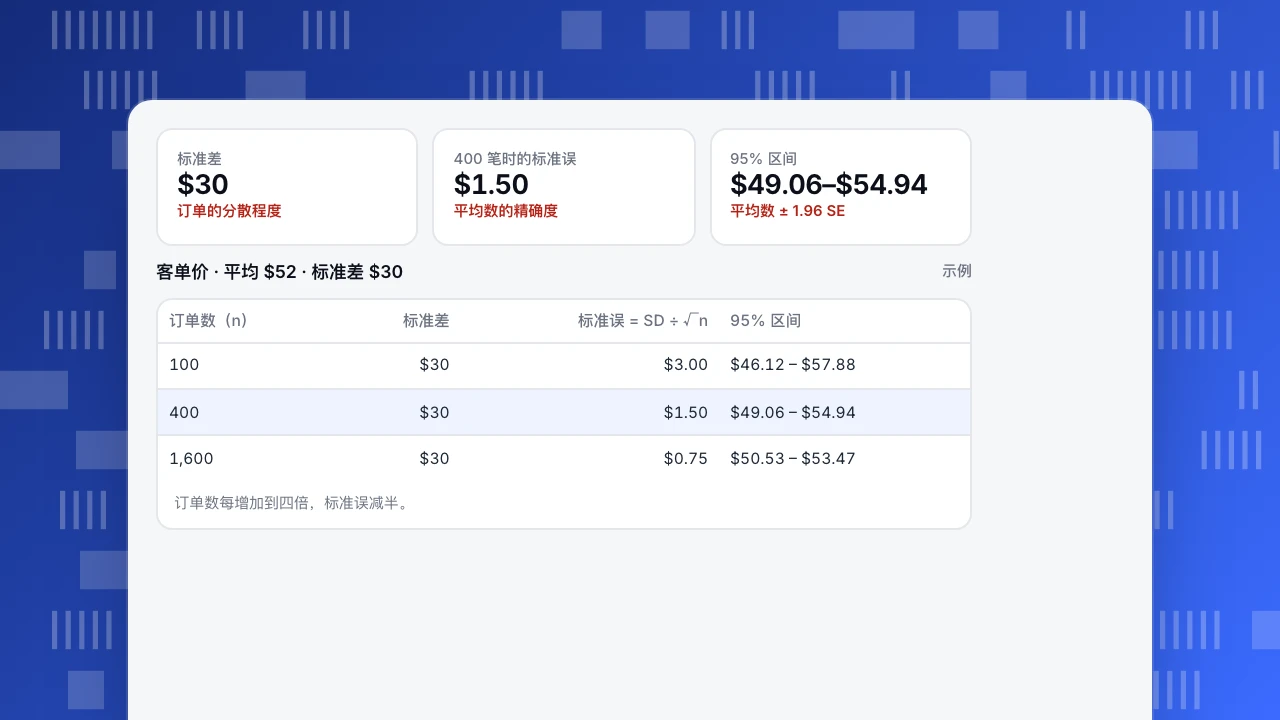
一家店的订单平均 $52,标准差 $30(示例数字)。订单数增加时,标准误这样变化:
- 100 笔:SE = 30 ÷ 10 = $3.00。95% 置信区间是 $52 ± $5.88,即 $46.12 到 $57.88。
- 400 笔:SE = 30 ÷ 20 = $1.50,区间 $49.06 到 $54.94。
- 1,600 笔:SE = 30 ÷ 40 = $0.75,区间 $50.53 到 $53.47。
标准差一直在 $30 左右:顾客之间的差别并没有变小。变化的是你对平均数的把握。
标准差
$30
订单的分散程度
400 笔时的标准误
$1.50
平均数的精确度
95% 区间
$49.06–$54.94
平均数 ± 1.96 SE
客单价 · 平均 $52 · 标准差 $30
示例| 订单数(n) | 标准差 | 标准误 = SD ÷ √n | 95% 区间 |
|---|---|---|---|
| 100 | $30 | $3.00 | $46.12 – $57.88 |
| 400 | $30 | $1.50 | $49.06 – $54.94 |
| 1,600 | $30 | $0.75 | $50.53 – $53.47 |
订单数每增加到四倍,标准误减半。
转化率的版本
对比率来说,分散程度由比率本身决定。2,500 个访客、转化率 4% 时:
- SE = √(0.04 × 0.96 ÷ 2,500) ≈ 0.0039,也就是 0.39 个百分点
- 95% 区间:4% ± 0.77 个百分点,大约 3.23% 到 4.77%
所以在 2,500 个访客上,从 4.0% 涨到 4.3% 完全在噪声范围内。见统计显著性。
放在一起对比
下表总结了什么时候该报哪一个。
| 标准差 | 标准误 | |
|---|---|---|
| 描述 | 单个数值的分散程度 | 估计值(平均数或比率)的精确度 |
| 数据变多会变吗? | 不会,会稳定在真实的分散程度 | 会,按 √n 下降 |
| 公式 | √(Σ(x − 平均数)² ÷ (n − 1)) | SD ÷ √n;比率用 √(p(1 − p) ÷ n) |
| 用在 | 「我们的客户差别有多大?」 | 误差线、置信区间、检验 |
| 常见写法 | 平均数 ± SD | 平均数 ± SE,或 95% CI |
误差线每次都要标注:±SD 和 ±SE 可能差十倍以上。
常见误区
- 用标准误描述客户。 「客单价 $52 ± $1.50」会让人以为客户都差不多,其实差别大得多。描述差异用标准差。
- 平均数的误差线用标准差。 ±SD 的误差线看起来很长,会把平均数之间真实的差别盖住。用标准误或置信区间,并写明是哪一种。
- 不说画的是哪一个。 误差线一定要标注。
- 忘了偏态。 订单金额这类长尾数据,平均数和标准差都可能误导,见平均数和中位数。样本大时平均数的标准误还算可用,但离群值会让它不稳定。
- 忽略数据是怎么抽样的。 公式假设每个观测相互独立。同一个访客的多次会话并不独立,见数据抽样。
从 TapCub 拿到输入数据
算比率只需要分子和分母:从 网站统计 › 目标 取转化数和访客数,或者用 全端分析 里漏斗每一步的人数。算平均数,打开 全端分析 › 行为分析 › 行为分析,选订单金额这类属性,算法选均值;标准差用订单系统或数据仓库里的逐笔金额来算。然后套上面的公式,或者用 p 值比较两组。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。