选数仓、数据湖还是湖仓一体,与其说是选产品,不如说是决定每个数据集那份受管控的正本放在哪里。本文把三者放在一起对比,讲清催生湖仓一体的两层架构问题,并分析两家公司:一家 60 人的 SaaS 应该继续用数仓,一家交易平台则不应该。
读完你会知道
- 数仓适合结构化数据、SQL 和看板
- 数据湖能便宜地存任何原始数据,但需要治理
- 湖仓一体在数据湖存储上加上事务和 SQL
- BI 和机器学习共用一份数据是湖仓一体的主要好处
- 无论哪种,难点都在治理,不在存储
简短回答
数据仓库把结构化、清洗过的数据存成表,专门为 SQL 报表优化。数据湖把任何类型的原始文件便宜地存在对象存储里。湖仓一体(Data Lakehouse)用开放的表格式,在数据湖的存储之上加上数仓的能力(事务、表结构、快速 SQL),让同一份数据既能服务 BI 看板,也能服务机器学习。
如果你的工作主要是看板和对结构化数据跑 SQL,数仓更简单。如果你还需要大量原始、半结构化的数据做数据科学,或者想避免在数据湖和数仓之间来回复制,湖仓一体更合适。
数据仓库、数据湖和湖仓一体对比
| 数据仓库 | 数据湖 | 湖仓一体 | |
|---|---|---|---|
| 数据 | 结构化、建好模的表 | 任何东西:原始文件、JSON、日志、图片 | 任何东西,上面再建表 |
| 表结构 | 写入时定义(加载前) | 读取时解释(查询时) | 表在写入时强制,原始区保持灵活 |
| 存储 | 由数仓管理 | 对象存储(S3、GCS、Azure Blob) | 开放格式的对象存储(Parquet + Delta Lake、Apache Iceberg 或 Hudi) |
| 事务(ACID) | 有 | 没有 | 有,由表格式提供 |
| 主要用户 | 分析师、BI | 数据工程师、数据科学家 | 两者都有 |
| 长处 | SQL 快、受管控、简单 | 便宜、灵活、什么数据都能放 | BI 和机器学习共用一份;开放格式;可回溯历史版本 |
| 短处 | 数据量极大时成本高;不太适合非结构化数据和机器学习 | 缺乏治理就变成「数据沼泽」;临时 SQL 慢 | 组件更多;工具还比较年轻 |
| 例子 | Snowflake、BigQuery、Redshift、ClickHouse | S3 或 GCS 存储桶配 Spark、Presto/Trino | Databricks、能读 Iceberg 表的数仓 |
界线正在变模糊:主流数仓已经能读写开放表格式,湖仓引擎的 SQL 也很快。真正的问题与其说是「选哪一类产品」,不如说是「每个数据集那份受管控的正本放在哪里」。
| 数据仓库 | 数据湖 | 湖仓一体 | |
|---|---|---|---|
| 数据 | 结构化 | 任何 | 任何 + 表 |
| 表结构 | 写入时 | 读取时 | 表在写入时 |
| ACID | 有 | 没有 | 有 |
| 适合 | BI、SQL | 便宜存原始数据 | BI 和机器学习共用一份 |
主流数仓已经能读开放表格式,界线正在变模糊。
湖仓一体为什么会出现
很多公司原本是两层架构:原始数据先进数据湖,再把一部分复制到数仓给 BI 用。这意味着两份副本、两套权限、要维护同步它们的管道,看板还常常比数据湖慢一天。Armbrust 等人(2021)提出,带事务、索引和缓存的开放表格式能让一层存储同时服务两者,这就是湖仓一体的思路。
计算示例:两家公司,两个答案
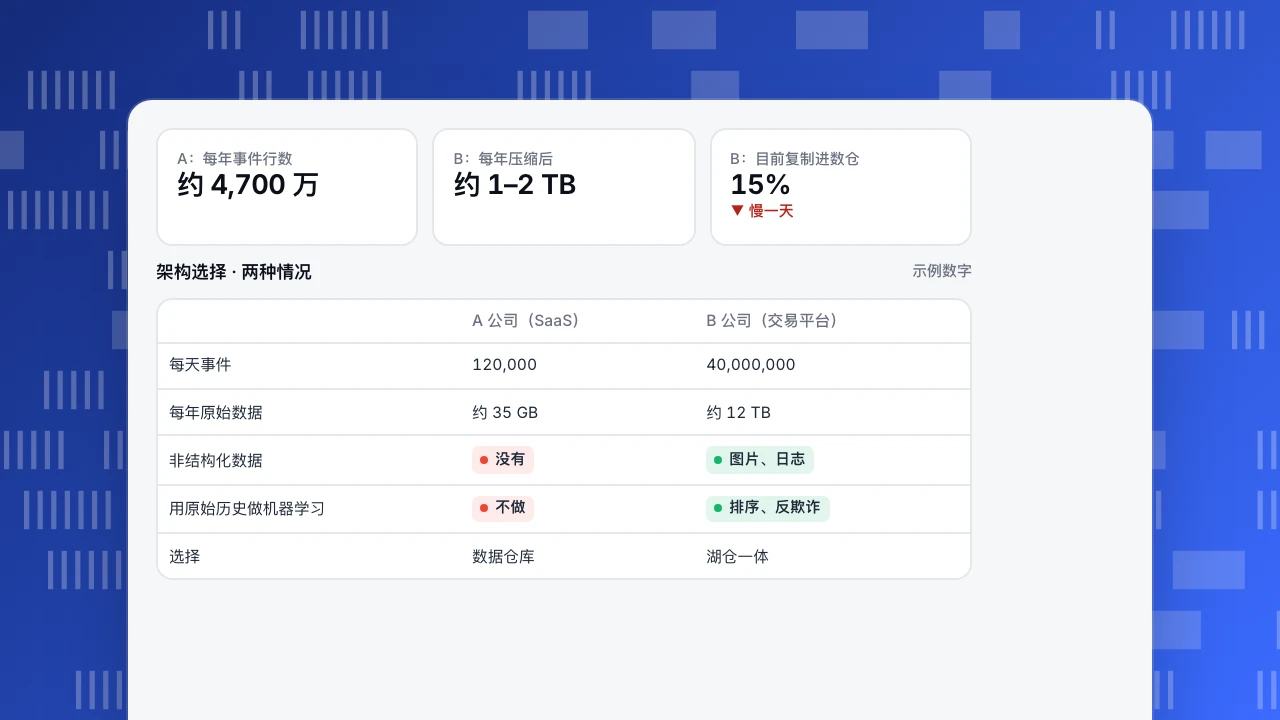
A 公司:B2B SaaS,60 名员工(示例数字)
- 每天约 12 万个产品事件,加上 CRM 和计费表;一年约 4,700 万行事件。
- 用途:每周 KPI 看板、收入报表、留存分群、三个分析师写临时 SQL。
- 除了一个表格规模就能搞定的流失评分,没有机器学习。
答案:数据仓库。 数据是结构化的、量不大;建数据湖只会多出基础设施,没有好处。用 ELT:把原始事件和 SaaS 数据源装进来,用 SQL 建模。
B 公司:交易平台,900 名员工(示例数字)
- 每天约 4,000 万个事件,原始 JSON 每天约 32 GB,压缩前一年约 12 TB;还有图片、搜索日志和用于排序模型的点击流。
- 用途:给 200 个看板用户做 BI,数据科学家用完整的原始历史训练推荐和反欺诈模型。
- 现状:数据落到 S3,每晚把其中 15% 复制进数仓;看板慢一天,两份数据还对不上。
答案:湖仓一体。 所有数据用 Parquet 配开放表格式只存一份,分析师用 SQL 查数据科学家用的同一批表,去掉每晚的复制。一年事件压缩成列式存储大约 1–2 TB,存储成本不是重点;收益是只有一份数据、一套权限、看板更新更及时。
A:每年事件行数
约 4,700 万
B:每年压缩后
约 1–2 TB
B:目前复制进数仓
15%
▼ 慢一天
架构选择 · 两种情况
示例数字| A 公司(SaaS) | B 公司(交易平台) | |
|---|---|---|
| 每天事件 | 120,000 | 40,000,000 |
| 每年原始数据 | 约 35 GB | 约 12 TB |
| 非结构化数据 | 没有 | 图片、日志 |
| 用原始历史做机器学习 | 不做 | 排序、反欺诈 |
| 选择 | 数据仓库 | 湖仓一体 |
怎么决定
选数据仓库,如果:
- 大部分数据是结构化的(事件、交易、CRM)。
- 主要使用者是分析师和看板。
- 你想要组件最少、托管的服务。
选湖仓一体,如果:
- 你有大量半结构化或非结构化数据(日志、文本、图片)。
- 数据科学和 BI 需要同一份数据。
- 你已经有数据湖并在往数仓复制,同步很痛苦。
- 你在意开放格式,避免被绑定。
无论哪种,难点都不在存储,而在治理:口径、负责人、权限和数据血缘。见数据治理和单一事实来源。
常见错误
- 建数据湖却没有目录和负责人。 很快变成没人信的沼泽。
- 数据又小又结构化,却因为流行而选湖仓一体。
- 「以防万一」所有东西存两份,却从不对账。
- 忽视个人数据。 原始区会攒下你并不需要的标识符,要在接入时就做最小化。
- 只按存储算成本。 算力、出网流量和工程时间才是大头。
把统计数据装进任何一种
在这两种架构里,产品和网站的统计事件往往都是最大的那张表。TapCub 通过原始数据导出把原始事件导出为 gzip 压缩的 JSONL,采集时已经做了 IP 截断和标识符哈希。把文件装进数仓的表,或者在湖仓里转成 Parquet,再和计费、CRM 数据关联。围绕这些加载任务该加哪些监控,见数据管道。
参考资料
- Armbrust, M., Ghodsi, A., Xin, R. and Zaharia, M. (2021). Lakehouse: a new generation of open platforms that unify data warehousing and advanced analytics. CIDR 2021.
- Inmon, W. H. (2005). Building the Data Warehouse, 4th ed. Wiley.
- Apache Software Foundation. Apache Iceberg documentation.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。