ETL 和 ELT 在结构上唯一的差别是转换在哪里跑,但它决定了你以后能不能回溯修改一个指标的口径。本文对比两者,演示排除机器人后把 13 个月的活跃用户按新口径重算,解释「全部原样装进来」的隐私代价,并介绍 EtLT 和反向 ETL。
读完你会知道
- ETL 先转换再加载;ELT 先原样加载再转换
- ELT 保留原始历史,口径可以回溯修改
- 原始数据存储很便宜,算力和治理才是真成本
- 在抽取时去掉个人数据:大多数管道其实是 EtLT
- 反向 ETL 把建好模的数据送回业务工具
一句话说清 ETL 和 ELT
ETL(抽取、转换、加载)在装进目标库之前清洗和整理数据;ELT(抽取、加载、转换)先把原始数据装进去,再在目标库里面转换,目标库通常是云数仓,转换用 SQL。区别在于「T」在哪里发生,而这决定了以后改口径有多容易、保留多少原始数据,以及哪些东西会进到你的数仓里。
两者都是搭建数据管道的方式。
两种方式怎么运作
ETL
- 从数据源抽取(业务数据库、CRM、统计事件)。
- 在单独的处理服务器上转换:清洗、去重、关联、汇总、遮蔽敏感字段。
- 把加工好的表加载进数仓。
ELT
- 从数据源抽取。
- 原样(或几乎原样)加载进数仓的原始表。
- 在数仓里用 SQL 模型转换成干净、可直接分析的表,常用 dbt 这类工具管理。
ETL 和 ELT 对比
| ETL | ELT | |
|---|---|---|
| 转换在哪里跑 | 进数仓之前的独立引擎 | 数仓里面 |
| 存了什么 | 只有转换后的数据 | 原始数据和转换后的数据 |
| 以后改口径 | 难:历史可能已经没了 | 容易:从原始表重建 |
| 加载速度 | 慢一些(先转换) | 快一些(先加载) |
| 计算成本 | 在 ETL 服务器上 | 在数仓上,模型重时会增长 |
| 敏感数据 | 能在进数仓之前去掉 | 不在入口处遮蔽,就原样进来 |
| 典型年代和工具 | 本地数仓;Informatica、SSIS、Talend | 云数仓(BigQuery、Snowflake、Redshift、ClickHouse);Fivetran、Airbyte + dbt |
| 适合 | 合规要求严、报表固定、数仓算力有限 | 指标经常迭代的分析团队;数据量大、种类多 |
| ETL | ELT | |
|---|---|---|
| 转换 | 进数仓之前 | 数仓里面 |
| 存什么 | 只有转换后的 | 原始 + 转换后的 |
| 以后改口径 | 难 | 容易 |
| 敏感数据 | 加载前去掉 | 不遮蔽就原样进来 |
成熟的管道大多是 EtLT:抽取时遮蔽,在数仓里建模。
计算示例:指标口径变了
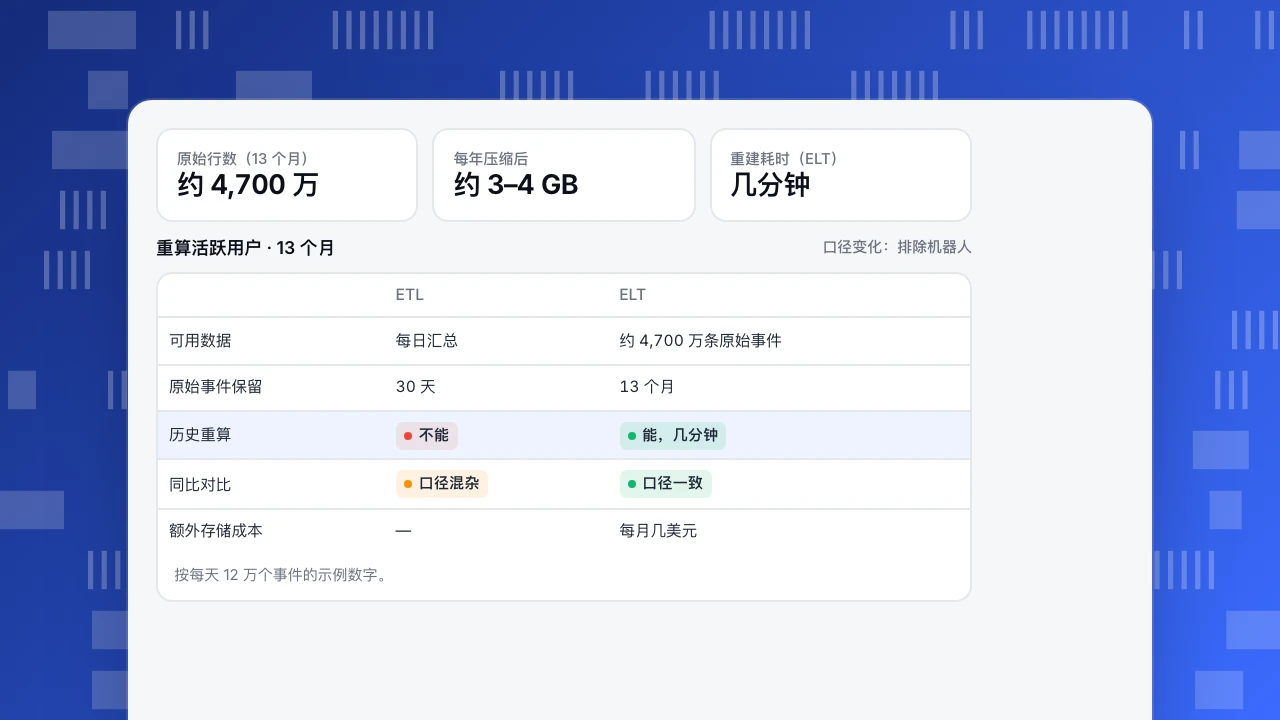
某产品团队把「活跃用户」定义为有任何埋点事件的人。一次机器人排查之后,他们改了定义,排除被标记为机器人和内部流量的会话,并希望把过去 13 个月都按新口径重算,这样同比才公平。
用 ETL 时,管道只加载了每日汇总(按国家和设备的每日活跃用户),背后的原始事件 30 天后就删了。新定义只能从今天开始用,历史没法重建:团队只能标注断点、小心对比。接下来 12 个月的同比增长里混着两种口径。
用 ELT 时,13 个月的原始事件都在数仓里(一个每天发 12 万个事件的产品,大约 4,700 万行)。改一个 SQL 模型、重跑一遍只要几分钟,每张图都能一路往回按新口径显示。这些原始数据的存储很小:压缩后一年大约 3–4 GB,按常见的对象存储价格每月几美元。真正的成本在数仓算力和治理上。
这正是分析团队转向 ELT 的主要原因:口径变化比任何人计划的都频繁,只有原始数据才能让你回溯修改。见原始数据和单一事实来源。
原始行数(13 个月)
约 4,700 万
每年压缩后
约 3–4 GB
重建耗时(ELT)
几分钟
重算活跃用户 · 13 个月
口径变化:排除机器人| ETL | ELT | |
|---|---|---|
| 可用数据 | 每日汇总 | 约 4,700 万条原始事件 |
| 原始事件保留 | 30 天 | 13 个月 |
| 历史重算 | 不能 | 能,几分钟 |
| 同比对比 | 口径混杂 | 口径一致 |
| 额外存储成本 | — | 每月几美元 |
按每天 12 万个事件的示例数字。
隐私上的坑,以及 EtLT
「全部原样装进来」也会把你未必需要的个人数据装进来:网址里的邮箱、IP 地址、表单里的自由文本。按 GDPR 的数据最小化原则,这是一种负担。
大多数成熟的管道其实是 EtLT:在抽取时做一层轻量但必须的转换(去掉或哈希标识符、截断 IP、删掉网址里的令牌),然后加载,再在数仓里做重的建模。先想清楚哪些数据绝不能进数仓,用代码强制执行,并记录在数据血缘里。
反向 ETL
反向 ETL(Reverse ETL)把建好模的数据从数仓送回业务工具:线索评分进 CRM,流失风险分群进邮件工具,账户健康度进客服系统。它让数仓里建立的干净口径,用到真正采取行动的地方。客户数据平台也承担了其中一部分工作。
怎么选
选 ELT,如果:
- 你用的是算力可伸缩的云数仓。
- 分析师会写 SQL,指标口径在不断演进。
- 你想保留原始历史,用于审计和重新处理。
选 ETL(或第一步很重的 EtLT),如果:
- 法规要求某些数据绝不能进入数仓。
- 目标系统算力有限,或下游系统需要固定格式的文件。
- 数据源太乱,原样加载会产生巨大而没法用的表。
实际中大多数团队会组合:SaaS 数据源用 EL 工具,在采集时做以隐私为重点的转换,在数仓里用 ELT 建模,再用反向 ETL 送回业务工具。
TapCub 在其中的位置
TapCub 在采集时、存储之前就做了隐私上关键的转换:IP 地址被截断,访客标识是加盐哈希,登录邮箱先转小写再哈希;机器人识别和渠道解析也在入口完成。所以它导出的事件很适合作为 ELT 的「原始层」:用原始数据导出把事件导出为 gzip 压缩的 JSONL(每个任务最多 365 日),装进你的数仓,和计费、CRM 数据一起建模。个人数据一开始就不要放进事件属性里,见不要把个人数据发进来。
另见:湖仓一体和数仓。
参考资料
- Reis, J. and Housley, M. (2022). Fundamentals of Data Engineering. O'Reilly, chapter 8.
- dbt Labs. What is ELT (extract, load, transform)?
- European Union. GDPR Article 5: principles relating to processing of personal data (data minimisation).
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。