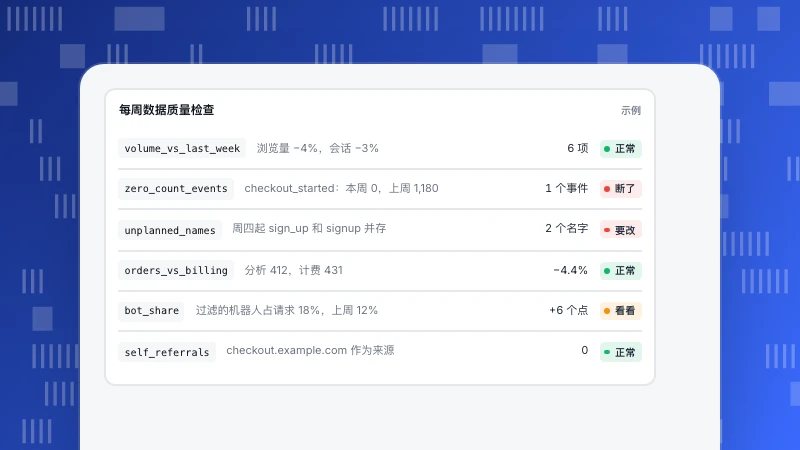
每一个统计数字都走过一条管道:采集、校验、清洗、补充、存储、查询。本文逐个讲六个阶段以及它们怎么出问题,比较批处理和流处理,并估算一条事件管道:重试、迟到的移动事件和丢失的脚本先后让看板失真,直到四条简单的监控把它们抓出来。
读完你会知道
- 管道分采集、接入、处理、存储和使用几个阶段
- 大多数看板错误都能追到管道的某一段
- 混合管道用流处理做实时,用批处理补迟到数据
- 业务事件按订单号这类唯一编号去重
- 监控新鲜度、数据量、拒收和结构,不只监控业务指标
什么是数据管道?
数据管道(Data Pipeline)是把数据从产生的地方搬到使用的地方、并在途中加工的一组自动化步骤。在数据分析里,管道接收网站、App 和服务端发来的原始事件,校验并清洗,补充信息(渠道、设备、地区),存储起来,再变成看板、告警和导出背后的那些表。
看板上的数看起来不对时,原因几乎总在管道的某一段:某个事件没到、重复了、一批数据晚到、某个属性改了名。弄清各个阶段,是排查统计问题最快的办法。
数据管道的各个阶段
| 阶段 | 发生什么 | 统计里的例子 | 典型故障 |
|---|---|---|---|
| 数据源 / 采集 | 数据产生并发送 | 浏览器脚本、移动 SDK、服务端事件、CRM | 广告拦截、用户同意、脚本没加载 |
| 接入 | 接收、校验、排队 | 采集端点接受或拒收请求 | 限流、请求格式不对、域名不符 |
| 处理 / 转换 | 清洗、去重、补充、关联 | 机器人过滤、UTM 解析、拼会话、身份合并 | 重复、时区错误、字段结构漂移 |
| 存储 | 写入数据库或数仓 | 事件表、每日汇总、用户档案 | 保留期限制、分区错误 |
| 使用 | 被报表、接口、导出、模型查询 | 看板、告警、SQL、原始数据导出 | 缓存过期、查询太慢 |
| 编排和监控 | 调度、重试、对管道本身告警 | 每日任务、新鲜度检查、量的异常告警 | 没人发现的静默故障 |
| 阶段 | 例子 | 典型故障 |
|---|---|---|
| 采集 | 网页脚本、SDK、服务端事件 | 脚本被拦或缺失 |
| 接入 | 采集服务校验请求 | 限流、请求格式错误 |
| 处理 | 机器人、UTM、会话、身份 | 重复、结构漂移 |
| 存储 | 事件表、汇总表 | 保留期、分区 |
| 使用 | 报表、SQL、导出 | 缓存过期 |
要监控管道本身:采集坏了,看起来就像流量下跌。
批处理和流处理
| 批处理 | 流处理 | |
|---|---|---|
| 怎么跑 | 按计划(每小时、每天)处理一批数据 | 持续地逐条或按微批处理 |
| 延迟 | 几分钟到几小时 | 几秒 |
| 适合 | 日报、计费、导出、复杂关联 | 实时看板、告警、风控、客服分配 |
| 复杂度 | 较低,容易重跑 | 较高,要处理顺序、迟到事件、恰好一次 |
| 常见工具 | Airflow、dbt、定时任务 + SQL | Kafka、Kinesis、Flink、Redis Streams |
大多数分析产品是混合的:事件以流的方式进来,供实时视图使用;批处理任务再生成每日汇总、补上迟到的数据。这就是「今天」的数字隔夜会小幅变化的原因。
ETL 和 ELT
两种经典模式的区别在于在哪里做转换:
- ETL(抽取、转换、加载): 先清洗整理,再装进数仓。存储更小更整齐,重新处理历史数据较难。
- ELT(抽取、加载、转换): 先把原始数据装进去,再在数仓里用 SQL 转换。保留了原始数据,口径变了可以重建表。现代云数仓常用这种方式。
计算示例:估算并检查一条事件管道
某 SaaS 产品每天从网页和 App 发送约 12 万个事件(示例数字)。
数据量。 原始 JSON 事件每条约 0.8 KB,一天 96 MB,一个月约 2.9 GB,一年约 35 GB(未压缩)。JSON 事件数据用 gzip 通常能压缩 8–12 倍,一年的导出也就几 GB。这个规模的网站,数据量很少是问题,正确性才是。
重复。 网络断了,移动 SDK 会重试。有一周 0.6% 的购买事件到了两次。没有去重键,收入就多算了 0.6%。每个购买事件带上订单号、按订单号去重,重复就消失了。
迟到数据。 1.8% 的 App 事件迟到了一小时以上(离线设备恢复联网后同步)。凌晨 00:30 跑一次、之后不再处理的每日任务,就把昨天少算了这么多。几小时后把前一天的汇总再跑一次,问题就解决了。
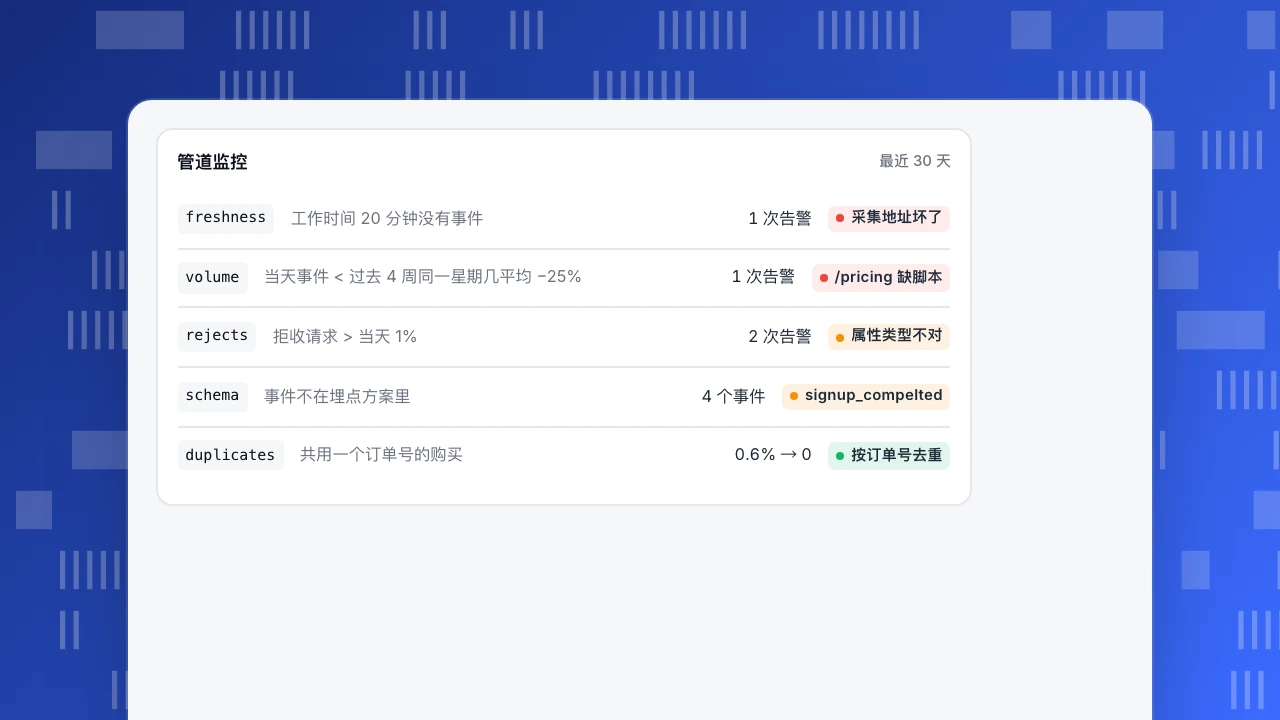
新鲜度和数据量检查。 团队给管道本身加了几条监控:
| 检查 | 规则 | 抓到了什么 |
|---|---|---|
| 新鲜度 | 工作时间内 20 分钟没有事件就告警 | 一次部署弄坏了采集地址 |
| 数据量 | 当天事件比过去 4 周同一星期几的平均低 25% 以上就告警 | 标签管理器的改动让定价页丢了脚本 |
| 拒收 | 被拒收的请求超过当天的 1% 就告警 | 新版 SDK 发了类型不对的属性 |
| 结构 | 出现埋点方案里没有的事件名或属性就告警 | signup_compelted 这类拼写错误 |
这些正是数据可观测性工具自动做的事:新鲜度、数据量、结构、分布和血缘。
管道监控
最近 30 天freshness工作时间 20 分钟没有事件1 次告警采集地址坏了volume当天事件 < 过去 4 周同一星期几平均 −25%1 次告警/pricing 缺脚本rejects拒收请求 > 当天 1%2 次告警属性类型不对schema事件不在埋点方案里4 个事件signup_compeltedduplicates共用一个订单号的购买0.6% → 0按订单号去重
数据管道的实践要点
- 先定义事件再采集。 埋点方案和数据字典能挡住大部分结构问题。
- 每一步都可以安全重跑。 同一天的任务重跑一次,结果应该一样,而不是翻倍。
- 业务事件带唯一编号(订单号、发票号),并按它去重。
- 时间戳用 UTC 存,查询时再换成报表时区。
- 原始数据保留一段明确的时间,这样能重建派生表。
- 注意基数。 有几百万个不同取值的属性(带会话 ID 的完整网址、自由文本)会撑大存储、拖慢查询。
- 监控管道本身,不只监控业务指标。 流量下跌和采集坏了,在看板上看起来一模一样。
- 尽早把个人数据挡在外面。 在采集时就去掉邮箱和令牌,后面再清就难多了。
TapCub 的数据管道
- 采集: 网页脚本、移动和小程序 SDK、服务端事件,也可以导入服务器日志。
- 接入: 采集服务校验每个请求。拒收发生在存储之前,数据质量页按原因和日期列出:域名不符、排除规则、月度额度、限流、请求格式错误和机器人。
- 处理: 机器人识别、渠道和 UTM 解析、会话、身份合并。
- 存储: 事件表和每日用户汇总。默认保留期:事件 365 日,自动采集 90 天,用户档案和同意记录各 730 天。
- 使用: 报表、SQL 查询、监控,以及 gzip 压缩的 JSONL 原始数据导出(每个任务最多 365 日,文件保留 48 小时),可以装进你自己的数仓。
购买事件要带上订单号,这样重试不会多出一笔订单。
参考资料
- Kleppmann, M. (2017). Designing Data-Intensive Applications. O'Reilly, chapters 10–11.
- Google Cloud. What is a data pipeline?
- Reis, J. and Housley, M. (2022). Fundamentals of Data Engineering. O'Reilly.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。