成熟度模型只有在告诉你下一步修什么时才有用。本文列出五个阶段和各自的瓶颈,把六个维度分开打分,并走一遍一次自评:平均分说是「第 2 阶段」,真正的发现却是工具(3 分)跑在了治理(1 分)前面,这让整个计划完全不同。
读完你会知道
- 成熟度从临时拼凑到报表、自助、预测、融入
- 阶段是累积的,工具跳不过基础
- 每个维度分开打分,找出最薄弱的环节
- 先修治理和质量,再加工具
- 用同一批人、同一套问题复评
什么是数据成熟度模型?
数据成熟度模型(Data Maturity Model)描述一个组织在采集、管理和使用数据上逐步进步要经历的阶段:从散落的表格,到数据左右日常决策和产品。它给出一套共同语言,说明你现在在哪里,帮你找出最薄弱的环节,并给出接下来先改什么的顺序。
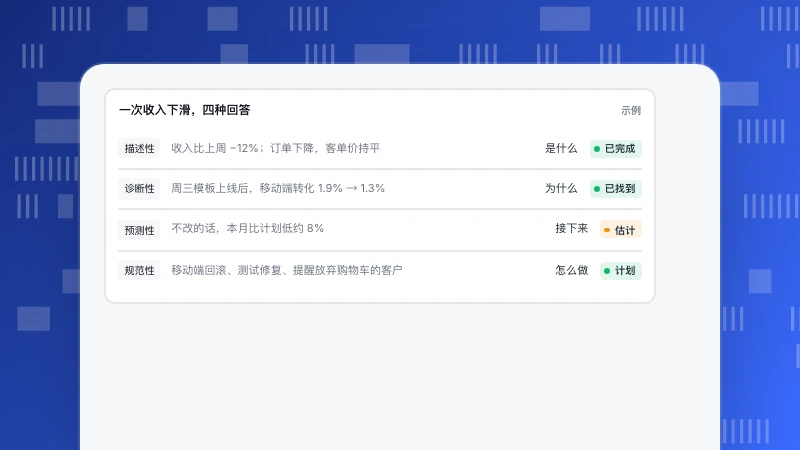
版本有很多:Davenport 和 Harris 的「分析竞争力五阶段」、Gartner 的分析成熟度等级、TDWI 的评估,以及 CMMI 研究院的数据管理成熟度模型。叫法不同,方向一致:从临时拼凑,到成体系,再到融入日常。
五个阶段
| 阶段 | 是什么样子 | 典型能回答的问题 | 主要瓶颈 |
|---|---|---|---|
| 1. 临时拼凑 | 数据在表格和工具默认报表里;开会时争论数字 | 「我们有多少访客?」 | 没有可靠的采集 |
| 2. 报表 | 有固定的看板和 KPI 报告,由少数人制作 | 「上个月发生了什么?」(描述性) | 各团队口径不同 |
| 3. 自助 | 口径统一,团队自己探索数据 | 「为什么发生?哪个分群?」(诊断性) | 技能和治理 |
| 4. 预测和实验 | 预测、倾向模型、对照实验 | 「会发生什么?什么有效?」 | 数据科学人手、干净的历史数据 |
| 5. 融入 | 数据嵌在产品和日常决策里,反馈闭环自动化 | 「应该做什么,能不能自动做?」(规范性) | 大规模下的文化和伦理 |
阶段是累积的:一家有机器学习模型、却没有统一「活跃用户」口径的公司,不在第 4 阶段,而是带着昂贵工具的第 2 阶段。
| 阶段 | 能回答的问题 | 瓶颈 |
|---|---|---|
| 1 临时拼凑 | 有多少? | 采集 |
| 2 报表 | 发生了什么? | 口径 |
| 3 自助 | 为什么?哪个分群? | 技能、治理 |
| 4 预测 | 会发生什么? | 数据科学、历史数据 |
| 5 融入 | 应该做什么? | 规模化下的文化 |
阶段是累积的。
要评估的六个维度
成熟度往往参差不齐,每个维度分开打分:
- 战略和目标: 有没有和业务目标挂钩的数据战略?
- 采集和质量: 有没有埋点方案,数据问题能不能在进报表之前被发现?
- 工具和架构: 数据能不能从来源流到需要它的人手里?
- 技能: 有多少人能自己回答自己的问题?
- 治理: 有没有负责人、口径、权限规则和隐私控制?见数据治理。
- 文化和决策: 是先看数据再做决定,还是做了决定再拿数据找理由?
计算示例:一次自评
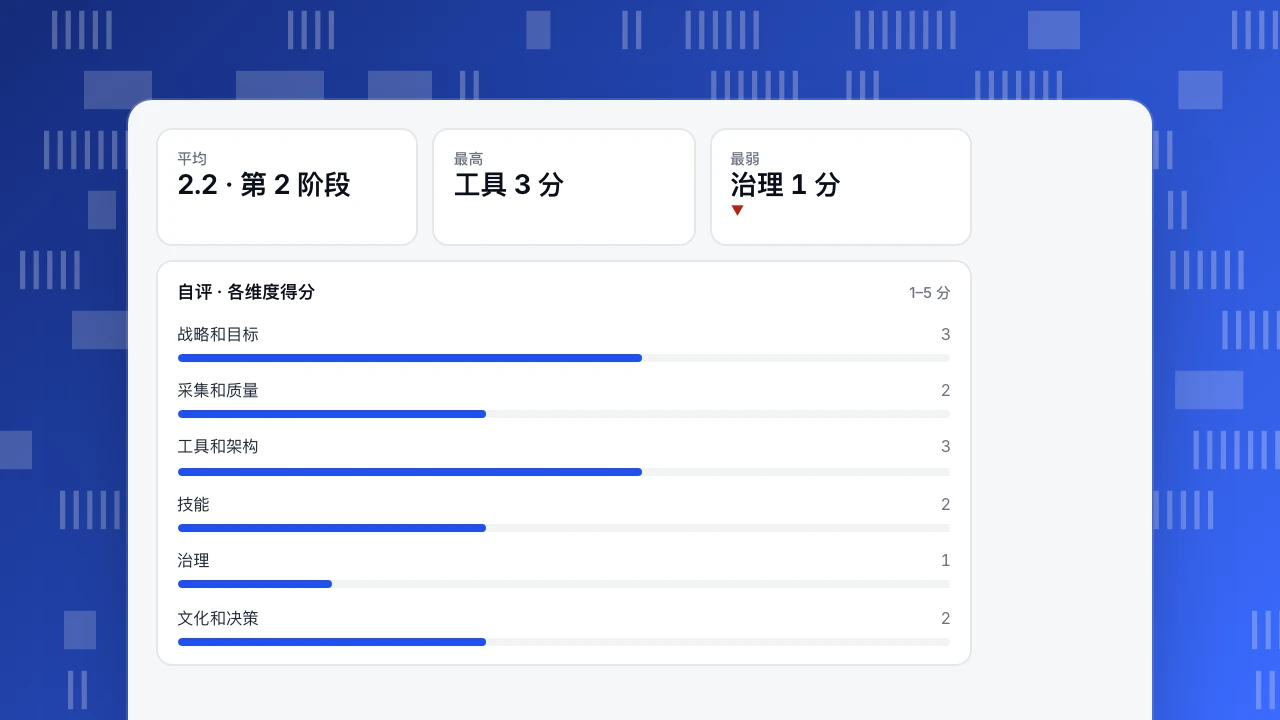
某 150 人的 SaaS 公司召集产品、市场、销售和财务的负责人开了一次研讨会,给每个维度打 1–5 分(示例数据):
| 维度 | 得分 | 依据 |
|---|---|---|
| 战略和目标 | 3 | 两个团队有数据目标,公司层面没有 |
| 采集和质量 | 2 | 没有埋点方案;注册事件有 14 个重复版本 |
| 工具和架构 | 3 | 有统计工具和数仓;没有共享指标 |
| 技能 | 2 | 所有问题都靠两个分析师 |
| 治理 | 1 | 没有负责人和口径;谁都能改看板 |
| 文化和决策 | 2 | 数据多用来在事后为决定找理由 |
| 平均 | 2.2 |
怎么读结果。 平均分说明处在「第 2 阶段:报表」。更有用的是分数的差距:工具 3 分,治理只有 1 分。公司在基础还没打好时就先买了工具;再加一个 BI 工具只会让问题更糟,冒出更多数字互相矛盾的看板。
接下来两个季度的计划针对最弱的两个维度:
- 治理 1 → 3: 给 15 个核心指标指定负责人,写进数据字典,每个团队认证一个看板,见单一事实来源。
- 采集和质量 2 → 3: 写埋点方案,合并重复事件,加上数据质量告警。
- 技能 2 → 3 会顺势提升:口径可信之后,培训产品经理自己建漏斗和留存报表,见数据民主化。
六个月后,用同一批人、同一套问题再打一次分。
平均
2.2 · 第 2 阶段
最高
工具 3 分
最弱
治理 1 分
▼
自评 · 各维度得分
1–5 分自评问题
| 维度 | 第 2 阶段的答案 | 第 4 阶段的答案 |
|---|---|---|
| 战略 | 每月汇报 KPI | 每个团队都有数据驱动的目标、负责人和复盘 |
| 采集 | 主要事件已埋点,缺口清楚 | 埋点方案强制执行,结构变更要评审 |
| 工具 | 看板集中在一个工具里 | 数仓、指标层、实验平台 |
| 技能 | 分析师替别人做报表 | 大多数经理自己查数据,数据科学家建模型 |
| 治理 | 部分口径写了下来 | 负责人、权限控制、数据血缘、隐私评审 |
| 文化 | 决定之后才看数据 | 决策从假设和指标开始 |
常见错误
- 想用工具跳过阶段。 在不可靠的数据上做机器学习,会得出信心满满的错误答案。
- 全公司只打一个分。 市场可能在第 4 阶段,财务还在第 2 阶段。
- 把成熟度当成目标。 目标是更好的决策,成熟度只是找出阻碍的办法。
- 自己给自己打分。 数据团队自评,往往高估工具、低估文化问题。
- 从不复评。 没有第二次测量,就无法判断计划有没有用。
用 TapCub 往上走一个阶段
在第 2、3 阶段,产品这一侧的成熟度主要靠可信的采集和统一的口径。TapCub 提供事件收件箱和埋点方案、数据质量页、在各报表间共享的自定义指标、用户分群和自助的漏斗。到了第 4 阶段,可以把原始事件导出到数仓,或者通过 AI 助手提问。
参考资料
- Davenport, T. H. (2006). Competing on analytics. Harvard Business Review, January 2006.
- Davenport, T. H. and Harris, J. G. (2017). Competing on Analytics, updated ed. Harvard Business Review Press.
- CMMI Institute (2014). Data Management Maturity (DMM) Model.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。