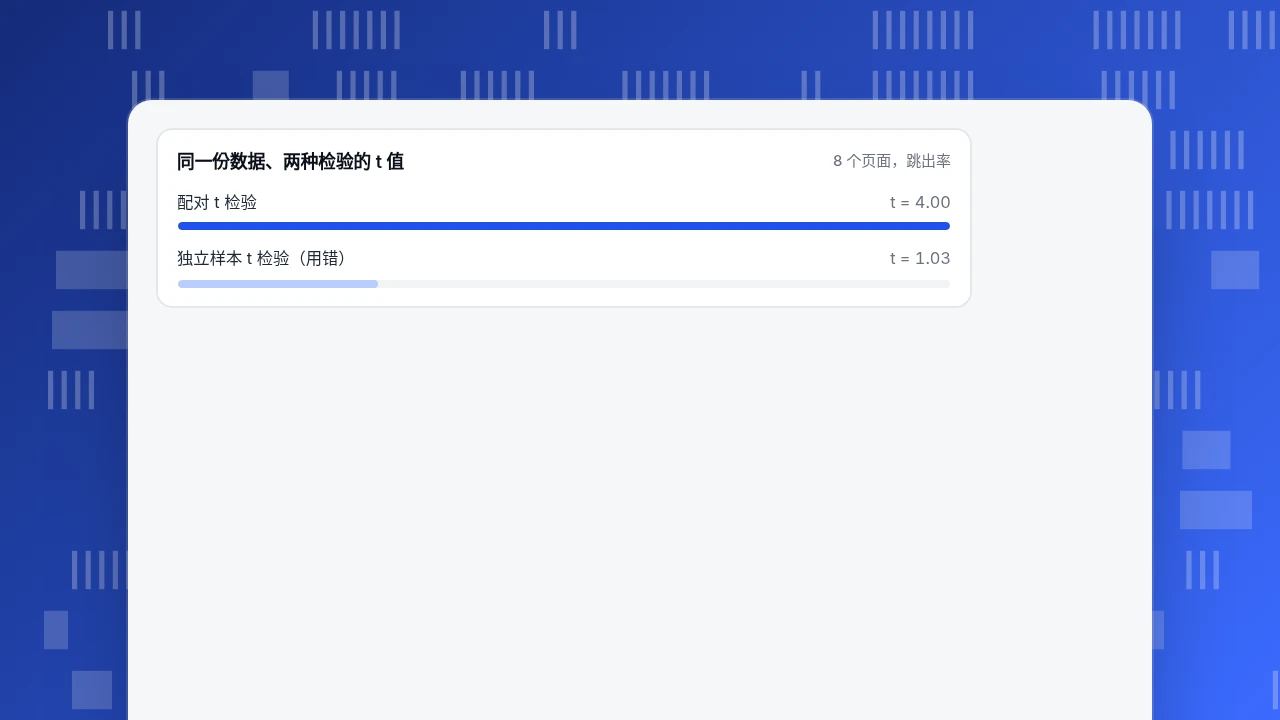
t 检验有三种:单样本检验(均值对一个固定数字)、独立样本检验(两个互不相关的组)和配对检验(同一批对象测两次)。要按数据怎么收集的来选,因为选错设计对结果的影响远大于显著性水平。下面的算例里,同一份数据用配对检验是 t = 4.00,用独立样本检验是 t = 1.03。
读完你会知道
- 按数据设计来选:一组对一个数字、两个独立的组,还是同一批对象测两次
- 独立样本检验默认用 Welch 版本,除非有理由假设方差相等
- 选错检验会翻转结论:同一份数据配对 t = 4.00,独立样本 t = 1.03
三种 t 检验一览
三种 t 检验都是比较均值,用的也是同一个 t 分布。区别在于数据长什么样,因此标准误由什么算出来。选哪种,要看数据是怎么收集的,而不是看哪个名字听着熟。
| 单样本 | 独立样本(双样本) | 配对 | |
|---|---|---|---|
| 回答的问题 | 这组的均值和一个固定数字有差别吗? | 两个互不相关的组,均值有差别吗? | 同一批对象在两次测量之间变了吗? |
| 数据形状 | 一列数值加一个目标值 | 两列,对象互不相关 | 两列,每一行是同一个对象 |
| 实际检验的是 | 均值 − 目标值 | A 组均值 − B 组均值 | 逐行差值的均值 |
| 自由度 | n − 1 | Student:n₁ + n₂ − 2;Welch:估算得出 | n − 1(n 为配对数) |
| 常见分析场景 | 结账页加载时间的中位数还高于 2.5 秒的目标吗? | 邮件带来的订单金额比搜索带来的高吗? | 同样这些页面,改版后跳出率降了吗? |
有时还会把两个相关的检验也列成「类型」:Student t 检验是假设两组方差相等的独立样本检验,Welch t 检验是不做这一假设的独立样本检验。它们都是中间那一列的变体,下面有单独一节。检验本身的定义见 t 检验术语页;这篇只讲怎么在几种之间选。
怎么在三种之间选?
按顺序问三个问题,先符合的那条就是答案。
- 只有一组数据,要和一个数字比吗? 用单样本检验。这个「数字」必须来自数据之外:目标值、公开的基准、合同里的上限。上个月数据的均值不算固定数字,它是另一个样本。
- 一列里的每一行,都和另一列里的某一行一一对应吗? 同一批访客前后各测一次、同一批页面前后对比、刻意匹配的成对数据,用配对检验。
- 都不是,两组就是各自独立的对象,用独立样本检验,除非有理由相信方差相等,默认用 Welch 版本。
第 2 条有个快速检验:把顺序去掉。如果打乱其中一列,数据集仍然有意义,两组就是独立的;如果打乱会破坏行与行之间的对应,就是配对。
一个灰色地带的经验:两组样本量不同,就不可能是配对,因为配对要求两边行数相同。样本量相同也不自动等于配对,对应关系必须来自数据的收集方式。
| 你的数据 | 检验 | 先检查 |
|---|---|---|
| 一列数据加一个外部目标值 | 单样本 t 检验 | 目标值不是来自你自己的数据 |
| 两列,对象互不相关 | 独立样本 t 检验(Welch) | 两组的离散程度、样本量 |
| 两列,每一行是同一个对象 | 配对 t 检验 | 差值大致呈正态 |
| 每个访客的是 / 否结果 | 比例检验,不是 t 检验 | 每个格子里的计数 |
打乱其中一列仍然有意义的话,两组就是独立的。
单样本 t 检验:均值和目标值有差别吗?
示例数据:一家商店给结账页定的目标是 2.5 秒。连续 10 天,每天的加载时间中位数(秒)是 2.9、2.6、3.1、2.8、2.7、3.0、2.5、2.9、3.2、2.8。
- 均值 x̄ = 28.5 ÷ 10 = 2.85 秒
- 样本标准差 s = 0.217
- 标准误 = s ÷ √n = 0.217 ÷ √10 = 0.0687
- t = (x̄ − 2.5) ÷ 标准误 = 0.35 ÷ 0.0687 = 5.09,自由度 n − 1 = 9
- 双侧 p ≈ 0.0007;均值的 95% 置信区间是 2.69 到 3.01 秒
区间不含 2.5,和很小的 p 值一致。两者说的是同一件事:结账页的典型加载时间高于目标,高出约 0.35 秒。这个 p 值怎么读、它没有说明什么,见如何解读 p 值。
适用场景:单个指标对照目标、服务等级承诺,或别人公布的基准。不适用:拿这个月和上个月比。那是两个样本,用独立样本检验;如果两个月里是同一批对象,用配对检验。
独立样本 t 检验:Student 和 Welch
示例数据:订单金额(美元),10 笔来自邮件活动,11 笔来自搜索。
- 邮件:48、52、61、45、70、55、58、49、66、53 → 均值 55.70,标准差 8.06
- 搜索:41、47、39、52、44、50、38、46、43、45、42 → 均值 44.27,标准差 4.34
- 均值之差 = 55.70 − 44.27 = 11.43
两组标准差差了将近一倍,等方差的假设就很可疑。Welch 检验的标准误是 √(s₁²/n₁ + s₂²/n₂):
- 标准误 = √(8.06²/10 + 4.34²/11) = √(6.50 + 1.71) = 2.86
- t = 11.43 ÷ 2.86 = 3.99,Welch–Satterthwaite 自由度约 13.5
- 双侧 p ≈ 0.0014;差值的 95% 置信区间:5.3 到 17.6 美元
Student 版本把两组方差合并,假设它们相等。同样的数据,它给出 t = 4.10、自由度 19、p ≈ 0.0006。这里结论接近,是因为两组样本量差不多;当样本量悬殊、而且小的那组方差更大时,两个版本会明显不同。方差相等时用 Welch 几乎没有损失,方差不等时它能保护你,所以很多统计软件在两样本比较时把它设为默认。SciPy 的写法是 ttest_ind 的 equal_var=False。
这里只用 10 笔和 11 笔订单,是为了让算术可以自己核对。真实的订单金额往往右偏,样本小的时候,除了看 t,也要看数据本身。下面的前提假设一节会讲。
配对 t 检验:同一批对象测两次
示例数据:8 个落地页改版前后的跳出率(%)。
| 页面 | 改版前 | 改版后 | 差值 |
|---|---|---|---|
| 1 | 62 | 57 | 5 |
| 2 | 55 | 53 | 2 |
| 3 | 71 | 64 | 7 |
| 4 | 48 | 47 | 1 |
| 5 | 66 | 60 | 6 |
| 6 | 59 | 58 | 1 |
| 7 | 73 | 65 | 8 |
| 8 | 52 | 50 | 2 |
- 差值均值 d̄ = 32 ÷ 8 = 4.0 个百分点
- 差值的标准差 = 2.83
- 标准误 = 2.83 ÷ √8 = 1.00
- t = 4.0 ÷ 1.00 = 4.00,自由度 8 − 1 = 7
- 双侧 p ≈ 0.0052;平均降幅的 95% 置信区间:1.6 到 6.4 个百分点
8 个页面全都改善了。配对检验看得出这一点,因为它只处理这 8 个差值,不管各页面一开始彼此差多少。第 7 页起点是 73%,第 4 页是 48%,这个差距和「改版有没有起作用」这个问题无关。
选错检验会怎样?
假设把同样的跳出率数据误用独立样本检验。改版前一列均值 60.75,改版后一列 56.75,差距同样是 4.0 个百分点。听上去一样,但标准误现在由页面之间的差异算出来:
- 标准误 = √(8.94²/8 + 6.41²/8) = 3.89
- t = 4.0 ÷ 3.89 = 1.03,自由度约 12.7
- 双侧 p ≈ 0.32
数据相同、差距同样是 4.0 个百分点,结论却从「明确改善」变成「没有证据」。独立样本检验让页面之间的巨大差异淹没了信号。反方向的错误同样真实:对独立的两组做配对检验,等于假装行与行有对应,而实际并没有可利用的配对。
这就是选检验比选显著性水平后果更大的原因。把阈值从 0.05 挪到 0.01,只会改变临界结果的判断;选错设计,t 值直接差出约四倍。阈值本身怎么定、代表什么,见统计显著性。
同一份数据、两种检验的 t 值
8 个页面,跳出率t 检验有哪些前提假设?
每种 t 检验的前提清单都一样短。相信 p 值之前,逐条检查。
| 假设 | 含义 | 怎么检查 | 不满足时 |
|---|---|---|---|
| 独立性 | 一个样本内的观测互不影响(配对时:各对之间互相独立) | 想清楚数据怎么收集的:重复访客、同一客户出现在两行 | 检验前先汇总成每人或每个对象一行 |
| 均值近似正态 | 均值的抽样分布接近正态 | 直方图或 Q-Q 图;每组 n 大于约 30 时,均值通常表现良好 | 加数据、做变换(例如订单金额取对数),或用基于秩的检验 |
| 方差相等(仅 Student) | 两组离散程度相同 | 比较标准差;比值超过约 2 就是警告 | 改用 Welch 检验 |
| 没有极端异常值 | 几个离谱的值不会拉动均值 | 把数据排序,看头尾 | 先查清这些值;不要为了得到结果而删掉它们 |
| 连续型测量 | 数值本身适合求平均 | 看指标本身 | 对「是否转化」这类是 / 否结果,比例检验更合适,例如卡方检验 |
配对数据的正态性假设针对的是差值,不是原始的两列数据。
单侧还是双侧?
双侧检验问的是「任一方向上有没有差别」,这篇文章里的 p 值都是双侧的。单侧检验问的是「是否特别地更大」或「特别地更小」,数据朝预测方向走时,p 值减半。
- 在看到数据之前选好方向,并写下来。
- 如果相反方向的效果也会让你采取行动,就用双侧。
- 双侧检验结果是 0.07,不要事后改成单侧。那等于悄悄把显著性水平翻了一倍。
在跳出率的例子里,改版让页面变差和变好同样重要,所以双侧才是诚实的选择。
结果该怎么汇报?
单独一个 p 值只说明在「没有效应」的前提下数据是否出人意料,并不说明效应有多大。按这个顺序汇报四样东西:
- 差异的大小,用指标自己的单位:「跳出率下降 4.0 个百分点」。
- 95% 置信区间:「1.6 到 6.4 个百分点」。
- 用了哪种检验、为什么:「配对 t 检验,同样 8 个页面的改版前后」。
- p 值:「p ≈ 0.005」。
1.6 到 6.4 的区间告诉读者,降幅是真实的,也告诉他们这个降幅可能小到没有商业意义。标准化效应量见效应量,区间怎么算见如何计算置信区间。
t 检验的常见误区
- 对同一批对象的前后数据用独立样本检验。 上文已演示:t 是 1.03,而不是 4.00。
- 把很多次浏览当作很多个观测。 一个访客产生 5 行,只算 1 个观测,带着 5 个彼此相关的值。先按访客汇总。
- 做很多次 t 检验,只汇报有结果的那次。 在 0.05 水平上检验 20 个细分,仅靠偶然就会出现约 1 次假阳性(20 × 0.05 = 1)。看数据之前先定好要做哪些比较。
- 对计数很小的比率用 t 检验。 40 个访客上 2% 的转化率,只是一个小组里的 1 次转化;比例检验才是合适的工具。
- 把「不显著」当成「没有差别」。 样本小,很容易检测不出真实存在的效应。看区间:区间宽,意思是「现在还不知道」。
- 看过数据再改成单侧。 上一节已经讲过。
检验怎么变成决策的更大图景,见假设检验。
怎么用 TapCub 的数据做 t 检验
TapCub 不做 t 检验,不计算 p 值和置信区间。它提供的是要检验的数据,以及正确设计对比所需的背景。仍以上面的结账页为例。
- 取指标。 真实用户的页面性能在 监测 › 性能。单样本例子里那 10 个每日数值,在这里读取结账页你所跟踪的加载指标的每日值。
- 需要行级数据时去取。 独立样本和配对设计需要每笔订单或每个页面一个值。用 全端分析 › 行为分析 › 自定义指标与 SQL 查询事件,或用 全端分析 › 数据管理 › 数据导出 做异步导出拿原始明细。超过保留期的明细已经删除,所以需要之前先导出。
- 标出变更。 在 配置 › 日期标注 给改版或活动上线日加一条标注,改版前后的时间段就不用事后猜。
- 选设计。 同样的页面前后对比用配对检验;两个不同活动的订单用独立样本检验。先定好,再运行任何东西。
- 在 TapCub 之外做检验,用表格或 Python,把效应量和区间记在标注旁边。
TapCub 的工作到数字为止。检验和决定由你来做。
常见问题
t 检验有哪三种?
单样本 t 检验把一组的均值和一个固定值比较。独立样本(双样本)t 检验比较两个互不相关的组的均值。配对 t 检验通过检验差值的均值,来比较同一批对象的两次测量。Student 和 Welch 是运行独立样本检验的两种方式。
Student t 检验和 Welch t 检验有什么区别?
两者都比较两个独立的组。Student 合并方差并假设相等,自由度是 n₁ + n₂ − 2。Welch 保持方差各自独立,自由度是估算出来的。Welch 是更稳妥的默认选择,方差相等时几乎没有损失,不等时能起保护作用。
什么时候该用配对 t 检验而不是独立样本检验?
一组的每一行都和另一组的某一行对应时用配对:同一批访客或页面测两次,或刻意匹配的成对数据。如果打乱其中一列也不影响意义,两组就是独立的。配对设计通常检验力更强,因为它消除了对象之间的差异。
样本很小时能用 t 检验吗?
可以,t 分布本来就是为小样本设计的,但数据必须大致呈正态,因为数据太少,靠求平均来纠正偏态是指望不上的。观测不到约 15 个时,先看图,对结果持谨慎态度。置信区间很宽,就是诚实的信息。
t 检验是单尾还是双尾?
两种都可以。双尾检验检测两个方向上的差别,是默认选择。单尾检验只看预先选好的一个方向,p 值减半。方向要在收集或看到数据之前选好,不能在双尾结果临界之后再选。
资料来源
- NIST/SEMATECH e-Handbook of Statistical Methods。Two-sample t-test for equal means:检验统计量、合并方差和方差不等两种形式、自由度。核对于 2026-11-19。
- NIST/SEMATECH e-Handbook of Statistical Methods。Paired comparisons:为什么配对能消除对象之间的差异。核对于 2026-11-19。
- SciPy 文档。scipy.stats.ttest_ind:用
equal_var参数区分 Student 和 Welch。核对于 2026-11-19。 - SciPy 文档。scipy.stats.ttest_rel:配对样本 t 检验。核对于 2026-11-19。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
