解读 t 检验结果,先读差值,再读它的置信区间,最后读 p 值;t 和自由度只是中间过程。示例 A/B 测试里,0.12 页的提升对应 p = 0.0056、95% 区间 0.035 到 0.205:明显为正,但可能很小。下面把输出里每一行都复算并解释,还有一个不显著的案例和一个显著但微小的案例。
读完你会知道
- 先读差值,再读区间,最后读 p 值;区间显示效应可能有多大,这是 p 值单独做不到的
- 区间很宽的不显著结果是没有结论,不是没有效果的证据
- 样本巨大时,微小的差异也会得到极小的 p 值;要用对你有意义的大小来判断
t 检验的结果到底在告诉你什么?
t 检验的结果告诉你:两组平均值之间的差距,是否大于单靠随机波动就能出现的大小。它检验的原假设是两个总体均值相等。读输出时按这个顺序:先看差值(有多大),再看置信区间(有多确定),然后是 p 值(在「没有差异」的前提下有多意外),最后才是 t 统计量和自由度,它们只是算出其他数字的中间过程。
多数指南先讲 p 值,最后讲区间。做决定时反过来更好:差值和它的区间,回答的是产品或市场团队真正在问的问题:「好了多少,我能相信到什么程度?」p 值回答的是更窄的问题。如果你需要 p 值本身的定义,词条 p 值里有,不同的检验类型(单样本、双样本、配对)在 t 检验类型里讲。本页拿一份真实的输出,一行一行读。
真实的 t 检验输出长什么样?
示例数据:一个网站用新页面布局和旧布局做对比,比较每次会话的浏览页数。Welch 双样本 t 检验(不假设方差相等)给出:
Welch 双样本 t 检验:每次会话浏览页数
  对照组:   n = 4,000   均值 = 3.10   标准差 = 1.90
  变体组:   n = 4,100   均值 = 3.22   标准差 = 2.00
  差值(变体 - 对照)            = 0.12
  标准误                         = 0.0433
  t                              = 2.769
  自由度                         = 8,092.3
  p 值(双侧)                   = 0.0056
  差值的 95% 置信区间            = [0.035, 0.205]
这里每个数字都能由前两行复算出来。标准误是 √(1.90² ÷ 4,000 + 2.00² ÷ 4,100) = √(0.000903 + 0.000976) = 0.0433,t = 0.12 ÷ 0.0433 = 2.769。公式用的是 NIST《工程统计手册》里给出的均值相等的双样本 t 检验公式,包括 Welch-Satterthwaite 自由度。
每一行怎么读?
| 行 | 它是什么 | 对示例的通俗解读 |
|---|---|---|
| n、均值、标准差 | 组大小、平均值、离散程度 | 每组约 4,000 次会话;变体用户平均多看 0.12 页 |
| 差值 | 变体均值减对照均值 | 变体高 0.12 页,在 3.10 的基础上是 3.9% 的相对提升 |
| 标准误 | 差值的典型抽样噪声 | 把测试重做一遍,差值通常会变动约 0.04 页 |
| t | 差值除以标准误 | 差值离零有 2.77 个标准误 |
| 自由度 | 检验用了多少信息 | 8,092 接近会话总数,所以 t 分布几乎就是正态分布 |
| p 值 | 如果真实均值相等,出现这么大差距的概率 | 0.0056 表示光靠运气,大约每 180 次测试才会出现一次这么大的差距 |
| 95% 置信区间 | 与数据相符的差值范围 | 真实的提升可能是 0.035 到 0.205 页之间的任何值 |
有两个细节容易绊人。其一,区间不含零,和 p < 0.05 是同一个说法:当双侧检验在 0.05 水平上拒绝原假设时,95% 区间恰好不包含零。区间携带更多信息,因为它显示了大小。其二,Welch 检验的自由度通常不是整数。NIST 自己的例子给出 T = −12.62、326 个自由度,0.05 双侧检验的临界值为 1.9673;自由度是 8,092 时临界值是 1.9603,这就是上面的区间用 1.960 × 0.0433 = 0.085 作为 0.12 两侧宽度的原因。
| 输出的行 | 回答什么问题 |
|---|---|
| 差值 | 差距有多大? |
| 95% 置信区间 | 哪些差距与数据相符? |
| p 值 | 如果均值相等,这个结果有多意外? |
| t 和自由度 | 是什么算出了 p 值和区间? |
从上往下读;最后一行只是中间过程。
怎么判断结果意味着什么?
按顺序回答四个问题:
- 区间是否完全在零的一侧? 如果是,方向就明确了。这里 0.035 到 0.205 在零之上。
- 整个区间值得行动吗? 事先定好有意义的最小提升,比如 0.10 页。这里区间下端(0.035)低于它,所以即使结果显著,也不能排除提升小于你在意的程度。
- 测试是怎么做的? 事先定好的固定样本量、一个主要指标、只看一次结果,是 p 值所假设的条件。
- 说得通吗? 布局调整带来每次会话 3.9% 的页数增长是可信的。如果改个颜色就涨 40%,就该先检查是不是有 bug。
示例通过了第一项,部分通过第二项,第三项需要你做决定。这样的结论比「显著」更有用。
显著、不显著和微小的结果各是什么样?
同一类测试的三次运行,显示各个部分是怎么变化的。都是示例数据,用 Welch 方法复算。
| 情形 | 分组 | 差值 | t | 自由度 | p | 95% 区间 | 效应量(d) |
|---|---|---|---|---|---|---|---|
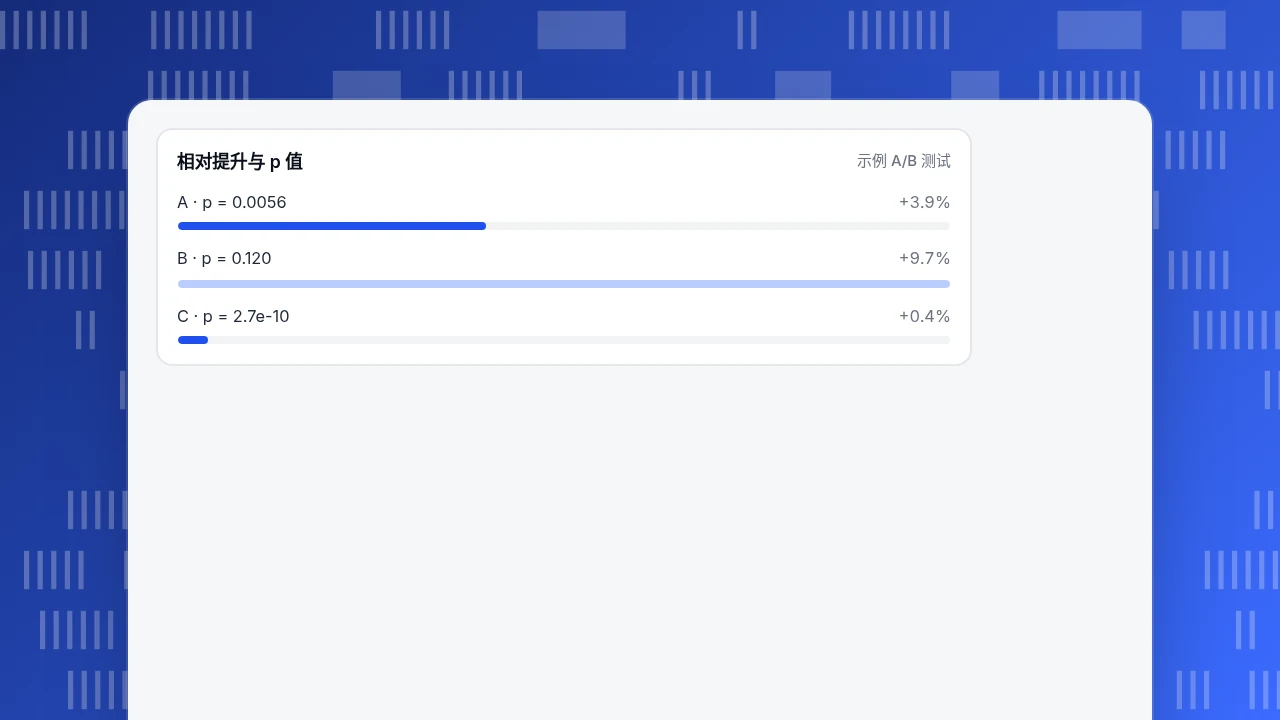
| A:中等样本 | 4,000 和 4,100 次会话,3.10 对 3.22 | 0.12 | 2.77 | 8,092 | 0.0056 | 0.035 到 0.205 | 0.06 |
| B:小样本 | 200 和 210 次会话,3.10 对 3.40 | 0.30 | 1.56 | 408 | 0.120 | −0.079 到 0.679 | 0.15 |
| C:超大样本 | 各 2,000,000 次,3.100 对 3.112 | 0.012 | 6.32 | 3,999,998 | 2.7 × 10⁻¹⁰ | 0.0083 到 0.0157 | 0.006 |
这里的效应量是差值除以合并标准差(Cohen's d)。
- 情形 B 不是「没有效果」。 它的差值(0.30)比 A 还大,但区间从 −0.079 到 0.679,数据与从小幅下降到大幅提升的任何情况都相容。它是没有结论,而不是负面结论。
- 情形 C 是「显著」但几乎没用。 每组两百万次会话,0.012 页的差异(0.4%)得到约 10⁻¹⁰ 的 p 值。区间显示整个范围都在 0.016 页以下。统计显著和实际重要,是两回事。
相对提升与 p 值
示例 A/B 测试p 值没有告诉你什么?
美国统计协会 2016 年关于 p 值的声明列出了六条原则。其中三条对读 t 检验很重要:
- p 值不衡量你所研究的假设为真的概率,也不衡量数据仅由随机性产生的概率。p = 0.0056 并不表示这个布局没有效果的概率是 0.56%。
- p 值,或者说统计显著性,不衡量效应的大小或结果的重要性。情形 C 直接说明了这一点。
- 单靠 p 值,并不能很好地衡量模型或假设的证据,结论不应只取决于 p 值是否越过某个阈值。
所以汇报时要连同差值和区间一起给出 p 值,不要只给 p 值,并说明做的是什么检验。
你本该用哪种 t 检验?
上面的输出是对独立两组的双样本检验,用的是 Welch 版本。信任任何 t 检验结果之前,先查三件事:
- 独立还是配对? 如果同一批用户出现在两组里(前后对比),要用配对检验;对配对数据用独立检验,标准误会算错。
- 方差相等吗? 方差相等的版本会合并标准差,自由度用 N1 + N2 − 2。Welch 版本不需要这个假设,NIST 说它对样本量不等和方差不等都比较稳健。拿不准就用 Welch。
- 单尾还是双尾? 看数据之前就定好。双侧检验问的是均值在任一方向上是否不同,是安全的默认选择。
t 检验什么时候会误导你?
- 偏态指标。 每位访客的收入有很多零和少数大值。样本大时 t 检验通常仍然合理,但样本小时,平均值会被一个离群值带偏。先看分布,考虑变换或换一种检验。
- 重复的用户。 如果一个人贡献了很多次会话,这些会话就不是独立的。要按用户来分析。
- 偷看。 每天看 p 值,一低于 0.05 就停,会让假阳性率远高于 5%。事先固定样本量或停止规则。
- 指标太多。 在 0.05 水平上测二十个指标,大约有一个会因为运气显得显著。只选一个主要指标。
- 定义变化。 如果「会话」的定义在中途改了,两组就没有可比性。
用 TapCub 怎么做
TapCub 不做 t 检验,也不为实验分流;它提供的是进入检验的各组数字。以布局的例子来说:
- 在 全端分析 › 行为分析 › 行为分析 里,打开分布视图,把每次会话浏览页数作为对象。你会得到该时段均值和中位数的直方图,在检验之前就能看到偏态。
- 实验本身在你自己的工具里跑,并发送一个事件或属性,记录每个访客看到的是哪种布局。TapCub 不把访客分配到变体。
- 在 全端分析 › 行为分析 › 自定义指标与 SQL 里,打开 SQL 标签(SQL 查询台),查询事件数据,按变体返回会话数和平均每次会话浏览页数。标准差是每组需要的第三个数字:如果你的 SQL 支持,就在查询里算;否则到 全端分析 › 数据管理 › 数据导出 导出明细,在外面算。
- 把这些数字放进任何统计工具,或者用上面的公式算。TapCub 报告均值和数量;p 值在它之外计算。
- 在 配置 › 日期标注 里标出测试的开始和结束,让后来的人知道两组覆盖的是哪几天。
FAQ
怎么解读 t 检验结果?
先读差值,再读它的置信区间,最后读 p 值。如果 95% 区间不含零,结果在 0.05 水平上显著,而区间还显示效应可能有多大。示例里,0.12 页、区间 0.035 到 0.205,明显为正,但可能很小。
t 检验里 p 值等于 0.05 是什么意思?
表示如果两个总体均值相等,大约 5% 的测试里会出现至少这么大的差距。它不是原假设为真的概率,也不说明效应的大小。
多大的 t 值算好?
单独的 t 值没有好坏。重要的是 t 相对于你的自由度对应的临界值:样本大时 0.05 双侧检验约 1.96,NIST 的例子在 326 个自由度时是 1.9673。绝对值越大,p 值越小。
t 检验里的自由度是什么意思?
它决定 t 分布的形状,取决于你有多少数据。假设方差相等时是 N1 + N2 − 2。Welch 检验根据样本方差和大小算出一个带小数的值,所以你会看到 8,092.3 这样的数字。
结果可以显著但不重要吗?
可以。在情形 C 里,每组两百万次会话,让 0.012 页的差异高度显著(p 约 2.7 × 10⁻¹⁰),而整个区间都在 0.016 页以下。要始终看差值的大小,而不只是 p 值。
资料来源
- NIST/SEMATECH。Two-sample t-test for equal means,统计方法电子手册:检验统计量、Welch-Satterthwaite 自由度、拒绝域,以及 T = −12.62、ν = 326 的例子。核对于 2026-11-20。
- 美国统计协会。关于统计显著性和 p 值的声明(新闻稿,2016 年 3 月 7 日):六条原则;Wasserstein 和 Lazar 的完整声明见 The American Statistician。核对于 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
