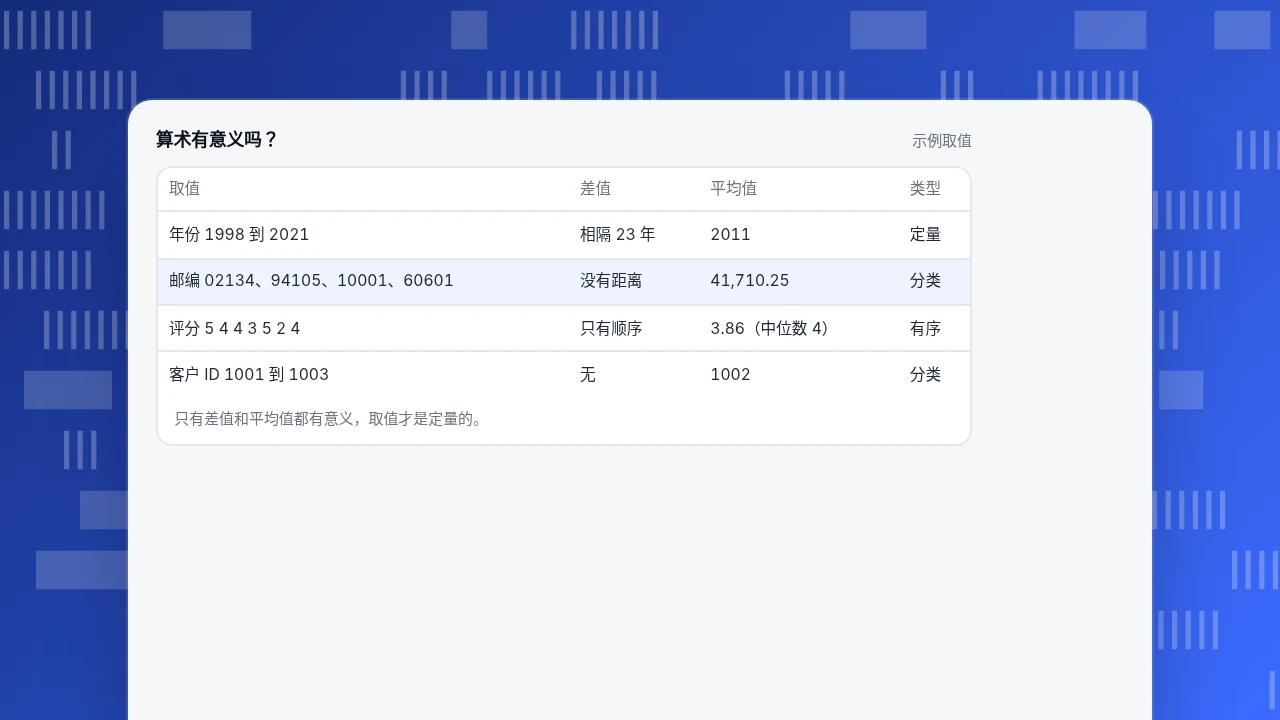
年份用于差值、平均值或随时间的趋势时是定量变量,只用来给分组命名(比如 2019 款)时是分类变量。判断办法:只有对数字做算术有意义,它才是定量的。2021 − 2012 = 9 年是一段真实的间隔;邮编 02134、94105、10001 和 60601 的平均值是 41,710.25,它不是任何地方。下面是三问测试、年份、邮编、评分和 ID 的判断表,以及一个算例。
读完你会知道
- 年份做差值和趋势时是定量变量(区间量表),当作分组标签时是分类变量
- 邮编和 ID 是标签:存成文本,不求平均,也别丢掉前导零
- 按用途给派生列命名,比如 signup_year 和 years_since_signup,让类型一目了然
年份是分类变量还是定量变量?
年份两种都可以,具体是哪一种,取决于你拿它做什么,而不是因为它是用数字写的。当你要看距离、平均值或随时间的趋势时,把它当作定量变量:「这些客户加入的时间相隔 9 年」「销售额每年大约增加 1 万美元」。当它只是一个分组的标签时,把它当作分类变量:「2019 款」「2024 届」「财年」。同一列年份可以在同一次分析里两种都用;关键是每一步在问什么问题。
教科书的定义说得很准确。Minitab 的帮助把分类变量的取值定义为互斥的类别或分组,把定量变量的取值定义为通常表示计数或测量的数字。它的例子里有「1 表示同意、2 表示中立」这样的调查编码,数字在那里只是分组的标签。词条分类变量和数据类型讲了这些术语;本页给你一个一分钟内就能做决定的办法,以及一张涵盖年份、邮编、评分和 ID 的表。要记住的主张是:只有当对一个数做算术有意义时,它才是定量的;否则它就是一个碰巧用数字写出来的标签。
三个问题的测试是什么?
按顺序问这三个问题,遇到第一个「否」就停。
- 差值有意义吗? 2021 − 2012 = 9 年是一段真实的间隔。94105 − 02134 不是任何东西的距离。
- 平均值有意义吗? 1998、2005、2012、2019 和 2021 这几个年份的平均值是 2011,是时间上的一个中点。邮编 02134、94105、10001 和 60601 的平均值是 41,710.25,它不是一个地方。
- 把标签换掉会改变答案吗? 如果你可以把数字换成字母或颜色,分析仍然完全一样,那它从头到尾就是标签。提出四种测量水平的 Stevens 举过给橄榄球运动员编号的例子:数字只用作标签,换成文字或字母同样可以。
三个问题都通过,就是定量变量。只通过第一个,通常是有序或区间变量,取决于间隔是否均匀。一个都没通过,就是分类变量。
| 取值 | 类型 | 怎么处理 |
|---|---|---|
| 作为日期的年份 | 定量(区间) | 数值:差值和趋势,不取比值 |
| 作为分组标签的年份 | 分类 | 分组:每年一根柱子 |
| 邮编、ID、电话 | 分类(名义) | 文本:分组计数,不求平均 |
| 1 到 5 的评分 | 有序 | 分布和中位数;谨慎用均值 |
同一列可以两种用法都有;按每个问题来决定。
为什么年份是区间量,而不是比例量?
Stevens 1946 年的论文《On the Theory of Scales of Measurement》(Science 103: 677–680)按「哪些变换不改变其意义」来区分量表。日历日期是他举的零点任意的量表的例子:一种历法上的日期,用同一个线性方程 x' = ax + b 就能换成另一种历法上的日期,而说一个值是另一个值的两倍或其他比例,是没有意义的。公元 2000 年并不是公元 1000 年的「两倍」。而时间段,比如 9 年,可以在比例量表上测量。
这给了年份一条实用规则:
- 差值没问题。 注册时的年龄、任期、「上线以来的年数」。
- 年份之间的比值不行。 不要拿 2024 去除以 2012。
- 平均值作为中点没问题, 而均值和标准差正是 Stevens 与区间量表联系在一起的统计量。
- 如果你要比值, 就换成一段时间:自某个起点以来的年数,或者年龄。
年份、邮编、评分和 ID 怎么对比?
| 取值 | 例子 | 类型 | 原因 | 怎么处理 |
|---|---|---|---|---|
| 作为日期的年份 | 2012、2021 | 定量(区间) | 差值和趋势有意义;零点是任意的 | 保持数值;用差值和斜率;不要取比值 |
| 作为分组标签的年份 | 2019 款、2024 届 | 分类 | 年份只是给一个组命名;没有算术的意图 | 计数、比较各组、每年一根柱子 |
| 年龄或自起点以来的年数 | 37、9 | 定量(比例) | 零表示没有;比值有意义 | 平均、比值、回归 |
| 邮编 | 02134、94105 | 分类(名义) | 投递区域的标签;算术没有意义 | 存成文本;分组;绝不求平均 |
| 1 到 5 的评分 | 4 | 有序 | 顺序是真实的;间隔不一定相等 | 展示分布和中位数;谨慎用均值 |
| ID | 1001、1002 | 分类(名义) | 用来识别,不用来测量 | 存成文本;数不同值的个数 |
| 电话号码 | 5551234 | 分类(名义) | 一种标识符 | 存成文本 |
邮编值得多说一句,因为它看起来像地理数据。美国人口普查局说,ZIP Code 是与投递点绑定的离散地址,是一个基于点的数据集,不适合制图和许多分析应用;它的 ZIP Code 制表区(ZCTA)是由普查区块生成的概括性面状表示,而且并非每个有效的 ZIP Code 都有对应的 ZCTA。如果你需要一个区域,用 ZCTA 及其定义,而不是原始的邮编。
算术有意义吗?
示例取值| 取值 | 差值 | 平均值 | 类型 |
|---|---|---|---|
| 年份 1998 到 2021 | 相隔 23 年 | 2011 | 定量 |
| 邮编 02134、94105、10001、60601 | 没有距离 | 41,710.25 | 分类 |
| 评分 5 4 4 3 5 2 4 | 只有顺序 | 3.86(中位数 4) | 有序 |
| 客户 ID 1001 到 1003 | 无 | 1002 | 分类 |
只有差值和平均值都有意义,取值才是定量的。
这个选择在真实分析里会改变什么?
示例数据:2019 年到 2023 年的年收入(千美元)分别是 100、112、95、130、141。
- 把年份当作定量变量。 穿过这五个点的最小二乘直线,斜率恰好是每年 +10(平均年份是 2021,平均收入是 115.6;拟合直线从 2019 年的 95.6 到 2023 年的 135.6)。一个数字就概括了趋势,而且可以外推:2024 年的估计值是 145.6。
- 把年份当作分类变量。 每一年都是自己的一组。相对 2019 年,差值分别是 0、+12、−5、+30 和 +41。这显示出直线抹平的 2021 年下滑,但对 2024 年一无所知,而且每年只有一个观测,也说不清这些差距是不是噪声。
两种都没有错。数值处理回答「趋势是什么?」,分类处理回答「每一年有什么不同?」。如果为问题选错了一种,就会出现悄无声息的错误:回归里用分类的年份,会得到每一年一个系数而没有趋势;「比较各组」的图里用数值的年份,会得到一个连续的坐标轴,缺失的年份留下空档。
这会造成哪些错误?
- 丢掉前导零。 把邮编 02134 读成数字,得到的是 2134,因为 int("02134") 就是 2134,你想要的文本就没了。载入文件时,把标识符列按文本读入。
- 对标识符求平均。 客户 ID 1001、1002 和 1003 的平均值是 1002,这个数字谁也识别不了。
- 把 1 到 5 的评分当作比例量表。 4 并不是 2 的两倍。评分 5、4、4、3、5、2、4 的均值 3.86 和中位数 4 在实践里都会出现;用任何一个时,都把分布一起报告。
- 对年份取比值。 「2024 年比 2012 年大 0.6%」是没有意义的算术。
- 让软件去猜。 看到数字的电子表格或库,往往会默认它是数值。画图或建模之前先检查类型。
- 中途切换。 如果你在一张图里把年份说成标签,在下一张图里又当作数量,要说明,否则读者会以为数据变了。
什么时候年份两者都是?
队列分析同时用到两者。「注册年份」这一列是分类的分组变量(每个队列一条线),而注册年份与当前年份的差,是这个队列的定量年龄。季节性是相关的情形:日历年份对趋势来说是数值,而月份是循环的标签,因为 12 月和 1 月是相邻的。
把两者分开的一个简单办法,是在数据里给它们起不同的名字:分组标签叫 signup_year,数量叫 years_since_signup。这样列名本身就带着类型。
用 TapCub 怎么做
TapCub 要求每个事件属性都有类型,这个决定就体现在这里。文档列出五种类型:String、Number、Boolean、Datetime 和 List。以上面的例子来说:
- 在 全端分析 › 数据管理 › 埋点方案 里,规划事件时就定义属性:名称、类型、是否必填和示例值。用于队列分组的
signup_year是 String 标签;years_since_signup是 Number。 - 邮编、ID 和电话号码按 String 发送。属性分布只读取能解析成数字的值,并按从最小值到第 99 百分位的等宽区间分桶,所以按 Number 发送的邮编,会被画成一张毫无意义的邮编直方图。
- 在 全端分析 › 数据管理 › 属性字典 里,检查已有属性的 类型 列,分布在 事件、用户 和 账户 标签页。文档提醒,类型错了会让求和和筛选出错,而且一旦你保存了编辑,之后的扫描不会覆盖这个类型。要在这里修正不一致,而不是在每张图里修。
- 在同一个字典里,给必须保持文本的属性(比如
zip_code)加一条带预期类型的校验规则。违规时可以只警告、丢弃属性或拦截事件,所以混进来的数字会在接收时被发现。 - 在 全端分析 › 行为分析 › 行为分析 里,对 Number 属性(比如注册以来的年数)使用分布视图,看它的形状、均值和中位数。要看分组,就用 事件分析,按套餐或国家这类维度拆分。
TapCub 无法知道一个数字是测量值还是标签;由你来声明,所以在埋点之前就定好类型。
FAQ
年份是分类变量还是定量变量?
看用途,两者都可以。作为日期或年龄,用来做差值和趋势,它是定量的(区间)。作为分组标签,比如 2019 款,它是分类的。问一下对这些值做减法和求平均有没有意义。
邮编是分类变量还是定量变量?
分类变量。邮编标记的是一个投递区域;把邮编相加或求平均没有意义,存成数字还会丢掉前导零(02134 变成 2134)。人口普查局指出,ZIP Code 与投递点绑定,不是区域。
1 到 5 的评分是分类变量还是定量变量?
它是有序变量:顺序是真实的,但间隔不一定相等,4 也不是 2 的两倍。展示分布和中位数,谨慎使用均值。
ID 号是分类变量还是定量变量?
分类变量。ID 用来识别一条记录,不测量任何东西;对它做算术没有意义,Stevens 论文里给橄榄球运动员编号的例子就说明了这一点。把 ID 存成文本,数不同值的个数。
同一个变量能在一次分析里是分类的、在另一次分析里是定量的吗?
可以。年份是标准的例子:每年一根柱子,是把它当作标签;一条趋势线,是把它当作数量。按每张图要回答的问题来选,并给派生出来的列起名字,让类型一目了然。
资料来源
- S. S. Stevens。On the Theory of Scales of Measurement。Science 103 (2684): 677–680,1946:四种量表、日历日期和线性变换,以及橄榄球号码标签。核对于 2026-11-20。
- Minitab Support。Comparison of categorical and quantitative variables:定义和数字编码的例子。核对于 2026-11-20。
- 美国人口普查局。ZIP Code Tabulation Areas (ZCTAs):ZIP Code 与 ZCTA 的区别。核对于 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
