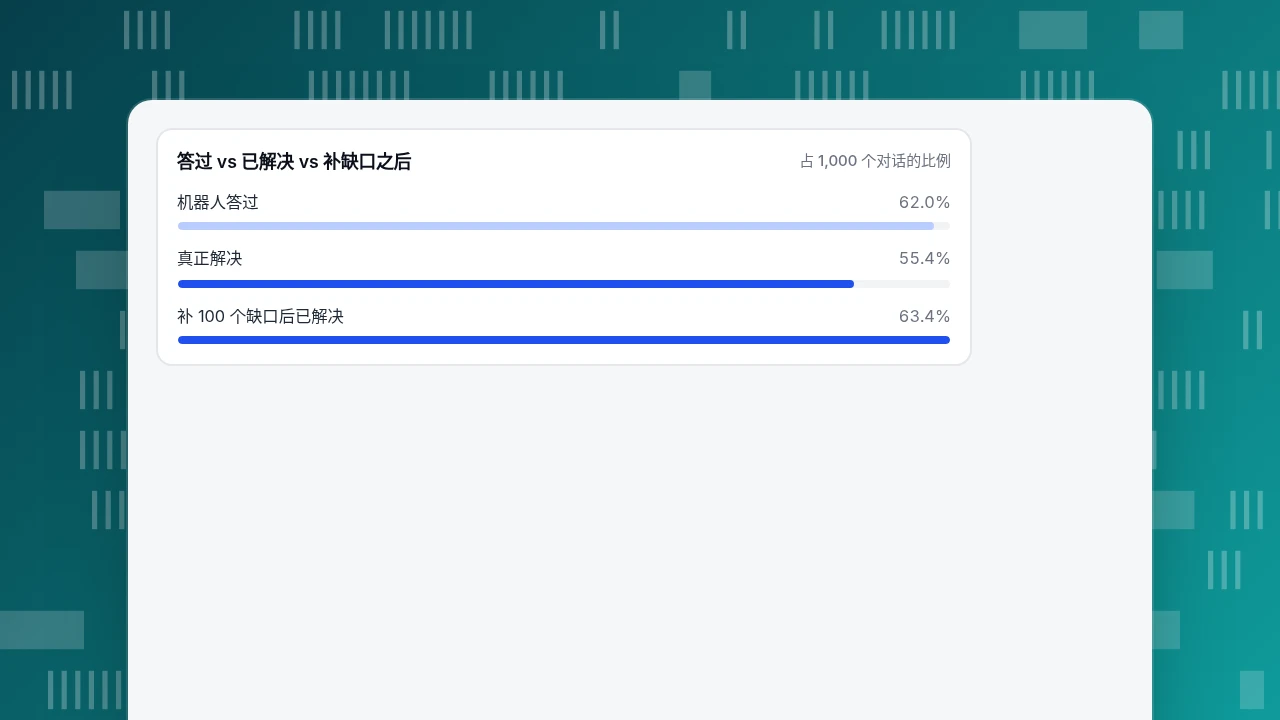
知识库聊天机器人根据你自己的文档和固定问答回答访客,材料里没有答案时就转给真人。搭的办法是先改内容、用真实问题测试,并按已解决而不是答过的对话来衡量:下面的示例里,62.0% 答过的对话只有 55.4% 真正解决。
读完你会知道
- 先改源材料:一件事一个页面,答案自成一体,带条件和日期;答错了改内容,不是重新训练
- 只有机器人答了、没要求找人、访客一周内没回来,才算分流成功
- 把转人工原因当待办清单:补上 100 个“没有匹配”的缺口,示例分流率从 55.4% 升到 63.4%
知识库聊天机器人是什么,又不是什么?
知识库聊天机器人根据你写好的材料回答访客的问题:帮助文章、政策页面、产品参数,以及客服平时反复敲的问答。它不是一个“懂你生意”的机器人。材料里没有答案时,做得好的机器人会把对话转给真人,而不是自己编。
这条规则决定了怎么搭。脚本式机器人要设计对话路径;知识库机器人要维护的是内容,它的质量等于内容质量,再加上对空白处的转人工规则。一份过期、含糊、散在五个页面里的知识库,只会换来一个同样过期、含糊、前后不一的机器人,而且答得更快。
开工前先说清两条边界:
- 它只回答,不办事。 知识库机器人能引用你的退款政策,但不能真的退款、改地址或查订单,除非你另做系统对接。凡是需要动手的事,都要规划转人工。
- 它只和最近一次修改一样新。 周一改了发货时间,文档里还写着“3-5 天”,机器人就会一直信心十足地这么说。
机器人和真人客服怎么配合,见 AI 客服代理;更泛的训练方法见怎么训练聊天机器人。
知识库聊天机器人是怎么找到答案的?
多数知识库机器人把两种机制组合使用。知道某个问题是哪一种答的,就知道错答该怎么改。
| 机制 | 过程 | 优点 | 失效方式 |
|---|---|---|---|
| 固定问答匹配 | 访客的话与某个问题(或一组关键词全部命中)匹配,原样发送写好的答案 | 准确、可预期、不调用模型 | 没列出的换种问法就匹配不上 |
| 检索加生成 | 先在文档里检索最相关的段落,再由语言模型据此起草回复 | 能覆盖没人写过问答的问题 | 检索到错的段落,或模型自己补空白 |
第二行就是检索增强生成(RAG)。思路来自 Lewis 等人 2020 年的论文:把语言模型自带的记忆和一个外部文档索引配合使用,让答案落在可以检查、可以更新的文本上,而不是固化在模型里(Lewis 等,NeurIPS 2020)。实际含义是:答错了,改文档或补一条问答,而不是去“重新训练”什么。
由这张表得出两个检查动作:
- 错答来自固定问答,说明那条问答本身是错的,直接改。
- 错答来自检索,就去看找到了哪一段。常见原因是:正确的段落根本不存在;存在但埋在很长的页面里;或者和另一个说法不同的旧页面互相竞争。
文档要好到什么程度才能上线?
好到一个陌生人只看一页就能回答客户的问题,不用再去问同事。下表列出让知识库机器人答不好的最常见问题、测试时的表现,以及对应的修改。
| 材料里的问题 | 机器人的表现 | 修改办法 | 快速检查 |
|---|---|---|---|
| 两个页面互相矛盾(新旧政策) | 有时答旧的,有时答新的 | 删除或跳转旧页面,一件事只留一个出处 | 在文档里搜关键短语,应只有一处命中 |
| 一页长文讲了十件事 | 检索到错的部分,或引用无关段落 | 拆成一个问题一节,每节有自己的标题 | 每个标题都应能单独回答 |
| 答案需要上下文(“见上文”) | 引用的句子单拿出来看不懂 | 重写,让每个答案自成一体 | 遮住标题读那一段 |
| 问题用的是你们的内部术语 | 访客真实的问法匹配不上 | 把访客的说法加进问题或关键词 | 拿 20 条真实开场白对照 |
| 数字没有日期或条件 | 把价格或截止时间当成通用的 | 在答案里写明条件和“截至日期” | 搜数字,每个都要有条件 |
| 例外写在别的地方 | 只说规则,不说例外 | 把例外放进同一个答案 | 直接问机器人边界情况 |
| 没写机器人不能做什么 | 遇到范围外的请求就即兴发挥 | 对每个范围外的主题写一条明确的“请联系我们” | 问三件你们不支持的事 |
这些问题在上线前改只花几个小时,上线后改花的是客户的信任。加拿大一家仲裁机构就判一家航空公司要为网站聊天机器人说错的政策负责(Moffatt 诉 Air Canada,2024 BCCRT 149,2024 年 2 月):机构不接受“机器人是独立的”这个说法。把机器人说的话当作你自己发布的内容。
| 材料里的问题 | 机器人的表现 | 修改办法 | 快速检查 |
|---|---|---|---|
| 两个页面互相矛盾 | 不同日子给出新旧不同的答案 | 删除或跳转旧页面 | 搜关键短语,应只有一处命中 |
| 一页长文讲了十件事 | 引用无关段落 | 一个问题一节,各有标题 | 每个标题都能单独回答 |
| 答案需要上下文 | 引用的句子单拿出来看不懂 | 重写成自成一体 | 遮住标题读那一段 |
| 用你们的术语而不是访客的 | 真实说法匹配不上 | 把访客的说法加为关键词 | 对照 20 条真实开场白 |
| 数字没有日期或条件 | 把价格或期限当成通用的 | 写明条件和截至日期 | 搜数字,每个都要有条件 |
| 例外写在别处 | 只说规则不说例外 | 把例外放进同一答案 | 直接问边界情况 |
| 没写机器人不能做什么 | 范围外的请求即兴发挥 | 每个范围外主题写一条“请联系我们” | 问三件不支持的事 |
上线前改完;上线后,机器人答错就等于你发布的声明。
一步一步怎么搭?
顺序很重要。很多人先选工具、最后才准备内容,然后奇怪为什么答案不好。
- 先收集真实问题。 导出最近 30 到 90 天的聊天开场白、离线留言和客服邮件,按主题分组并计数。先从最常见的 30 到 50 个问题开始;长尾会以转人工的形式出现,这没问题。
- 每个问题写或改一个答案。 40 到 120 字,一个答案只讲一组事实,带上条件和日期。目标是团队里两个不同的人给出同样的回答。
- 把内容分成两类条目。 高频且稳定的问题(营业时间、发货、退货期、重置密码)做成固定问答;较长的参考资料(安装指南、参数)保留为文档,让机器人检索。
- 写好转人工。 决定机器人答不了时访客看到什么、谁接手、不在工作时间怎么办(比如离线留言表单)。好的转接会说明接下来会发生什么。
- 用你没写过答案的问题来测。 用 50 条真实问题,不要用你写过条目的那些。逐条评为正确、部分正确或错误(见下一节)。
- 先从最窄的模式上线。 先只在没有坐席在线时让机器人答,或只在一组页面上开,看过一周对话记录再放宽。
- 每周复查转人工记录。 每一次转人工都是一条缺口。转人工最常见的原因,就是你的下一条条目。
怎么衡量它到底分流了多少对话?
“回答了”和“解决了”是两个数,机器人成功率的多数夸大,都出在两者之间的差距上。只有同时满足三点才算分流成功:机器人答了、访客没要求找人、同一访客一周内没有为同一问题再回来。
示例数据:一家店的机器人一个月处理了 1,000 个对话。
- 380 个由固定问答匹配回答;其中 30 位访客在七天内带着同样的问题回来,不算解决:380 − 30 = 350 个已解决。
- 240 个由检索回答;每周复查把其中 36 个标为错误或没用:240 − 36 = 204 个已解决。
- 380 个转给了真人(50% 没有知识匹配,25% 模型判断材料不足,18.4% 访客要求找人,6.6% 达到轮数上限)。
粗算的分流率把所有答过的都算上:(380 + 240) ÷ 1,000 = 62.0%。如实的分流率只算已解决的:(350 + 204) ÷ 1,000 = 55.4%。这 6.6 个百分点的差距是 66 个看起来省了人力、实际没省的对话。
按每个人工处理的对话 4.00 美元的坐席成本算(示例数字:时薪 28 美元 ÷ 每小时 7 个对话),554 个已解决对话每月节省 554 × 4.00 美元 = 2,216 美元;如果把所有答过的都算上就是 2,480 美元。怎么连同成本算出完整回报,见聊天机器人 ROI。
再来看转人工的原因。一半的转人工,也就是 190 个对话,是“没有知识匹配”:缺的是条目,不是模型的问题。假如新增一批问答覆盖了其中 100 个,且这 100 位里有 80 位得到解决,已解决对话就从 554 升到 634,分流率从 55.4% 升到 63.4%,每月多省 80 × 4.00 美元 = 320 美元。这就是循环:读转人工记录、写条目、重新测量。
另外,用一套固定的测试题评估答案质量。示例数据:50 道测试题里,38 道正确(76%),7 道部分正确(14%),5 道错误(10%)。凡涉及金额、期限、资格的,“部分正确”按失败算,因为只对一半的政策答复就是错的。
答过 vs 已解决 vs 补缺口之后
占 1,000 个对话的比例每周该复查什么?
复查 20 条转人工记录和 20 条机器人回答过的对话,大约半小时,能发现大部分问题。按这些规则做:
- 原因是“没有知识匹配”,且同一问题出现三次以上:写一条问答。
- 机器人答了,访客随后要求找人:去读那条答案。多半答得对但没用(太长、漏了条件)。
- 同一个错误答案出现两次:立刻改正源条目,不要等每周的固定时间。
- 答案里引用了数字:对照现行政策页面核对。带日期的数字最先过期。
- 问题属于要动手的事(退款、更改、取消):不要去教机器人,改进转接,让访客带着已经说清的背景到达坐席。
坐席的修改是很好的素材:坐席改写了机器人的错误答案,就把这份改写存成固定答案,下次同样的问题就会得到改正后的版本。
答错了怎么办?
假设一部分答案会出错,并据此设计。三项控制能把损害降到很小:
- 在第一条回复前说明这是机器人,并给机器人消息加标识,让访客知道涉及金钱的内容要再核对。
- 限制每个对话里机器人的轮数。 几轮之后访客仍不满意,就应该找到真人。
- 让机器人远离决定。 它可以陈述政策,但不该承诺没有人批准的例外、退款或时间。
也有证据表明,AI 适合放在人旁边,而不是取代人。一项涉及 5,179 名客服的研究里,使用 AI 助手让每小时解决的问题平均多 14%,新手和低技能员工多 34%,经验最丰富的人变化很小(Brynjolfsson、Li 和 Raymond,NBER 工作论文 31161)。这项研究针对的是给客服的建议,不是无人值守的机器人,但结论可以借用:知识库里的材料,在仍有人把关的地方帮助最大。
在 TapCub 里怎么做?
拿上面那个示例月:1,000 个对话、380 次转人工、其中一半是“没有知识匹配”。下面是在 TapCub 里怎么跑这个循环,只用产品实际有的功能。
- 添加内容。 打开 客服 › 知识库。高频且稳定的问题加为问答对条目;问题或关键词精确命中时按原文发送,不消耗 AI 调用。较长的参考资料加为文档条目,会切成约 600 字一段,先用全文检索(数据库索引,不是向量库)找出来,再由模型起草回复。
- 上线前测试。 用同一页的测试对话。它走和真实访客一样的路径,不耗额度,也不会建会话,所以 50 题的测试集可以随便跑。
- 选模式。 在 客服 › 聊天设置 › AI 接待 里,先选仅坐席全离线时,等答案站得住再换成 AI 先答。设置单会话最多回答轮数(默认 6),并写好转人工提示文案。访客在第一条回复前会被告知正在和 AI 对话,这条提示不能关闭。TapCub 的 AI 只生成回复,不改订单、不发邮件、不调用别的系统。
- 置顶高频问题。 置顶问答显示在访客端 FAQ 里。打开答案不会建会话,也不耗额度;只有点没解决或要求人工才会建会话。
- 跑每周循环。 在工作台里,每次转人工都标有原因(没有知识匹配、模型无法回答、访客要求、轮数上限、坐席接手)。对错误答案点纠错入库存成问答对;在草稿收件箱点从历史会话生成,从最近 30 天已解决的对话里生成问答草稿(每批 1 次 AI 调用;每个站点每 24 小时一次)。草稿批准之前不会上线。
- 看数字。 客服 › 客服报表 里,知识库命中率(直接问答匹配或检索回答的问题占比)和解决率并排显示。“七天内重复联系”TapCub 不会替你算,所以要得到如实的分流率,请对照已解决对话和访客轨迹里回来的人。
常见问题
什么是知识库聊天机器人?
根据你自己的文档和固定问答回答问题、而不是照固定脚本说话的聊天机器人。材料里没有答案时,它应该把对话转给真人。它的质量主要取决于你的内容有多新、多具体。
怎么用自己的文档训练聊天机器人?
不用重新训练模型。你把文档和问答加进机器人检索的索引,再用真实问题测试。答错了就改或补内容,下一个问题立刻生效。
起步需要多少条目?
从占聊天开场白大头的 30 到 50 个问题开始,写成自成一体的答案。长尾会以转人工的形式出现;任何重复出现三次的问题,就补一条。
多高的分流率算好?
没有通用数字,因为取决于你的问题有多重复。跟踪你自己的数字:已解决对话除以全部对话,排除重复联系。目标是填补最常见的转人工原因,让它逐月上升。
知识库聊天机器人会答错吗?
会。它可能检索到错的段落,或用模型的通用知识去补空白。要说明这是机器人、限制轮数、让它远离决定,并每周复查转人工记录。
资料来源
- Lewis 等,Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,arXiv:2005.11401,2020 年 5 月 22 日首次提交(2026-11-20 核对)。
- Brynjolfsson、Li 和 Raymond,Generative AI at Work,NBER 工作论文 31161,2023 年 4 月发布、同年 11 月修订(2026-11-20 核对)。
- 不列颠哥伦比亚省民事解决仲裁庭,Moffatt v. Air Canada, 2024 BCCRT 149,2024 年 2 月(案号经律所摘要于 2026-11-20 核对)。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
