训练聊天机器人,先收集 50 段最近已解决的对话,按主题统计,判断哪些主题有固定答案,再用客户自己的说法写答案,并用留出的对话测试。对多数企业来说,这是整理答案,不是训练模型。示例里 50 段对话中有 35 段(70%)在范围内,三轮每周复盘把正确率从 60% 提到 84%,错误率从 20% 降到 4%。
读完你会知道
- 训练企业聊天机器人,是整理答案并拿真实对话检查,不是训练模型
- 先划范围:示例里 70% 的对话有固定答案,30% 按设计转人工
- 用留出对话上的错误率判断能否上线;示例里每周复盘把它从 20% 降到 4%
对企业来说,「训练」聊天机器人指什么
对多数企业来说,训练聊天机器人并不是训练一个语言模型,而是整理机器人用来回答的材料,再拿真实对话检查它的回答,把错的改掉。实际做起来有两种样子:
- 基于意图的机器人(规则或分类器驱动)用示例语句训练。Google 的 Dialogflow 文档说,每个意图要建「至少 10-20 条(视意图复杂程度而定)训练语句」,它的机器学习会在你的列表基础上扩展,所以不必穷举每一种说法。
- 基于知识库的机器人(检索加语言模型)用答案和文档训练。权重里什么都没学,机器人是去找最匹配的材料,再据此起草回复。
两者依赖同一种输入:客户真实会问什么,用他们自己的话。所以你手上已有的、质量很高的训练数据,就是聊天记录。本文用 50 段对话,一步步把它们变成训练好的答案,数字都能复算。怎样在机器人类型之间选择,见 NLP 聊天机器人;机器人该做什么、不该做什么,见 AI 客服代理。
第 1 步:把 50 段对话按主题分类
取最近 50 段已解决的对话。逐段读,每段只贴一个主题标签,以客户开口的那个问题为准,不看坐席的回答。不要先发明一套分类,让标签自然出现,然后合并相近的。
示例数据:一家小型服装网店的 50 段对话。
| 主题 | 对话数 | 累计 | 累计占比 |
|---|---|---|---|
| 配送时间与运费 | 14 | 14 | 28% |
| 退货与退款 | 11 | 25 | 50% |
| 订单状态 | 9 | 34 | 68% |
| 尺码与版型 | 6 | 40 | 80% |
| 账户与其他 | 6 | 46 | 92% |
| 优惠码 | 4 | 50 | 全部 |
有两点很突出。前两个主题已经覆盖 50 段里的 25 段,也就是 50%,所以最先写的几条答案很快就能回本。另外这是一条长尾:排第六的主题也是确实有人问过的真实问题。
有一类先不要计入:标成「账户与其他」的 6 段是个别情况,比如改地址。它们教不了你什么可复用的东西,应该和下一步的转人工放在一起。
| 主题 | 对话数 | 累计 | 累计占比 |
|---|---|---|---|
| 配送时间与运费 | 14 | 14 | 28% |
| 退货与退款 | 11 | 25 | 50% |
| 订单状态 | 9 | 34 | 68% |
| 尺码与版型 | 6 | 40 | 80% |
| 账户与其他 | 6 | 46 | 92% |
| 优惠码 | 4 | 50 | 全部 |
示例数据:一家小型服装网店的 50 段对话。订单状态和账户类按设计转人工。
第 2 步:决定哪些主题可以让机器人答
一个主题只有在答案对每位客户都一样、而且写在文档里时,才适合机器人回答。如果答案要去订单系统里查,机器人给不出,正确的做法是干净利落地转给人。
把这个判断用在示例上:
- 配送时间与运费(14)、退货与退款(11)、尺码与版型(6)、优惠码(4)都是政策类答案。14 + 11 + 6 + 4 = 50 段里的 35 段,即 70%,在范围内。
- 订单状态(9)需要客户自己的订单。账户与其他(6)是个别情况。合起来50 段里的 15 段,即 30%,按设计就是转人工。
这个划分决定了上限。一个能把 70% 的对话类型答对的机器人已经做得不错;为了冲到全部答对,让它对订单状态瞎猜,最后就会对客户说出错话。不列颠哥伦比亚省的一个仲裁庭判定,航空公司要为聊天机器人告诉客户的丧亲票价信息负责(Moffatt v. Air Canada,2024 BCCRT 149,判令该公司共支付 812.02 加元),并驳回了「聊天机器人是独立主体」的说法。机器人说的每一句话,都算你说的。
第 3 步:照着真实的说法写答案
每个范围内的主题,每个不同的问题写一条答案,而不是每个主题一条。「运费多少?」和「什么时候到?」都属于配送,但是不同的问题,答案也不同。
用对话记录来写答案:
- 把客户的说法抄进问题里。 如果三位客户写的是「我的退款呢」,没有人写「退款状态咨询」,你存的问题就用前一种。
- 答案取自政策页面,不取自坐席的回复。 坐席会缩写和临场发挥,政策页面才是依据。把链接放进去。
- 写明限制。「未穿着的商品 30 天内可免费退货」比「退货免费」好。
- 以下一步结尾。 客户该做什么,不在覆盖范围时找谁。
如果你做的是基于意图的机器人,这里就要用到 10 到 20 条语句。35 段范围内的对话对应 4 个主题,每个主题大约有 8 条真实说法。以它们为核心,再补充改写,直到每个意图达到 Google 建议的至少 10 到 20 条,改的是措辞,不是重复。意图之间要分开:同一句话出现在两个意图里,分类器就无法决定。
第 4 步:留出一部分对话来测试
上线前,从 50 段里取 10 段,不用它们来写答案。把它们开头的问题拿给机器人重放,每条回复标为正确、错误或转人工。主题在范围之外时,转人工算成功。
示例数据:首轮用 25 段新对话。
| 轮次 | 正确 | 错误 | 转人工 | 正确率 | 错误率 |
|---|---|---|---|---|---|
| 1 | 15 | 5 | 5 | 60% | 20% |
| 2 | 18 | 3 | 4 | 72% | 12% |
| 3 | 21 | 1 | 3 | 84% | 4% |
要盯的是错误这一列,而不是正确那一列。错误回答比转人工代价更高,因为客户会照着它去做。首轮 25 段里错了 5 段:也就是 20% 的对话里机器人自信地答错了,这样的版本还不能面对客户。上线门槛应当是你能承受的错误率,而且要在测试前定好,而不是一个你希望达到的正确率。
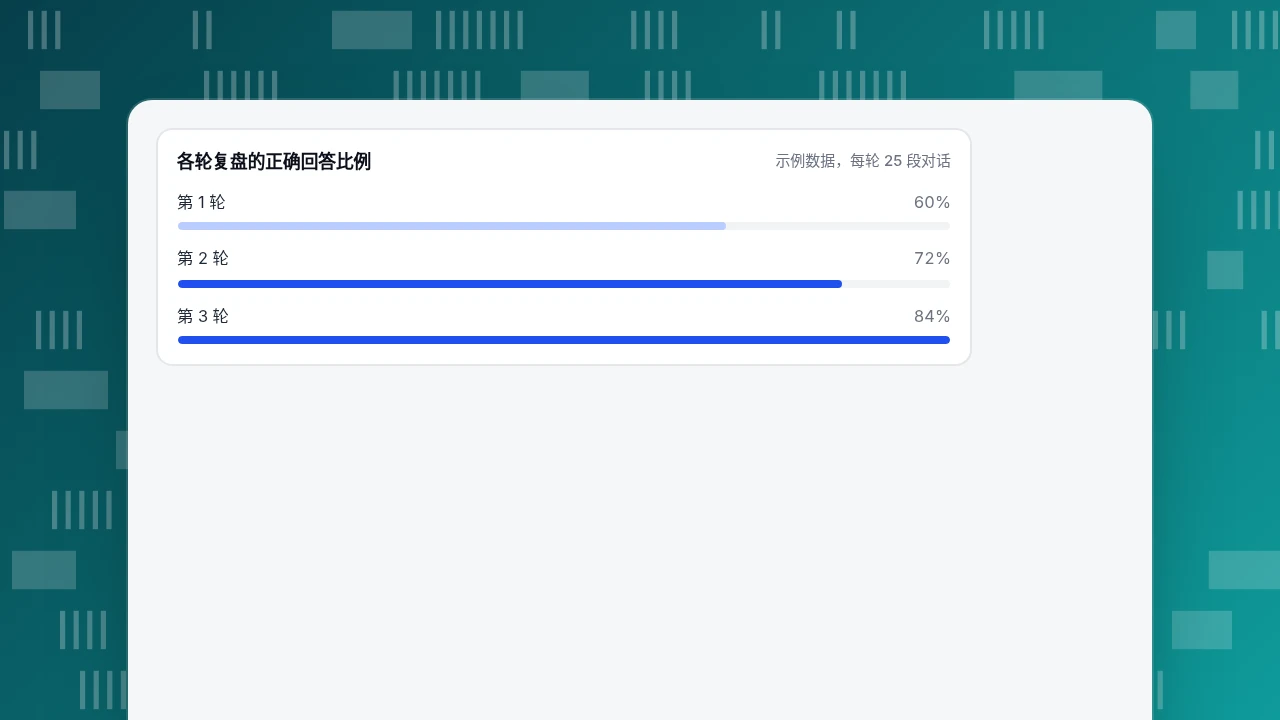
各轮复盘的正确回答比例
示例数据,每轮 25 段对话第 5 步:每周跑一轮复盘
训练不会在上线时结束,它变成读对话、改问题的循环。每周取 25 段最近的机器人对话,分成几类:
- 答错了:修改或补充问题和答案。如果是来源文档写得不清楚,先改文档。
- 范围内的主题转了人工:说明机器人没找到答案,把客户用的说法补进去。
- 范围外的主题转了人工:行为正确,不用动。
- 客户重复提问:答案不够清楚,即使从技术上说是对的。
在示例里,三轮这样的复盘把正确率从 60% 提到 84%,错误率从 20% 降到 4%。每一轮只修它发现的具体失败,而不是全部重写。数字是示意,但走势是典型的:错误率开头下降最快,然后趋平,新的失败来自新的主题(一次促销、一次政策变更)。给自己设一个提醒,政策页面一变,就更新答案,因为过期的答案就是错误的答案。
第 6 步:衡量机器人在做什么
四个数字能说明训练有没有起作用:
| 指标 | 公式 | 说明什么 |
|---|---|---|
| 正确率 | 正确数 ÷ 抽样数 | 答案质量 |
| 错误率 | 错误数 ÷ 抽样数 | 风险 |
| 转人工率 | 转人工数 ÷ 全部机器人对话 | 覆盖度,按范围内和范围外分开看 |
| 重复提问率 | 再次提问的客户 ÷ 对话数 | 清晰度 |
每周用同样的抽样数来记录,这样才能比较。如果客服量每周不到 25 段,就全部复盘。关于钱的一面,聊天机器人 ROI讲了怎样给已解决的对话估值,以及为什么只有完全解决的才算。
在 TapCub 里怎么训练聊天机器人
TapCub 在线客服的知识库,工作方式和上面的知识库型机器人一样,所以 50 段对话的例子可以直接对应。TapCub 不训练模型:它存放你的答案和文档,由 AI 据此起草回复。
- 把对话变成草稿。 在客服 › 知识库的草稿收件箱里选「从历史会话生成」。TapCub 取近 30 天已解决会话里的访客提问和坐席回复,归并成问答草稿。每个站点每 24 小时可以生成一次,每一批消耗 1 次 AI 额度。草稿在你通过之前不起作用,忽略的草稿会被丢弃。
- 把范围内的答案写成问答对。 访客的消息与归一化后的问题相同,或者包含全部关键词时,问答对原文发送,不消耗 AI 次数。第 3 步里的政策类答案(配送、退货、尺码、优惠码)适合用问答对。
- 较长的材料用文档。 文档按约 600 字切段;没有问答命中时,TapCub 用全文检索(不是向量库)查这些段落,由模型起草回复。如果模型判断材料不够,就转给人。
- 测试不耗额度。 客服 › 知识库里的 Playground 走同一条链路,不计额度、不产生会话。把留出的 10 个问题拿到这里重放。
- 选择模式和上限。 在客服 › 聊天设置 › AI 接待里选关闭、「仅坐席全离线时」或「AI 先答」。默认每段会话最多回答 6 轮,可以在 1 到 20 之间调整,超过后转人工。访客会被告知正在和 AI 对话。
- 在工作台里复盘。 客服 › 客服工作台里的每次转人工都标有原因(无命中、模型无法回答、访客要求、超过轮数、坐席接手),这就是第 5 步里范围内和范围外的区分。回答错了,用「纠错入库」,它会存成一条问答对,下次同样的问题就原文发送。
TapCub 的 AI 只生成回复,不查订单、不改任何东西、不调用别的系统,所以这个例子里「订单状态」仍然是转人工。它也不提供现成的正确 / 错误评分,这部分抽样要你自己用对话记录来做。
FAQ
怎样用自己的数据训练聊天机器人?
收集 50 段最近已解决的对话,按主题标注,判断哪些主题有固定答案,再用客户自己的说法给每个不同的问题写一条答案。用留出的对话测试,每周复盘 25 段。对多数企业机器人来说,这是整理答案,不是训练模型。
聊天机器人需要多少条训练语句?
对基于意图的机器人,Google 的 Dialogflow 文档说每个意图至少 10 到 20 条,视复杂程度而定,措辞要有变化;它的机器学习会扩展这个列表。知识库型机器人用的是答案和文档,而不是语句。
能用聊天记录训练聊天机器人吗?
能,而且它们是质量很高的来源,因为里面有客户的真实说法。用它们找主题和说法,但答案要取自你的政策页面,并先去掉个人信息。留出一部分对话用来测试,不要把 50 段全用上。
训练聊天机器人要多久?
有了对话记录,覆盖主要主题的初版可能一两天就能做出来。复盘循环是持续的:这里的示例用了三轮每周复盘,才达到 84% 正确率和 4% 错误率。上线之后每周都要留出时间。
怎样避免聊天机器人给出错误答案?
把它限制在答案固定的主题上,其余一律转人工,并且每周按抽样衡量错误率。已有仲裁庭判定公司要为其聊天机器人的陈述负责,所以错误回答就是你的回答。
资料来源
- Google Cloud。Dialogflow 训练语句:每个意图至少建 10-20 条(视意图复杂程度而定)训练语句;措辞要有变化。核对日期 2026-11-20。
- 不列颠哥伦比亚省民事仲裁庭。Moffatt v. Air Canada,2024 BCCRT 149:航空公司要为其聊天机器人上的信息负责;判令支付 812.02 加元。核对日期 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
