用户分析是分析个人在产品里做了什么,以回答谁在用、怎么用、用得怎样。它的单位是人而不是页面,所以需要再次认出同一个人的办法。下面是它能回答的问题、要先设置什么,以及一个从结果走到决定的算例。
读完你会知道
- 把问题分成谁、怎么用、用得怎样,并且永远对比群组,而不是只读一个总数
- 先识别登录的人;示例里只有 18% 的访客能建档案
- 像 280 升到 310 的例子那样,从一个结果走到一个预示它的步骤,再走到一个能拆开群组的属性
什么是用户分析?它和网站统计有什么区别?
用户分析是收集并分析个人在你的产品里做了什么,用来回答三个问题:谁在用,怎么用,用得怎样。它的单位是人,而不是页面。网站统计问的是「定价页有多少次访问?」;用户分析问的是「上个月注册的人里,有多少走到了产品开始有用的那一步,谁又回来了?」
| 网站统计 | 用户分析 | |
|---|---|---|
| 主要单位 | 浏览量、会话、访客 | 人(或账户)以及他们随时间做的事 |
| 典型问题 | 哪些页面和来源带来了流量? | 哪类用户得到了价值并留下来? |
| 需要什么 | 一段统计脚本 | 统计脚本,加上再次认出同一个人的办法 |
| 主要报表 | 来源、页面、跳出 | 分群、漏斗、留存、路径、用户档案 |
两者有重叠,后者建立在前者之上。区别之所以重要,是因为流量数字可以上升,而得到价值的人数却在下降。同一件事在采集一侧怎么做,见用户行为追踪;采集之后怎么读行为,见行为分析;产品场景下的版本见产品使用分析。
用户分析能回答哪些问题?
问题按定义里的方式分组。下表每一行都是一个决定,加上支撑它的度量。
| 分组 | 问题 | 度量 |
|---|---|---|
| 谁 | 这个月的新用户是谁,从哪来的? | 按来源、套餐或国家看的新用户 |
| 谁 | 哪些用户参与度高? | 每周活跃天数、人均事件数 |
| 谁 | 不同类型的用户有什么差别? | 用属性和行为建立的分群 |
| 怎么用 | 用户先做什么,接着做什么? | 路径和事件序列 |
| 怎么用 | 在注册这类流程里,人们在哪一步停下? | 每一步的漏斗转化 |
| 怎么用 | 人们用哪些功能,用得多频繁? | 每个功能的用户数、频次 |
| 用得怎样 | 新用户会回来吗? | 按群组看的留存 |
| 用得怎样 | 走到有用的动作要多久? | 两个事件之间的时间 |
| 用得怎样 | 谁在慢慢流失? | 7、14 或 30 天不活跃的用户 |
有两个习惯能让这份清单保持有用。其一,从决定出发(改引导、下线功能、修结账步骤),选这个决定所依赖的问题。其二,永远对比群组。单独一个数字,比如「40% 的人在第 2 周回来」,说明不了什么;「桌面端注册的 40%,移动端的 20%」才说明该往哪看。
回答这些问题之前,要先具备什么?
三样东西,按这个顺序。
1. 认出同一个人的办法。 匿名追踪能告诉你一台设备回来了,但不能告诉你手机上的人和笔记本上的人是同一个客户。有人登录之后,你就可以挂上自己的用户 ID。Google 把它的 User-ID 功能描述为:让你把自己的标识符与个人用户关联,以便跨会话、设备和平台追踪行为,并且每个 ID 算作一个独立用户。在一个人被识别之前,他会出现在访客数里,但不能有档案。
要弄清报表里数的是哪种「用户」。Google 自己的定义就说明了差别:总用户是在范围内触发过任何事件的人,活跃用户是有互动会话或特定互动信号的人,新用户是首次访问或首次打开发生在范围内的人,回访用户是此前至少有过一次会话的人。四个数字,名字里都有「用户」。每份报表选定一种定义并写下来。相关术语见用户 ID。
2. 一份简短、有名字的事件清单。 五六个事件就够起步:注册、完成设置、使用核心功能、邀请他人、付费。如果什么都在追踪、却什么都没命名,每个问题都得找开发。
3. 少量用户属性。 套餐、国家、注册来源和注册日期能解释群组间的大多数差别。需要时再加属性,不要提前加。
示例数据:一个网站一个月有 10,000 个访客,其中 1,800 人登录。已识别占比是 1,800 ÷ 10,000 = 18%。其余 82% 可以计数,但不能建档案,也不能跨设备追踪,所以任何关于「用户」的结论,其实都是关于这 18% 的结论。要在报告里写明。
怎么从一个问题走到一个决定?算例
示例数据:上个月有 1,000 人注册。问题是为什么回来的人这么少。步骤如下:
- 量出结果。 1,000 人里有 280 人(28.0%)在第 2 周回来了。
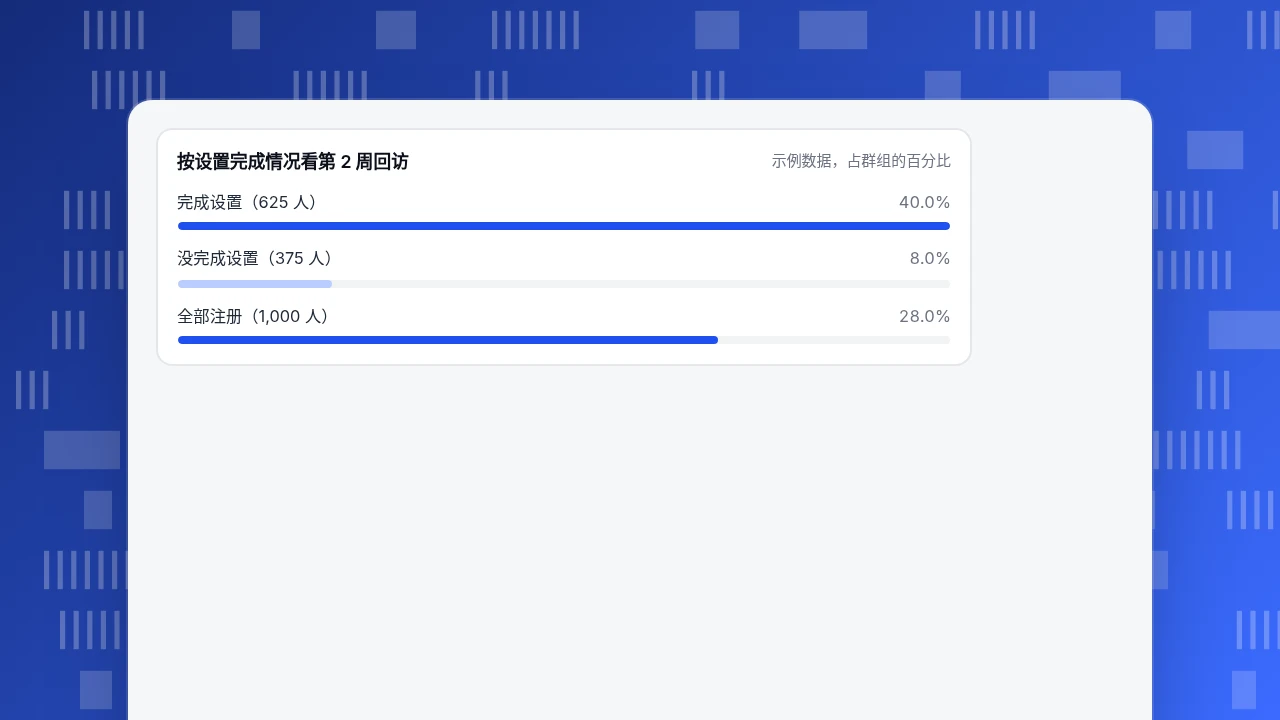
- 找到能预示结果的那一步。 625 人完成了设置(62.5%):桌面端注册的 700 人中有 490 人(70.0%),移动端注册的 300 人中有 135 人(45.0%)。完成设置的 625 人里,有 250 人在第 2 周回来(40.0%);没完成的 375 人里,有 30 人回来(8.0%)。250 + 30 = 280,与第 1 步吻合。
- 用一个属性拆开。 桌面端和移动端的设置完成率相差 70.0% − 45.0% = 25 个百分点。
- 估算空间。 如果移动端达到桌面端的水平,300 × 25% = 75 个人会多完成设置。按完成设置者 40.0% 的回访率,就是 75 × 0.40 = 30 个多回来的用户,第 2 周回访人数从 280 升到 310(31.0%)。
| 群组 | 人数 | 第 2 周回来 |
|---|---|---|
| 完成设置 | 625(占注册的 62.5%) | 250(40.0%) |
| 没完成设置 | 375(37.5%) | 30(8.0%) |
| 全部注册 | 1,000 | 280(28.0%) |
决定:先修移动端的设置流程,其他的往后放。这个 30 是上限,不是预测,因为移动端新转化的那些人,投入程度可能低于平均水平,回来得也会更少。把它理解为「值得一试」,改完之后再看真实的数字。注意让这个分析成立的东西:一个结果、一个能预示它的步骤、一个能把群组拆开的属性。
按设置完成情况看第 2 周回访
示例数据,占群组的百分比应该先看哪些用户分析报表?
| 报表 | 用来 | 要留意 |
|---|---|---|
| 分群 | 把一个群组定义一次(比如上个月的移动端注册),反复使用 | 匿名访客通常无法建分群;需要已识别的人 |
| 漏斗 | 看人们在两个事件之间在哪里停下 | 漏斗说明在哪里,不说明为什么;要配合回放或对话 |
| 留存 | 看一个群组在第 1、2、4 周是否还活跃 | 还没结束的周期是不完整,不是零 |
| 路径 | 看人们在一个事件前后做了什么 | 路径噪声大;从具体事件出发,不要看整个产品 |
| 用户档案 | 读一个人的时间线,弄懂一个让人困惑的案例 | 适合理解,不适合度量;一个案例是例子,不是比率 |
先对同一个群组看留存和漏斗,就像算例那样。当这两个报表引出「为什么」的问题时,再加路径和档案。这里用到的术语见分群、漏斗、群组和留存。
| 报表 | 用来 | 要留意 |
|---|---|---|
| 分群 | 把一个群组定义一次,反复使用 | 匿名访客通常无法分群 |
| 漏斗 | 看人们在两个事件之间在哪里停下 | 说明在哪里,不说明为什么 |
| 留存 | 看一个群组在第 1、2、4 周是否还活跃 | 没结束的周期是不完整,不是零 |
| 路径 | 看人们在一个事件前后做了什么 | 噪声大;从具体事件出发 |
| 用户档案 | 读一个人的时间线 | 一个案例是例子,不是比率 |
先对同一个群组看留存和漏斗。
个人数据方面要留意什么?
用户级分析天然比汇总的流量数更接近个人数据,所以有几个习惯值得一开始就养成。以下是一般性信息,不是法律意见;你的市场适用什么,请咨询自己的顾问。
- 只收集问题需要的。 欧盟 GDPR 第 5 条第 1 款(c)项确立了数据最小化原则:个人数据应当适当、相关,并限于为目的所必需。套餐名和注册日期能服务大多数问题;完整的出生日期很少需要。
- 用内部 ID,不要用邮箱地址做标识。 事件属性里的邮箱会被复制进每一次导出和每一张截图。
- 不需要的不要发送。 表单内容、密码和自由输入的消息,都不应该进入事件。
- 尊重同意和当地规则。 是否需要同意,取决于你怎么收集、用户在哪里。
- 限制谁能看档案,以及看多久。 逐人的时间线只给需要的少数人,旧的明细按计划到期删除。
哪些错误会让用户分析产生误导?
- 把匿名访客当成用户读。 上面的例子里,82% 的访客从未被识别。
- 只用一个总数。 62.5% 的设置完成率,掩盖了一个 45.0% 的群组和一个 70.0% 的群组。
- 混用定义。 一份报表里的「活跃用户」和另一份里的「总用户」永远对不上。
- 把相关当成因果。 完成设置的人回来得更多(40.0% 对 8.0%),但其中一部分是因为投入的人两件事都做。第 4 步里的移动端修复是一个有待检验的估算,不是承诺。
- 把没结束的周期读成零。 最新的群组还没来得及回来。
- 只看一个案例。 一份档案是故事,一个分群才是比率。用档案提出问题,用分群回答问题。
在 TapCub 里怎么做用户分析
拿上面的例子,设想在 TapCub 里跑一遍。
- 识别登录的人。 有人登录时调用
tapcub.login(),并且项目已开启识别模式(见识别用户)。他们就会出现在 全端分析 › 用户 › 用户 里,档案中有关联设备、分群和按天排列的时间线。匿名访客仍然计入网站统计报表,但没有档案,也不进分群。 - 把分群建一次。 在 全端分析 › 用户 › 分群与标签 里建一个规则分群,比如「上个月注册、用移动端」(规则分群每天或手动刷新)。同一个分群之后可以用在漏斗和留存视图里。
- 跑漏斗。 在 全端分析 › 行为分析 › 行为分析 里建一个从注册到完成设置再到回访的漏斗,看移动端和桌面端分别在哪里掉。用分群来对比。
- 读留存。 在同一处选留存:起始事件选「注册」,回访事件选任意活动,按天或按周。每一行是一个群组,每个周期有人数和比率,还没结束的周期显示为空,不是零。生命周期视图再加上每周或每月的新增、留存、回流和流失人数。
- 打开档案看原因。 对一个停在设置那一步的移动端用户,在 用户 里打开他的档案,读时间线上掉出去之前有没有报错或受挫信号。这就给出了下一个要检验的问题。
TapCub 不做用户问卷,也不给用户发消息,更不跑实验;它展示谁做了什么,以及这些随时间怎么变。该问什么问题、改什么,仍然由你决定。
常见问题
什么是用户分析?
用户分析是收集并分析个人在产品或网站里做了什么,用来了解谁在用、怎么用、用得怎样。它关注人和他们随时间的行为,用到的工具包括分群、漏斗、留存和用户档案。
用户分析和网站统计有什么区别?
网站统计数流量:访问、页面和来源。用户分析跟随人在产品里的路径:他们做什么,是否完成关键步骤,是否回来。网站统计里能看到 10,000 次访问;用户分析告诉你这些人里有多少得到了价值,而这需要再次认出同一个人的办法。
用户分析能回答哪些问题?
它回答用户是谁,比如按来源或套餐看的新用户;他们怎么使用产品,比如经过哪些步骤、在哪里停下;以及产品对他们用得怎样,比如会不会回来、走到有用的动作要多久。每个问题都宜通过对比群组来回答,而不是只看一个总数。
开始做用户分析需要什么?
一个认出同一个人的办法(登录 ID),一份简短、有名字的事件清单,比如注册、完成设置和付费,以及套餐和国家等少量属性。五个事件就可以起步。只有在问题需要时才加。
用户分析就是追踪个人吗?
不一定。很多问题只需要群体:群组、分群和比率。逐人的时间线适合理解一个案例,但隐私责任更重。只收集问题需要的数据,用内部 ID 而不是邮箱,并把档案的查看权限控制在小范围。
资料来源
- Google。User-ID,Analytics 帮助。把自己的标识符与个人用户关联。2026-11-19 核对。
- Google。了解用户指标,Analytics 帮助。总用户、活跃用户、新用户和回访用户的定义。2026-11-19 核对。
- Mixpanel。留存(Retention),产品文档。留存度量把起始事件与之后的回访事件配对,并统计去重用户。2026-11-19 核对。
- 欧盟。通用数据保护条例(EU)2016/679 第 5 条第 1 款(c)项,数据最小化。2026-11-19 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
