定性数据是描述性信息,比如文字、类别和观察,而不是数字。产品工作里,它是聊天消息、评论、访谈笔记和会话回放里看到的东西。用定量数据找到哪里不对,用定性数据解释为什么。方法是编码:给每一条贴标签,数每个标签有多少条,再让第二个人检查标签。
读完你会知道
- 数字定位问题,文字解释原因,所以两者要放进一个循环:定位、解释、行动、验证
- 把文字编码进一份小的编码手册并计数;编码后的计数描述的是你读过的消息,不是全部访客
- 让第二个人给同一份样本编码并计算一致性;50 条消息上 kappa 0.72 属于较高,分歧处显示哪些定义要写清楚
什么算定性数据,什么不算?
定性数据是用文字、类别、图像或观察记录下来的信息,而不是用数量。一条客服消息、一份访谈笔记、一条应用评价,以及「尺码不对」这个标签,都是定性的。会话数、价格、响应时间是定量的。NNLM 的数据术语表说得很简单:定性数据表示的是数字表示不了的信息和概念。
大部分混淆来自三种边界情况:
| 情形 | 是定性还是定量? | 原因 |
|---|---|---|
| 邮政编码、套餐 ID、客户编号 | 定性(标签) | 虽然用数字写,但把两个加起来或求平均没有意义 |
| 1 到 5 的评分 | 有序数据:有顺序的类别 | 能排先后,但 3 分和 4 分之间差多少是未知的。有些资料把有序数据归为定性,有些说它介于两者之间;见有序数据 |
| 把自由文本评论变成计数(「50 条里 18 条提到价格」) | 定性数据,用数字汇总 | 计数来自你的编码,不是评论本身 |
一个快速判断:如果这些值的平均数或总和有现实意义,它是定量的;如果有用的操作是阅读、分组、数每组有多少条,它是定性的。 完整定义见定性数据和定量数据;这篇讲例子,以及怎样把它们变成能行动的东西。两者的正面对比在定性数据与定量数据。
产品和客服团队里,有哪十个定性数据的例子?
| # | 例子 | 怎么收集 | 通常编码什么 |
|---|---|---|---|
| 1 | 访客的在线客服消息 | 聊天记录 | 主题(价格、设置、故障)、意图(购买、取消、了解) |
| 2 | 离线留言(邮箱加一个问题) | 没人在线时显示的表单 | 同样的主题,加上访客当时在哪个页面 |
| 3 | 坐席对会话写的内部备注 | 在工作台里写的备注 | 根本原因、承诺了什么、后续动作 |
| 4 | 会话回放里看到的 | 观看录制的会话 | 人在哪里犹豫、回退,或点了没反应的东西 |
| 5 | 访谈笔记 | 一对一通话 | 目标、变通做法、换产品的原因 |
| 6 | 问卷开放题答案 | 你自己运行的问卷工具 | 分数背后的原因;对照满意度 CSAT |
| 7 | 应用商店和评价网站的评论 | 公开页面 | 按功能归类的抱怨和好评 |
| 8 | 取消原因 | 取消时的自由填写框 | 价格、缺功能、换了产品、不再需要 |
| 9 | 功能需求 | 邮件、社区帖子、销售电话 | 对方想完成的事,而不是他提的方案 |
| 10 | 可用性测试观察 | 有人主持或无人主持的测试 | 哪些任务失败、在哪里、对方自己的话 |
好来源和差来源有两个区别。好来源写于问题发生的当下(聊天消息强于一个月后发出的问卷),而且来自很多不同的人,而不是最爱发声的那几位。
| 例子 | 收集方式 | 编码什么 |
|---|---|---|
| 在线客服消息 | 聊天记录 | 主题和意图 |
| 离线留言 | 没人在线时显示的表单 | 主题和页面 |
| 坐席内部备注 | 工作台里的备注 | 根本原因和后续 |
| 会话回放观察 | 观看录制的会话 | 犹豫和无反应的点击 |
| 访谈笔记 | 一对一通话 | 目标和变通做法 |
| 问卷开放题答案 | 你自己的问卷工具 | 分数背后的原因 |
| 应用和网站评论 | 公开页面 | 按功能归类的抱怨和好评 |
| 取消原因 | 自由填写框 | 价格、缺功能、换产品 |
| 功能需求 | 邮件、社区、销售电话 | 要完成的事 |
| 可用性测试观察 | 测试过程 | 失败的任务和用词 |
好来源写于问题发生的当下,而且来自很多不同的人。
怎样把定性数据编码成能计数的类别?
编码就是给每段文字贴一个简短标签,好让你计数和比较。Braun 和 Clarke(2006)把主题分析分成六个阶段:熟悉数据、生成初始编码、寻找主题、复核主题、定义并命名主题、写成报告。产品工作里的轻量版,一个下午就能做完:
- 先读一批,不贴标签。 读 20 条左右,记下冒出来的东西。你是在收集候选类别。
- 写一份编码手册。 每个编码有:名称、一句话定义、一条示例消息、一条「不属于这里」的规则。一句话定义不出来的编码,拆开或删掉。
- 定好一条消息涉及多个主题时的规则。 要么每条消息只给一个主编码(简单,计数合计等于消息数),要么每条可以有多个编码(更丰富,计数合计超过全部)。开始之前定好。
- 给样本里的每条消息编码。 只有现有编码都不合适时才新增,新增后回头复查前面的。
- 计数并引用。 报告计数,并为每个类别附上一两条真实引用,让数字保留含义。
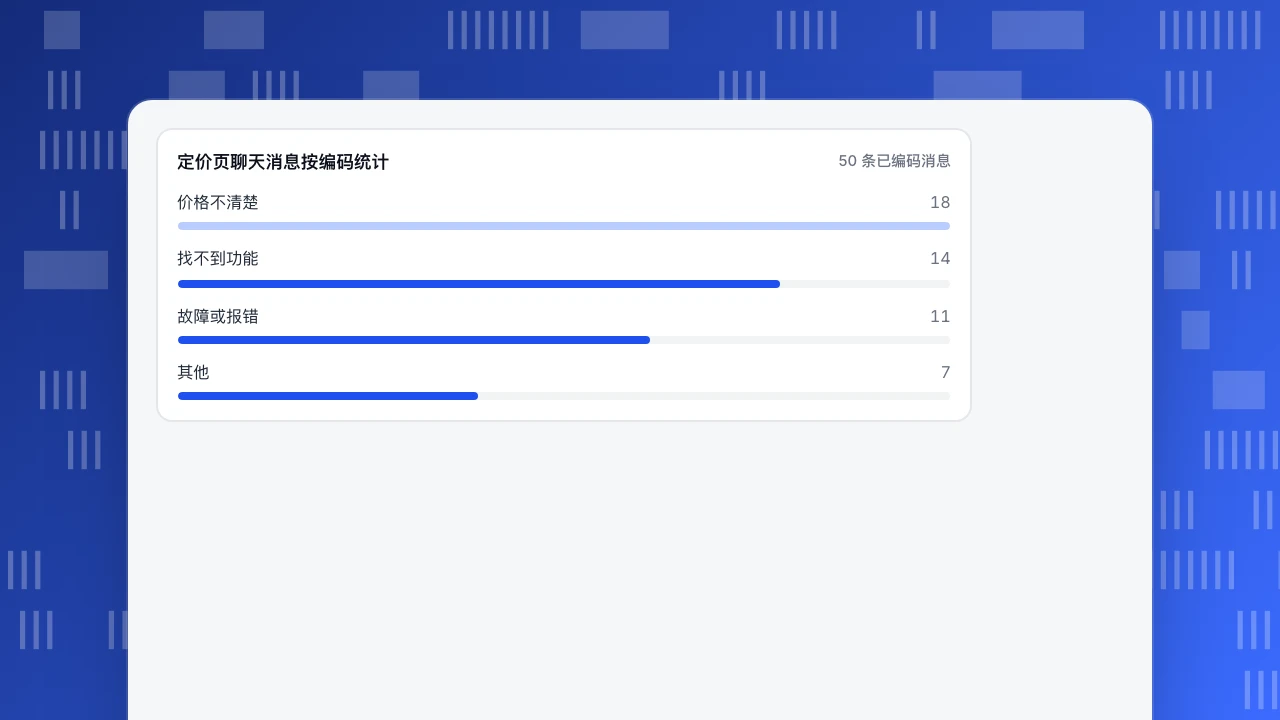
算例。 示例数据:50 条来自在定价页打开聊天的访客的消息,每条给一个主编码,归入四个类别。
| 编码 | 定义 | 消息数 | 占 50 条的比例 |
|---|---|---|---|
| 价格不清楚 | 看不出套餐包含什么或多少钱 | 18 | 36% |
| 找不到功能 | 在找产品已有或可能有的东西 | 14 | 28% |
| 故障或报错 | 某处失败了 | 11 | 22% |
| 其他 | 好评、问候、无关内容 | 7 | 14% |
计数合计 50(18 + 14 + 11 + 7),比例合计为全部。两点提醒:「其他」占 14%,足够小,编码手册大概够用(如果「其他」是最大的一组,说明编码不对);这些百分比描述的是这 50 条消息,不是全部访客,因为发起聊天的人不是随机样本。
定价页聊天消息按编码统计
50 条已编码消息怎么知道另一个人也会这样编码?
编码手册只有在第二个人得出同样标签时才有用。让另一个人独立给同样的 50 条编码,然后对照。原始一致率会高估可靠性,因为有些一致是碰巧的,所以研究者用 Cohen's kappa(Cohen,1960):(实际一致率 − 偶然一致率)÷(1 − 偶然一致率)。
示例数据:两位编码员给同样的 50 条消息编码,表里行是编码员 1,列是编码员 2(类别顺序为 价格、功能、故障、其他):
| 价格 | 功能 | 故障 | 其他 | 行合计 | |
|---|---|---|---|---|---|
| 价格 | 15 | 2 | 0 | 1 | 18 |
| 功能 | 2 | 11 | 1 | 0 | 14 |
| 故障 | 0 | 1 | 9 | 1 | 11 |
| 其他 | 1 | 0 | 1 | 5 | 7 |
| 列合计 | 18 | 14 | 11 | 7 | 50 |
- 实际一致率:(15 + 11 + 9 + 5)÷ 50 = 40 ÷ 50 = 0.80
- 偶然一致率:(18² + 14² + 11² + 7²)÷ 50² = 690 ÷ 2,500 = 0.276
- Kappa:(0.80 − 0.276)÷(1 − 0.276)= 0.724
0.72 的 kappa 落在 Landis 和 Koch(1977)基准的「较高」区间(0.61 到 0.80)。看看 10 处分歧在哪里:最集中的一处是价格和功能之间,10 处里占 4 处,说明这两个定义需要更清楚的边界。改好编码手册,再重编有分歧的消息。
定性和定量数据怎样配合?
最有效的模式是一个循环:数字找到位置,文字解释原因,数字检验改动。
| 步骤 | 问题 | 数据 | 示例结果 |
|---|---|---|---|
| 1. 定位 | 人在哪里流失? | 定量(漏斗、页面报表) | 示例数据:4,000 次定价页会话里,120 次(3.0%)继续开始注册 |
| 2. 解释 | 为什么离开? | 定性(聊天消息、回放) | 50 条已编码消息里有 18 条(36%)说看不出套餐包含什么 |
| 3. 行动 | 怎样解决最主要的原因? | 判断 | 在首屏上方加一张套餐对比表 |
| 4. 验证 | 有效吗? | 再次用定量 | 同一个漏斗步骤,接下来四周 |
第 2 步定量数据回答不了,因为漏斗记录的是人在哪里停下,从不记录他们在想什么。第 1 步和第 4 步定性数据没法有把握地回答,因为 50 条消息衡量不了一个问题的大小。开始阅读之前,想先找到摩擦点,见用户摩擦和会话回放。
哪些错误会让定性分析产生误导?
- 把编码后的计数当成总体百分比。 「36% 的消息」说的是你读过的那些消息。聊天或写评论的人是自己选择的,见选择偏差。
- 先有答案再编码。 如果你已经认定问题在价格,就会把模棱两可的消息编成价格。先写编码手册再计数,并让第二个人复核。
- 引用最生动的那条评论。 一段愤怒的话让人印象深刻,但可能很少见。在引用旁边写上计数。
- 编码太细。 50 条消息分出 30 个编码,大部分编码只有一两条。合并到每个编码都是你能采取行动的。
- 让「其他」越来越大。 如果它是最大的一组,编码手册就没有描述这些数据。
- 从不闭环。 定性发现应该落到一个可测试的改动,再回到一个数字。
在 TapCub 里怎么做?
拿定价页的例子来说,让 TapCub 提供定量的一半,对话内容提供定性的一半。TapCub 不替你给文字编码,也不做问卷;它给你消息,以及消息周围的数字。
- 定位页面。 打开客服 › 客服报表,热力图和热门页面列表给出访客发起聊天的前 10 个页面。如果定价页在这个列表里,它就是候选。
- 取出消息。 在客服 › 客服工作台里,按消息内容搜索会话列表(比如「套餐」或「价格」)并阅读这些会话。没人在线时访客留下的离线留言是第二个访客文本来源。
- 编码并标注。 编码在你自己的表格里做。在会话里用内部备注把编码记在这个会话上,之后打开它的坐席能看到。
- 加一个行为检验。 在全端分析 › 行为分析 › 会话回放里,看同一个页面的会话,确认你读到的犹豫是不是看得见。回放默认关闭,要先打开。
- 验证改动。 改完页面后,在全端分析 › 行为分析 › 行为分析里,用同样长度的时间比较同一个漏斗步骤。注意会话数在这里算的是客服会话,不是分析里的会话,不要把两个数加在一起。
常见问题
用简单的话说,什么是定性数据?
定性数据用文字、标签或观察,而不是数量来描述事物:顾客的一条消息、一份访谈笔记、一个产品类别。你阅读它,归成主题,数每个主题有多少条。它回答的是数字单独回答不了的「为什么」和「怎么回事」。
定性数据的例子有哪些?
聊天消息、访谈记录、问卷开放题答案、应用评价、取消原因、功能需求、客服备注,以及观看别人使用产品时的观察。1 到 5 的评分通常叫有序数据,不算纯粹的定性。
定性数据一定是文字吗?
不是。图片、截图、音频和视频录制,以及现场观察也是定性的。文字只是产品团队收集得最多的一种,因为收集便宜,也容易搜索。
定性数据可以变成数字吗?
可以,靠编码。给每一条分一个类别,数每个类别有多少条。这些数字描述的是你对样本的编码,不是全部用户,所以要写明样本量,以及这些人是怎么进入样本的。
定性数据读多少才够?
一直读到新消息不再产生新编码,然后让第二位编码员在一个子集上检查可靠性。没有通用的数字;关键是类别不再变化,而且两个人的编码一致。
资料来源
- NNLM(美国国家医学图书馆网络)。Data glossary: qualitative data。
- Braun, V., Clarke, V. (2006). Using thematic analysis in psychology. Qualitative Research in Psychology, 3(2), 77–101.
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46.
- Landis, J. R., Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159–174.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
