归因是决定哪个触点获得转化功劳的规则。买家下单前通常有多个触点,每个模型分配功劳的方式都不同,所以没有正确的模型,只有适合你当前决策的模型。下面是五种常见模型、一个放进所有模型里打分的订单,以及怎么选。
读完你会知道
- 归因是分配功劳的规则,不是对因果的测量
- 把同样的转化放进至少两个模型里打分;功劳相差超过两倍的渠道对模型敏感
- 按决策来选:看发起者用首次触点,看促成者用末次触点,长周期用线性或位置,短期促销用时间衰减
什么是归因,它回答什么问题?
归因(attribution)是决定哪个触点获得转化功劳的规则。买家很少一次访问就完成购买:他们可能点了一条付费社交广告,之后通过自然搜索回来,打开一封邮件,最后在点击品牌付费搜索广告后下单。这四次接触都发生在订单之前。归因就是把这一个订单及其收入分给它们的方法。
关键词是「规则」。没有任何测量能揭示每个触点真正的占比;每个归因模型都是对功劳该如何分摊的一种选择,同样的数据,不同的选择会得出不同的答案。这正是本文依据的判断:没有正确的归因模型,只有适合你当前决策的模型。 下面的算例取一个有四次接触的订单,展示同一个渠道的功劳,会因为规则不同从 200 美元变成 0。
归因分配的是功劳,不证明因果。得到功劳的渠道,可能只是买家本来就要下单时恰好在场。要证明某个渠道带来了销售,需要对照测试,在局限一节里讲。用统计方法给触点加权的进阶做法见多触点归因;本文只讲能用手算出来的规则。更简短的定义在归因一页。
五种常见的归因模型
五种基于规则的模型涵盖了大部分实际工作。列表给出每个规则,下面的表格补充各自适用的场景;之后的小节展示它们对一条真实路径的影响。
- 首次触点把全部功劳给窗口内的第一次会话。它回答「什么发起了需求?」,忽略所有促成成交的环节。
- 末次触点把全部功劳给转化之前的最后一次会话。它回答「什么促成了成交?」,忽略所有建立兴趣的环节。它最容易计算,也是多数报表的默认值;见末次点击归因。
- 线性把功劳平均分给每个触点。它把整段旅程看作团队合作,分不出决定性的触点和偶然的触点。
- 时间衰减给距离转化更近的触点更多功劳,用一个半衰期来衡量:距离转化每过一个半衰期,触点的权重减半。它适合近期曝光最重要的短期促销。
- 位置把大部分功劳给首次和末次触点,给中间触点较小的份额,例如两端各 40%,其余的共享 20%。它既重视发起,也重视成交。见位置归因。
Google Analytics 说明了这个选择在实践中有多重要:它的归因文档列出了数据驱动归因(根据每个关键事件的数据分配功劳),以及把全部关键事件价值归给最后点击渠道的末次点击模型。不同工具默认的规则不同,这是同一时期的两份报表很少吻合的原因之一。
| 模型 | 规则 | 适合 | 风险 |
|---|---|---|---|
| 首次触点 | 全部功劳给窗口内的第一次会话 | 找出哪些渠道发起旅程 | 忽略所有促成成交的环节 |
| 末次触点 | 全部功劳给转化前的最后一次会话 | 评判再营销、品牌搜索这类促成者 | 助攻得到的功劳为零 |
| 线性 | 每个触点平均分 | 每个阶段都重要的长旅程 | 分不出决定性的触点和偶然的触点 |
| 时间衰减 | 距离转化越近功劳越多(半衰期) | 短期促销 | 在长周期里低估发起者 |
| 位置 | 首次和末次触点得大头,其余共享(例如 40/20/40) | 既重视发起也重视成交 | 40/20/40 是一种约定,不是发现 |
基于规则的模型分配功劳,并不证明某个触点导致了成交。
算例:一个订单,四次接触,五种答案
示例数据:一位客户下了一个 200 美元的订单。在此之前,他有四次会话,从下单当天往前数:
| 触点 | 渠道 | 距订单的天数 |
|---|---|---|
| 1 | 付费社交 | 21 |
| 2 | 自然搜索 | 12 |
| 3 | 邮件 | 4 |
| 4 | 付费搜索 | 0(下单那次会话) |
每种规则下这 200 美元的功劳分配:
| 渠道 | 首次触点 | 末次触点 | 线性 | 位置(40/20/20/40) | 时间衰减(半衰期 7 天) |
|---|---|---|---|---|---|
| 付费社交 | 200.00 美元 | 0 美元 | 50.00 美元 | 80.00 美元 | 11.89 美元 |
| 自然搜索 | 0 美元 | 0 美元 | 50.00 美元 | 20.00 美元 | 28.99 美元 |
| 邮件 | 0 美元 | 0 美元 | 50.00 美元 | 20.00 美元 | 64.01 美元 |
| 付费搜索 | 0 美元 | 200.00 美元 | 50.00 美元 | 80.00 美元 | 95.12 美元 |
| 合计 | 200.00 美元 | 200.00 美元 | 200.00 美元 | 200.00 美元 | 200.00 美元 |
数字怎么来的。线性是 200 ÷ 4,每个触点 50。位置模型把 200 的 40% 即 80 给首次和末次触点,剩下的 20%(40)由中间两个平分,各 20。时间衰减按「2 的负(距离 ÷ 半衰期)次方」给每个触点加权,所以权重是 2^(−21/7) = 0.125、2^(−12/7) = 0.305、2^(−4/7) = 0.673 和 2^0 = 1.000;它们的和是 2.103,每个触点得到 200 乘以自己的权重再除以这个和,结果是 11.89、28.99、64.01 和 95.12。
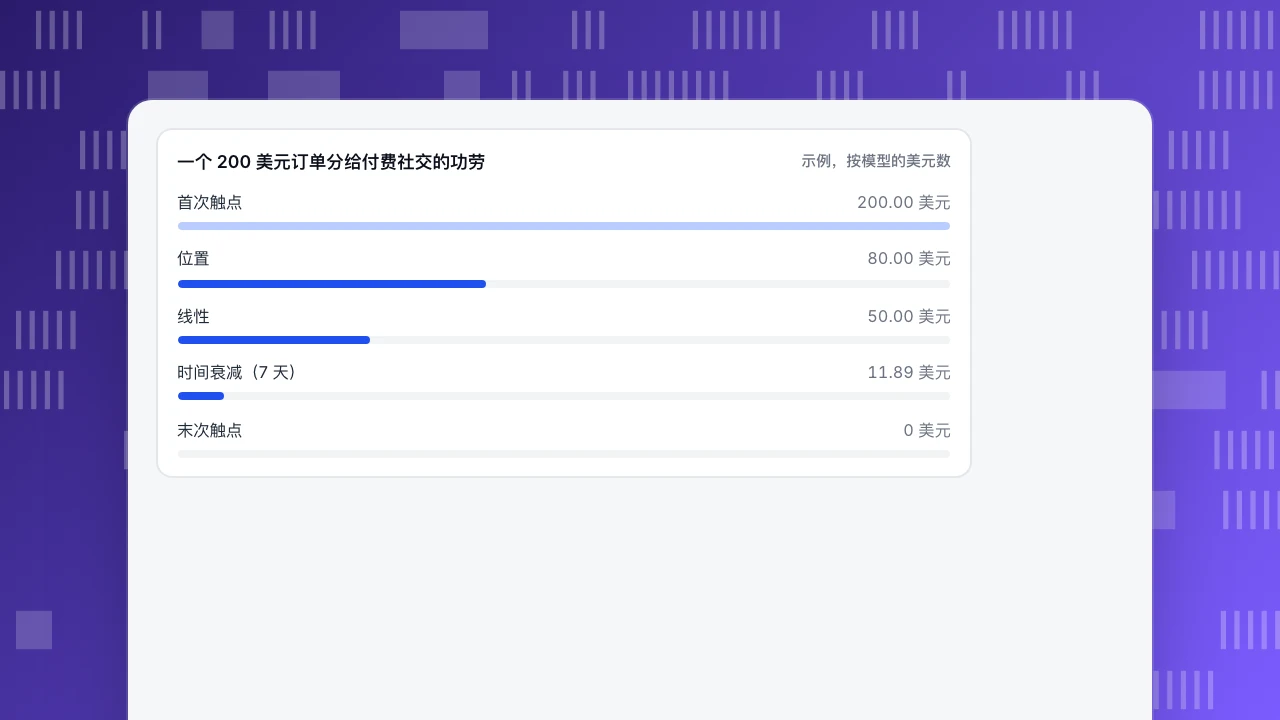
一个 200 美元订单分给付费社交的功劳
示例,按模型的美元数这个算例说明了什么
沿着任何一个渠道往下读,功劳都大幅摆动:付费社交在首次触点下是 200 美元,在末次触点下是 0 美元,在时间衰减下是 11.89 美元。邮件在末次点击下多数报表根本不会提到,它得到的是 0、50 或 64.01 美元,取决于规则。付费搜索得到 200、95.12 或 50 美元。订单和收入没变,变的只是规则。
所以并排比较模型,比选定一个更有用。在每个模型下功劳都很高的渠道,承担着真实的分量。只在末次触点下有功劳的渠道是促成者;只在首次触点下有功劳的渠道是发起者。在线性或时间衰减下出现,但在首次和末次触点下从不出现的渠道,是助攻:它很少开始或结束一段旅程,却出现在很多旅程里。在这个算例里,邮件就是助攻,只用末次点击的团队会觉得它一文不值,甚至可能把它砍掉。
敏感度本身就是信号。如果一个渠道的功劳在不同模型之间相差超过大约两倍,说明是模型在做决定,而不是数据,更稳妥的做法是先做一个小测试(在一个地区降低投入或曝光,观察变化),而不是依据一个规则就挪动预算。你的数据里旅程实际有多长,见转化路径。
怎么选模型
先从决策出发,再选能回答它的规则。
| 如果你要决定… | 先看 | 原因 |
|---|---|---|
| 去哪里找新需求(认知投放) | 首次触点 | 它显示哪些渠道发起旅程 |
| 保留哪些渠道负责成交(再营销、品牌搜索) | 末次触点 | 它显示谁完成旅程 |
| 在较长的考虑周期里怎么分预算 | 线性或位置 | 每个阶段都有功劳,不会让任何阶段饿着 |
| 一次短期促销有没有效果 | 时间衰减 | 近期曝光应该算得最多 |
然后做三项检查。一是看每个转化的平均触点数:如果接近 1,说明旅程很短,所有模型给出的答案几乎一样,用最简单的就行。二是把回看窗口设成你真实的购买周期;一个要 40 天才能决定的产品,用 7 天窗口会把发起者全部丢掉。三是不要依据单个模型行动;至少比较两个,并找出名次会变的渠道。
归因不能告诉你什么
- 它不是因果的证明。 有功劳说明触点在场,不说明它改变了结果。对照测试,也就是让一组可比的人看不到这个渠道,才是衡量因果的办法;TapCub 不做这类测试,只负责衡量。
- 它只看得到被追踪的触点。 线下沟通、私聊里转发的链接、第二台设备,或者会清除标识符的浏览器,都不在路径里。
- 它取决于窗口。 回看窗口之外的触点得不到功劳,窗口内没有会话的转化仍然是未归因的。
- 数据驱动模型是估计,不是事实。 统计方法,例如 Shao 和 Li 2011 年关于数据驱动多触点归因的论文,对观察到的路径用逻辑回归,从规律里估计每个渠道的权重。它们的质量取决于喂进去的数据。
- 不同工具之间互相不一致。 每个平台都把自己接触过的转化记在自己名下,所以各工具加起来可能超过你的订单数。总数用你自己的订单记录。
常见误区
- 寻找正确的模型。 没有这种东西;按决策来选,如上所述。
- 为了让某个渠道好看而换模型。 在看结果之前选定模型,并在整个复盘周期里保持不变。
- 因为末次点击给助攻渠道的功劳是零就砍掉它。 先看线性或时间衰减。
- 窗口比购买周期短。 发起者会消失,末次触点默认拿走全部功劳。
- 解读很小的数字。 一个只有 5 个转化的渠道,可能因为一个订单就换了名次;等到几十个再看。
- 把归因当成花费效率。 功劳除以花费,只有两边口径相同才是有意义的比值;挪动预算前,先和实测的单次获客成本对照。
在 TapCub 里并排查看归因模型
还是上面那个四次接触的订单。在 TapCub 里你可以对很多订单跑一遍,不用表格就看到同样的五列。
- 定义目标。 打开 全端分析 › 行为分析 › 行为分析,选择归因,设置度量:一个事件或页面(购买、注册),写法和漏斗步骤一样。这一项必填。
- 选择触点和窗口。 触点默认是渠道(渠道为空时退回来源渠道);也可以改成来源渠道、UTM 来源、UTM 活动、来源域名或着陆页。回看窗口默认 30 天(1 到 90 天),并包含转化那次会话本身。
- 同时选多个模型。 首次、末次、线性、位置(1 个触点全给;2 个触点各一半;更多时首尾各 40%,中间共享 20%)和时间衰减(半衰期默认 7 天,1 到 90 天)。每个选中的模型是一列已分配的转化,所以在线性里有功劳、在末次触点里没有的渠道会很显眼。TapCub 的时间衰减权重用的是从会话开始到转化的秒数,所以和上面手算的结果会有小差异。
- 读四个数字。 转化数、已归因转化数、没有任何触点的转化数,以及一个已归因转化上的平均触点数。每一行还有路径数(包含该触点的转化)、触点会话数和触点转化率(路径数 ÷ 触点会话数)。
- 了解限制。 最多计算 5 万次转化;超过之后未归因的数字会偏高。这份报告用的是转化之前的会话,不是安装回传,并且它和 全端分析 › 经营分析 › 渠道 ROI 里的花费表是分开的。
TapCub 衡量并比较这些模型;它不替你决定哪个模型是对的,也不做实验来证明因果。
常见问题
营销里的归因是什么?
归因是把一次转化(比如购买或注册)的功劳,分配给在它之前出现的营销触点的规则。因为买家通常有多个触点,你选的规则决定了哪个渠道看起来有价值。它描述的是功劳怎么分,而不是什么导致了这笔销售。
主要的归因模型有哪些?
五种常见的基于规则的模型是:首次触点、末次触点、线性、时间衰减和位置。首次和末次触点把全部功劳给一次会话;线性平均分配;时间衰减偏向近期触点;位置偏向首次和末次。数据驱动模型则用统计方法估计权重。
哪种归因模型更合适?
没有哪个模型在一般意义上是正确的;合适的那个取决于决策。首次触点显示哪些渠道发起旅程,末次触点显示哪些渠道促成成交,线性或位置在较长的周期里共享功劳。至少并排比较两个,功劳相差超过两倍的渠道要视为对模型敏感。
归因和增量有什么区别?
归因是在转化之前发生的触点之间分配功劳。增量要问的是,没有这个触点,转化还会不会发生,用对照比较来测量,比如保留一个不展示的对照组。归因成本低、随时可用;增量是更强的证据,但需要做一次测试。
回看窗口应该设多长?
和你真实的购买周期保持一致。看看客户购买前,第一次会话和最后一次会话相隔多少天,设一个能覆盖大多数人的窗口。TapCub 的默认值是 30 天,可以设为 1 到 90 天。
另见:归因模型:类型、区别和怎么选。
资料来源
- Google Analytics 帮助,Get started with attribution。
- Xuhui Shao 和 Lexin Li,Data-driven multi-touch attribution models,第 17 届 ACM SIGKDD 知识发现与数据挖掘国际会议论文集,2011。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
