一位客户先看到社交广告,过几天搜了你的品牌,又打开了一封邮件,最后直接访问网站下单。功劳算谁的?单触点模型把功劳全给首次或末次访问;多触点归因则按规则或数据,把功劳分给多个接触点。下面把常见模型都套在同一条旅程上,让你看清功劳是怎么移动的,再说明这些模型回答不了什么,以及怎样搭建才能让数字有用。
读完你会知道
- 不同模型回答不同问题;对比两三个,而不是只信一个
- 负责开启旅程的渠道,在末次触点下显得弱,在首次触点下显得强
- 归因展示的是已观测路径上的贡献,不是增量;增量要另外测试
什么是多触点归因?
多触点归因(Multi-Touch Attribution,MTA)是把一次转化的功劳分给它之前的多个营销接触点,而不是全部给其中一个。接触点通常是一次有明确来源的访问:广告点击、自然搜索、邮件、外链引荐。模型决定功劳怎么分。
目的是更公平地看清各渠道的贡献,避免因为某些渠道很少「收尾」,就砍掉那些负责「开头」的渠道预算。
单触点和多触点
单触点模型简单,但常常误导:
- 末次触点把全部功劳给最后一次访问。它偏向品牌词搜索、直接访问和邮件,而这些渠道往往是在给其他渠道开启的旅程收尾。
- 首次触点把全部功劳给首次访问。它偏向认知类渠道,忽略了真正说服人的环节。
多触点模型把功劳分摊到整条旅程上。没有哪个是「正确的」,每个模型都隐含了一个「什么更重要」的假设。下表汇总了常见模型。
常见模型
基于规则的模型是固定公式;数据驱动模型从你的转化数据中学习权重。各模型的要点见表格;下一节把它们套到同一条旅程上,让你看清这些公式到底做了什么。
| 模型 | 功劳怎么分 | 偏向 | 用来回答 |
|---|---|---|---|
| 首次触点 | 全部给首次接触 | 认知类渠道 | 什么开启了旅程? |
| 末次触点 | 全部给最后一次接触 | 收尾类渠道(直接访问、品牌词搜索、邮件) | 什么完成了旅程? |
| 线性 | 所有接触平分 | 出现频繁的渠道 | 哪些渠道参与了? |
| 位置(U 型) | 首次 40%、末次 40%,中间平分 20% | 开头和收尾的渠道 | 谁开头、谁收尾? |
| 时间衰减 | 离转化越近的接触分得越多 | 后期渠道 | 什么推动了最后一步? |
| 数据驱动 | 从转化与未转化路径中学习 | 取决于数据 | 哪些接触改变了转化概率? |
W 型模型在位置模型的基础上,增加第三个关键节点(常为留资)。
同一条旅程在五种模型下
示例数据:一位客户走向购买的路径,括号里是距离转化的天数。
- 付费社交广告点击(转化前 20 天)
- 自然搜索品牌词(转化前 12 天)
- 邮件订阅点击(转化前 3 天)
- 直接访问并购买(当天)
| 模型 | 付费社交 | 自然搜索 | 邮件 | 直接访问 |
|---|---|---|---|---|
| 首次触点 | 全部 | 0 | 0 | 0 |
| 末次触点 | 0 | 0 | 0 | 全部 |
| 线性 | 25% | 25% | 25% | 25% |
| 位置(40/20/40) | 40% | 10% | 10% | 40% |
| 时间衰减(半衰期 7 天) | 6.3% | 13.9% | 34.0% | 45.8% |
时间衰减这一行的算法:每个接触点的权重是 2^(−天数 ÷ 7),依次为 0.138、0.305、0.743、1.000,合计 2.186;每个权重除以合计就是占比。转化前 7 天的接触,分量是当天接触的一半。
同一笔购买,付费社交分到的功劳从零到全部都有可能,取决于用哪个模型。这不是挑对模型就能修好的缺陷,而正是要同时对比几个模型的原因。
三种模型下的渠道对比
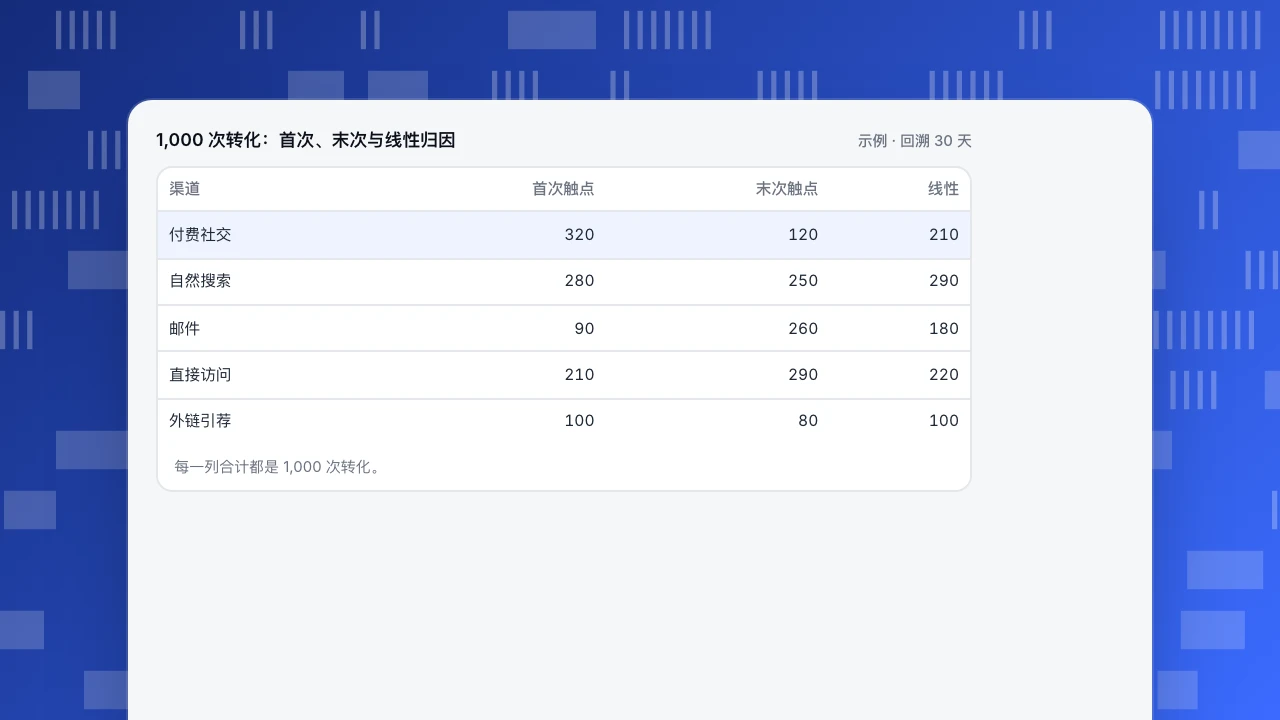
放到 1,000 次示例转化上,差异就累积起来了。付费社交开启了 320 段旅程(首次触点),却只收尾了 120 次(末次触点);邮件正好相反,90 对 260。按线性分配,两者都落在中间。如果团队只看末次触点,就会认为付费社交是最差的渠道并砍掉它,然后看到首次访问、进而后续转化一起下滑。
这张表的实际读法:用首次触点判断哪些渠道带来新人,用末次触点判断哪些渠道促成成交,用线性或位置模型讨论整体预算。
1,000 次转化:首次、末次与线性归因
示例 · 回溯 30 天| 渠道 | 首次触点 | 末次触点 | 线性 |
|---|---|---|---|
| 付费社交 | 320 | 120 | 210 |
| 自然搜索 | 280 | 250 | 290 |
| 邮件 | 90 | 260 | 180 |
| 直接访问 | 210 | 290 | 220 |
| 外链引荐 | 100 | 80 | 100 |
每一列合计都是 1,000 次转化。
数据驱动归因
数据驱动归因对比转化者和未转化者的路径,估算每个接触点让转化概率改变了多少。Google 介绍其 Analytics 和 Ads 的数据驱动归因时提到,它借鉴了合作博弈论中的沙普利值(Shapley Value):按每个参与者的边际贡献分配总收益。Dalessandro 等人(2012)等学术研究,则把归因看作估计每个渠道的因果效应。
它需要大量转化数据,更难解释,而且仍然建立在已观测到的路径上,所以同样有下面这些局限。
多触点归因回答不了什么
- 增量:归因展示的是哪些渠道出现在转化路径上,而不是这些人如果没有这个渠道会不会照样转化。品牌词搜索和再营销,在「本来就要买的人」的路径上看起来效果极好。要衡量提升,用保留组或实验;参见增量。
- 曝光:大多数基于网站的归因只看得到点击和访问,看不到「看过但没点」的广告。
- 跨设备旅程:用户不登录时,会被当成不同的人。
- 线下接触:展会、销售电话、口碑,除非导入,否则看不见。
- 同意和隐私:拒绝跟踪或屏蔽脚本的访客,会在路径上留下空缺。
- 长周期:超出回溯窗口的接触会被截掉。
做渠道级的预算决策时,很多团队会把多触点归因和营销组合模型(MMM)、定期的增量测试结合起来使用。
怎样搭建可信的归因
- 每次分析只定义一个转化:购买、注册或预约演示。
- 统一给链接打标记:每个活动链接都加 UTM 参数并遵循命名规范,否则接触点会落进「直接访问」或「外链引荐」。
- 选合适的回溯窗口:冲动型购买 7 天,B2B 30–90 天。
- 确定身份口径:访客、设备还是登录用户。登录身份能把多台设备连起来。
- 并排对比两三个模型,写下每个模型回答的问题。
- 每季度复盘一次,重大结论用增量测试验证。
归因和用户在站内的访问顺序有什么区别,见转化路径。
TapCub 里的多触点归因
归因是 全端分析 › 行为分析 › 行为分析 里的一个视图:
- 目标:一个事件或页面,写法和漏斗步骤一样。
- 触点:默认是渠道(为空时回落到来源渠道),也可以选来源渠道、UTM 来源、UTM 活动、来源域名或着陆页。
- 回溯窗口:默认 30 天,可设 1–90 天,包含转化发生的那次会话。
- 模型:首次触点、末次触点、线性、位置(只有一个接触时全给它;两个时各一半;更多时首末各 40%,中间平分 20%)和时间衰减(半衰期默认 7 天,可设 1–90 天),可同时选择,结果按列展示。
- 可选的前向事件:只保留发生在某事件(比如注册)之后的接触。
- 结果:转化数、已归因转化数、无接触的转化数、每次已归因转化的平均接触数,以及每个触点值在各模型下的功劳、转化路径和触点转化率。
每次查询最多计算 50,000 次转化。它基于站内会话;TapCub 不负责把广告点击和 App 安装做匹配。具体操作步骤见对比归因模型。
常见问题
多触点归因和单触点归因有什么区别?
单触点归因把一次转化的全部功劳给一个接触点,通常是首次或末次;多触点归因按规则或数据驱动模型,把功劳分给多个接触点。
哪个多触点归因模型最准?
没有普遍适用的答案。位置模型适合作为讨论预算的默认选择;首次触点回答什么带来新人;末次触点回答什么促成成交。对比两三个模型,重大决策再用增量测试确认。
什么是 U 型归因模型?
一种位置模型:首次接触得 40%,末次接触得 40%,剩下的 20% 由中间的接触平分。
隐私法规下还能做多触点归因吗?
能,但有边界。自有网站上自己做的统计依然能看到访问和来源;主要的缺口是未登录的跨设备旅程、广告曝光,以及拒绝跟踪的访客。
资料来源
- Google Analytics 帮助,归因入门。
- Google Ads 帮助,关于数据驱动归因。
- Dalessandro, B., Perlich, C., Stitelman, O. and Provost, F. (2012). Causally Motivated Attribution for Online Advertising. ADKDD '12.
- Shapley, L. S. (1953). A Value for n-Person Games. 收录于 Contributions to the Theory of Games II. Princeton University Press.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
