提升 CSAT 要先看低分,而不是平均分。把近 30 天所有打了 1 分、2 分的对话读一遍,每段标一个原因。多数队列里,低分集中在等太久和问题没解决上,而不是客服态度,所以修排班、预期和解决能力,比培训语气更能拉动分数。下面是公式、原因盘点、一个算例,以及怎样验证改动。
读完你会知道
- 改任何东西之前,先把 1 分和 2 分的对话按原因归类;平均分会把问题藏起来
- 等待和没解决通常比语气影响更大:先修排班、预期和客服的处理权限
- 在改动针对的那一组里验证;300 个评分时,5 个百分点以内的变动可能只是波动
CSAT 衡量什么,怎么算
CSAT(客户满意度得分)是有评分的服务里,客户打出「满意」的那部分占比。按常见的 1–5 分制,「满意」指 4 分或 5 分:
CSAT = 4 分和 5 分的评分数 ÷ 全部评分数 × 100
如果 300 位客户给聊天打了分,其中 226 位打 4 分或 5 分,CSAT 就是 226 ÷ 300 = 75.3%。CSAT 计算器 可以用你自己的数字算出来,并且把分数分布一起列出。
有些团队报的是平均分(比如 4.1 分,满分 5 分)。两种都能用来看趋势,但各自藏住的东西不一样。1–5 分评分是 定序变量:分数有先后顺序,但 1 分到 2 分的距离不一定等于 4 分到 5 分的距离。Stevens 关于测量尺度的经典论文讲的就是这一点:算平均数默认间隔相等,而定序数据没有这个性质。
举个具体的例子就明白了。A 组收到 100 个评分:90 个 4 分、5 个 3 分和 5 个 5 分:平均 (360 + 15 + 25) ÷ 100 = 4.0,CSAT 95%。B 组收到 20 个 1 分、20 个 4 分和 60 个 5 分:平均 (20 + 80 + 300) ÷ 100 = 4.0,CSAT 80%。平均分一样,但其中一组有五分之一的客户非常不满意。不管你对外报哪个数,都要看它底下的低分,提升空间就在那里。
先看低分,不要先看平均分
提升 CSAT 最快的办法不是开一个新项目,而是把打了 1 分、2 分的对话读一遍,按原因归类。多数客服队列里,低分集中在少数几个流程问题上,客户等太久,或者问题没解决,而不是客服态度。做一次 30 天的盘点,就知道你那里是不是这样:
- 导出近 30 天所有 1 分和 2 分的对话,带上聊天记录、等待时长和是否解决。
- 每段对话只标一个主要原因,用一份固定的短清单(见下表)。两个原因都沾边时,选那个「修好了就不会打低分」的。
- 按原因计数,再看周边条件:时段、等待区间、话题、坐席。
- 把客服能管的和管不了的分开。 产品坏了打 1 分是真实反馈,但培训客服解决不了它。
下面这张表列出值得标的原因、在聊天记录里怎么认出来,以及通常怎么修。清单要短;原因列到十几个,盘点就变成了争论标签怎么贴。
| 原因 | 聊天记录里的信号 | 通常的修法 |
|---|---|---|
| 等太久 | 人工头一次回复前空了很久;客户发「在吗?」 | 高峰加人;写明预计等待时间;离线表单写清真实回复时间 |
| 没解决 | 没给答案,或客户为同一问题又来 | 补知识空白;常见问题让客服自己处理 |
| 重复说明或被转接 | 客户重新解释;经手不止一个坐席 | 按话题分配;转接时附摘要 |
| 规定不允许 | 请求被拒且没有替代方案 | 说清你能做什么 |
| 产品故障 | 缺陷、故障或缺功能 | 转给产品团队;不算进客服 CSAT |
| 客服态度 | 套话、推责、没有承认问题 | 用具体措辞辅导 |
每段低分对话只标一个主要原因:修好它就不会打低分的那个。
算例:300 个评分按等待时长分组
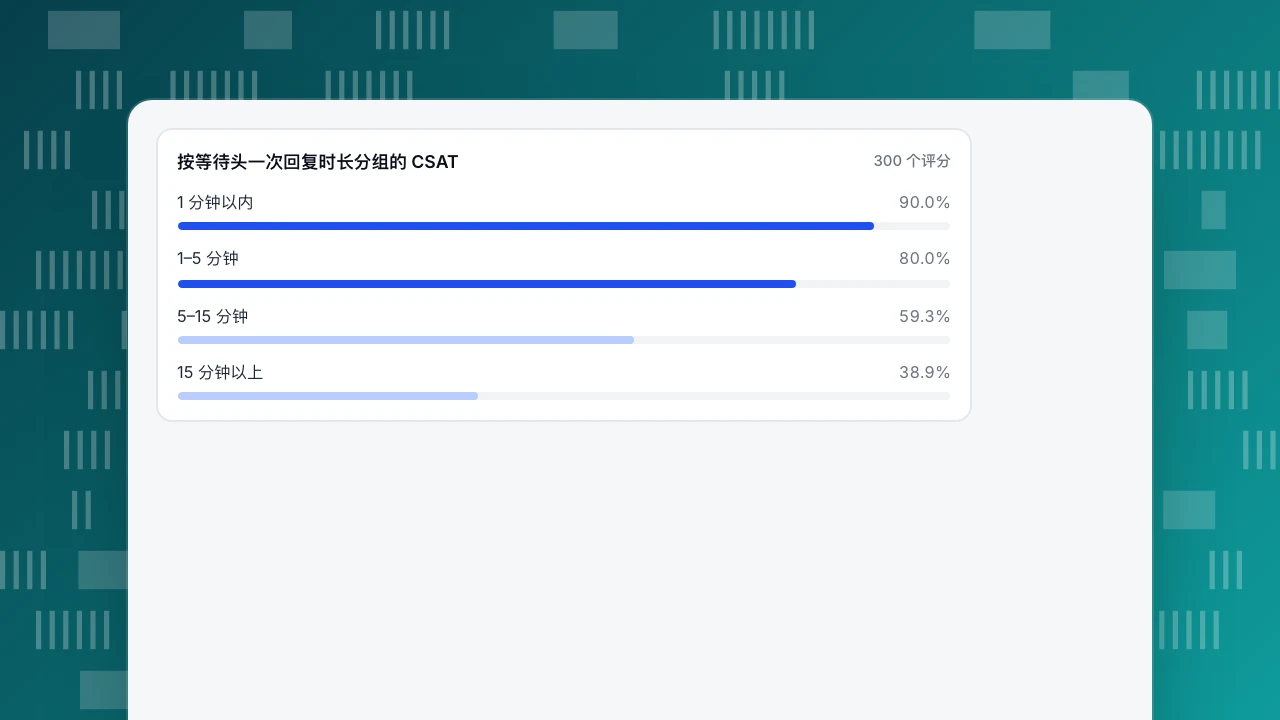
示例数据:一家网店一个月内收到 300 个已解决聊天的评分,按客户等到人工头一次回复的时长分组。
| 等待头一次回复 | 评分数 | 4–5 分 | 3 分 | 1–2 分 | CSAT |
|---|---|---|---|---|---|
| 1 分钟以内 | 120 | 108 | 6 | 6 | 108 ÷ 120 = 90.0% |
| 1–5 分钟 | 90 | 72 | 10 | 8 | 72 ÷ 90 = 80.0% |
| 5–15 分钟 | 54 | 32 | 8 | 14 | 32 ÷ 54 = 59.3% |
| 15 分钟以上 | 36 | 14 | 2 | 20 | 14 ÷ 36 = 38.9% |
| 合计 | 300 | 226 | 26 | 48 | 226 ÷ 300 = 75.3% |
有两点很明显。等得越久,CSAT 越低,从 90.0% 一路掉到 38.9%。而等待超过五分钟的 90 段聊天,贡献了 48 个低分里的 14 + 20 = 34 个:34 ÷ 48 = 70.8%,可它们只占评分对话的不到三分之一(90 ÷ 300 = 30%)。
再看 48 个低分的原因盘点:
- 等太久:19
- 没解决(没给答案,或者给的办法不管用):14
- 要重复说明或被转接:6
- 规定不允许:4
- 产品故障,不是客服的问题:3
- 客服态度:2
等待和没解决加起来占 48 个低分里的 19 + 14 = 33 个,即 68.8%。客服态度占 48 个里的 2 个,即 4.2%。如果团队看到 CSAT 下滑就去办礼貌培训,处理的恰恰是最小的那一块。
把等待修好值多少?如果等待超过五分钟的 90 段聊天能拿到 1–5 分钟那一档的成绩(80.0%),满意评分会是 0.80 × 90 = 72 个,而不是现在的 32 + 14 = 46 个。CSAT 会从 226 ÷ 300 = 75.3% 变成 (226 − 46 + 72) ÷ 300 = 252 ÷ 300 = 84.0%。这个数要当成上限来看:长时间等待发生在高峰时段,那时的问题可能也更难,光回得快拿不全这部分。
按等待头一次回复时长分组的 CSAT
300 个评分先修等待:响应时间和预期
低分主要来自等待时,有两个抓手:少等一点,以及让躲不开的等待感觉短一点。
少等一点。 按一周里的每个小时看 首次响应 时间,不要只看月平均;平均数会把周一上午的排队藏起来。按高峰排班,不按平均排班。首次响应时间计算器 可以用你自己的时间戳算出这个数,在线客服排班计算器 可以估算每小时需要几个坐席。
让等待感觉短一点。 David Maister 1985 年那篇讲排队心理的文章提出的几条命题,至今仍很贴合客服队列,其中包括:不确定的等待比明确、有尽头的等待感觉更长;没有解释的等待比有解释的感觉更长。落到实处:
- 告诉客户大概要等多久:「我们一般 10 分钟内回复」比一片沉默好。
- 需要时间就说你在查什么、要多久。
- 没人能回的时候别显示「在线」。在没人值守的时段,一个写明真实回复时间(「明天上午 10 点前」)的离线表单,比看起来在线、其实没人的聊天窗口好。
从算例里能得出一条经验:如果超过四分之一的低分来自等待超过五分钟,先修排班和预期,别的都往后放。
再修「没解决」:解决率和转接
第二大块是没解决就结束的对话。要跟踪 解决率,但读的时候要挑剔:标了已解决、两天后客户又回来的,其实没解决。
针对「没解决」的改动:
- 补上知识空白。 读「没解决」的聊天记录,找出背后的问题。如果是客服不知道答案,就把答案写到大家都找得到的地方。
- 常见问题让客服自己能处理。 如果一定金额以下的退款也要主管批,那每段这样的对话都会以「我帮您转给同事」收尾。定一个客服能自己做主的额度。
- 减少转接。 每转一次,客户就要再说一遍。一开始就按话题分配;实在要转,附一段文字摘要,让客户不用从头讲。
- 说好跟进就要跟进。 「我稍后回复您」却不给时间,就是一个未来的低分。
这和 Dixon、Freeman、Toman 2010 年在《哈佛商业评论》上的观点一致:客户更认可让问题容易解决的公司,而不是想方设法超出预期的公司。费劲,也就是重复说明、等待、被转接,才是算例里大部分低分的来源。
最后修对话本身:语气和培训
语气确实重要,只是没有团队以为的那么常见。等待和解决率控制住以后,再从剩下的低分里找语气问题:套话、没有承认问题、拿规定挡人。修法是具体的措辞,而不是「态度好一点」:先用一句话点出客户的实际问题,紧接着给出动作。例子见 共情句,辅导的方法见 客服培训。
想在客户打 1 分之前就发现他不高兴,可以在对话进行中读消息里的情绪;怎么衡量见 客户情绪。
排优先级:先改哪一项
按「能解决多少低分」和「要花多少力气」给改动排序。用上面的示例盘点:
| 改动 | 能解决的低分(共 48 个) | 投入 | 怎么知道有效 |
|---|---|---|---|
| 高峰时段加人;写明预计等待时间 | 19(等太久) | 中 | 超过 5 分钟那两档的 CSAT 上升 |
| 补知识空白;常见问题客服自己处理 | 14(没解决) | 中 | 同一话题的重复联系变少 |
| 按话题分配;转接时附摘要 | 6(重复说明或被转接) | 低 | 每 100 段对话的转接次数下降 |
| 只能拒绝时给替代方案 | 4(规定) | 低 | 规定类对话的 1 分变少 |
| 产品故障转给产品团队 | 3(产品) | 低 | 单独跟踪,不算进客服 CSAT |
| 用具体措辞辅导语气 | 2(语气) | 低 | 抽查样本通过检查清单 |
前两行覆盖了 48 个低分里的 33 个。先做这两项,哪怕下面几行更容易做。
怎样确认改动有效
CSAT 变动的原因很多,每项改动都要有意识地验证:
- 同类比同类。 看改动针对的那一组(比如等待超过 5 分钟的两档)改之前和改之后的 CSAT,而不是只看总分。
- 注意样本量。 300 个评分、CSAT 在 75% 左右时,95% 置信水平下的误差范围大约是 ±4.9 个百分点(1.96 × √(0.753 × 0.247 ÷ 300) ≈ 0.049)。一个月里从 75% 变到 78% 可能只是波动;从 75.3% 变到 84.0% 就不是。
- 盯着评分率。 如果愿意打分的客户比例大幅下降,剩下打分的人可能代表不了所有人。
- 保持构成稳定。 赶上发货延迟的那个月,不管你改了什么分数都会低。把大事件记下来,按话题逐个比。
提升 CSAT 时的常见误区
- 只看平均分。 就像 A 组和 B 组的例子,同样的平均分,底下不满意的客户比例可能差很多。
- 向客户要 5 分。 「麻烦给我打 5 分」会抬高分数,也让它失去信号的意义。
- 把产品问题算到客服头上。 产品故障单独标出来,别为客服管不了的事去辅导客服。
- 只调查已解决的对话,忽略等不下去走掉的客户。他们从不打分,而且往往是最不满意的那批人。
- 直接比较不同渠道。 邮件和聊天的客户预期不同;每个渠道只和自己的过去比。
在 TapCub 里怎么提升 CSAT
上面 300 段聊天的例子,在 TapCub 在线客服里这样做:
- 在一个页面看分数和驱动因素。 客服 › 客服报表 显示满意度(对话解决后 24 小时内访客可以打 1–5 分,每段对话一个分数,取平均保留一位小数)、平均首次响应(只算人工回复,旁边同时显示中位数;AI 回复不算)和解决率(已解决 ÷ 全部会话),每项都和上一期对比。TapCub 报的满意度是平均分;如果你的团队按 4 分和 5 分的占比报 CSAT,就从有评分的对话里数出来,再用 CSAT 计算器算。
- 找出低分并读一遍。 在 客服 › 客服工作台 里,「已结束」列表显示每段对话的满意度评分,可以逐个打开 1 分和 2 分的对话标原因。报表里每个坐席的工作量和满意度,能看出低分是集中在某个人身上,还是跟着排队走。
- 把排队情况和工作时间对齐。 报表的热力图按星期和小时统计对话发起数;把它和 客服 › 聊天设置 › 工作时间 里设定的值守时段放在一起看。如果等待超过 5 分钟的对话正好落在没人值守的时段,那些时段访客看到的是离线问候语和留邮箱、写问题的表单,在 客服 › 聊天设置 › 离线留言 里处理(状态:新、已回复、已关闭)。离线留言单独计数,不算已解决。
- 把造成等待的回复缩短。 把最常见问题的答案存进 客服 › 常用语;客服输入
/插入,发送前可以修改。如果用 AI 回复,客服 › 聊天设置 › AI 接待 里的「仅坐席全离线时」模式,能保证有人在线时由人来回答。 - 一个月后复查同一组。 比较同样时段、同样话题的满意度和首次响应,而不是总平均分;在宣布改动有效之前,先想想误差范围。
常见问题
CSAT 多少算好?
没有通用的标准,取决于行业、渠道和你怎么问。跟踪自己的基线,更重要的是看基线底下 1 分和 2 分的占比。一个 75% 的团队,如果低分大多集中在长时间等待上,改进路径反而比一个 85%、低分散落在各种原因上的团队更清楚。
提升 CSAT 最快的办法是什么?
把近 30 天打了 1 分和 2 分的对话读一遍,每段标一个原因。如果大多来自等太久或没解决,就先修这两项:高峰时段加人,写明预计等待时间,常见问题让客服不用升级就能处理。这些改动通常比语气培训更能拉动 CSAT。
响应时间怎样影响 CSAT?
多数队列里,等得越久满意度越低。本文的示例中,1 分钟内回复的 CSAT 是 90.0%,等待超过 15 分钟的降到 38.9%。告诉客户要等多久也有帮助,因为不确定、没有解释的等待,比明确知道时长的等待感觉更长。
该用平均分还是满意客户占比?
两种都能看趋势,但 4 分和 5 分的占比更容易理解,也不容易被少数极端评分带偏。不管用哪种,都要同时看分布:两个团队平均分都是 4.0,其中一个可能有五分之一的客户打了 1 分。
需要多少个评分才能看出真正的变化?
比多数团队以为的要多。300 个评分、CSAT 在 75% 左右时,95% 置信水平下的误差范围约为 ±4.9 个百分点,所以一个月里变动三个点可能只是波动。要比较改动针对的那一组,并且积累足够周数,凑够几百个评分再下结论。
资料来源
- David H. Maister. The Psychology of Waiting Lines(1985):包括「不确定的等待比明确、有尽头的等待更长」「没有解释的等待比有解释的更长」等命题。2026-11-15 核对。
- Matthew Dixon、Karen Freeman、Nicholas Toman. Stop Trying to Delight Your Customers. 《哈佛商业评论》2010 年 7–8 月:减少客户费力程度与超出预期的比较。2026-11-15 核对。
- S. S. Stevens. On the Theory of Scales of Measurement. Science 103(2684),1946:定类、定序、定距、定比四种尺度及各自允许的统计方法。2026-11-15 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
