收集用户反馈,要在对方刚完成一件真实任务之后,用匹配问题的方法去问,再把他们说的和做的对照。任务中途询问会打断人、拉低回答率,而少数回答者给出的评分,说明不了沉默的大多数。下面是方法、时机规则、一个算例和几个陷阱。
读完你会知道
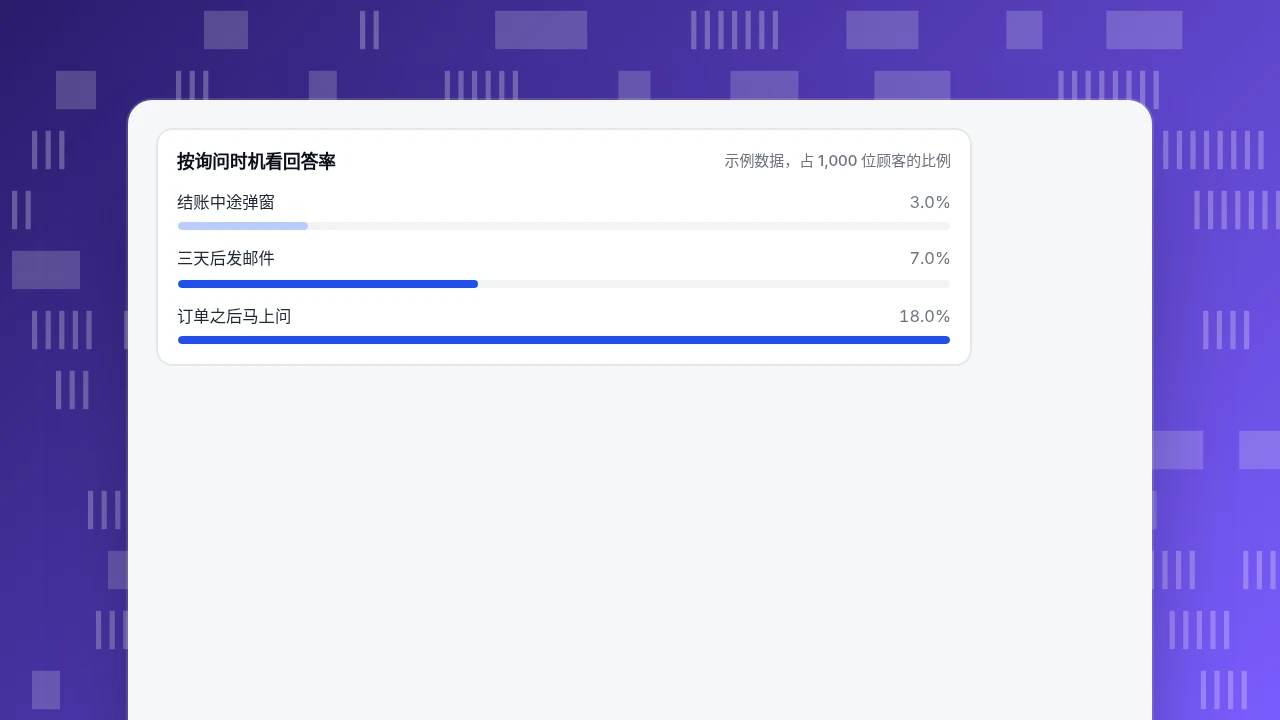
- 任务完成之后再问;示例里同一个问题,订单之后问的回答率是 18%,结账中途弹窗只有 3%
- 让方法匹配问题:评分用来看某个时刻的感受,客服对话用来发现问题,行为数据用来看在哪里
- 200 段对话里的 46 个评分只覆盖 23% 的人;真实的满意度可能在 17.5% 到 94.5% 之间的任何位置
什么算用户反馈?
用户反馈是用户对你的产品、客服或网站的体验所说的任何话。它分两种,处理方式不同:
- 陈述式反馈:人们说出来的。评分、问卷答案、客服消息、访谈里的话、评价。
- 观察到的行为:人们做出来的。在哪一步从漏斗里流失、反复点击什么、离开哪些页面。严格说它不算反馈,但它能告诉你陈述式反馈是否符合实际。
陈述式反馈解释“为什么”;行为显示“在哪里”和“多少”。5 分制里打 2 分,说明有人不满;漏斗则告诉你 40% 的人没走过运费那一步。两者都需要,本文余下部分讲的是:在最有用的时刻收集陈述式反馈,再用行为数据去核对。如果你想知道问卷里该问什么,那有单独的指南:反馈问题。
哪种方法适合哪个问题?
根据你想回答的问题选方法,而不是根据你手上已有的工具。
| 方法 | 最适合在何时问 | 能学到什么 | 主要局限 |
|---|---|---|---|
| 产品内评分(一个问题) | 任务刚完成之后 | 某个具体时刻的感受 | 字数少;回答的人是自己选择的 |
| 简短问卷(3–5 题) | 里程碑之后(首单、完成引导) | 分数背后的原因 | 超过一分钟左右就快速流失 |
| 客服对话 | 客户来信的任何时候 | 用他们自己的话说出的真实问题 | 只有愿意开口问的人 |
| 访谈 | 开发之前,或出现意外结果之后 | 背景和动机 | 人数少、耗时 |
| 可用性测试 | 上线前,或某个流程表现不佳时 | 人们卡在哪里 | 是实验室里的任务,不是真实使用 |
| 行为数据(漏斗、热力图、回放) | 持续进行 | 大规模下人们实际做了什么 | 说明在哪里,不说明为什么 |
| 常开渠道(反馈链接、离线留言) | 一直开着 | 你没想到要问的问题 | 没有结构;数量少 |
单看哪一行都不够。常见的做法是:用行为数据找到那一步,用客服对话和评分听原因,再用少量访谈验证解释。
| 方法 | 最适合在何时问 | 能学到什么 | 主要局限 |
|---|---|---|---|
| 产品内评分 | 任务刚完成之后 | 某个具体时刻的感受 | 字数少;回答的人是自己选择的 |
| 简短问卷(3–5 题) | 里程碑之后 | 分数背后的原因 | 超过一分钟左右就流失 |
| 客服对话 | 客户来信的任何时候 | 用他们自己的话说出的真实问题 | 只有愿意开口问的人 |
| 访谈 | 开发之前或出现意外之后 | 背景和动机 | 人数少 |
| 可用性测试 | 上线前或某流程表现不佳时 | 人们卡在哪里 | 实验室任务 |
| 行为数据 | 持续进行 | 人们实际做了什么 | 说明在哪里,不说明为什么 |
| 常开渠道 | 一直开着 | 你没想到要问的问题 | 没有结构,数量少 |
至少把一个陈述式来源和一个行为来源结合起来。
什么时候该问反馈?
在对方做完一件事之后问,不要在做的过程中问。Nielsen Norman Group 关于反馈请求的指南把这条放在首位:等用户完成真实任务再问,因为过早弹出的窗口会打断任务、带来低质量的回答;提示要克制,同时提供一个随时可用的反馈入口(出处)。同一份指南还说问卷要短,约一分钟,并事先说明题数。
实际操作中,把请求绑在事件上,不要绑在计时器上:
- 订单确认或付款完成:问结账体验。
- 对话已解决:问这次对话怎么样。
- 导出、报表或设置完成:问是否达到了想要的效果。
- 完成一个引导步骤:问还有什么不清楚。
- 取消或退出流程:问原因,只问一次,给一个简短的原因列表。
示例数据:一家店用三种方式问同一个单题评分,每种面向 1,000 位顾客。
| 何时询问 | 回答数 | 回答率 | 备注 |
|---|---|---|---|
| 结账中途弹窗 | 30 | 3.0% | 30 条里有 22 条是在抱怨弹窗或延迟 |
| 订单确认之后马上问 | 180 | 18.0% | 多数在谈结账和配送 |
| 三天后发邮件 | 70 | 7.0% | 更多谈产品;对结账的记忆很弱 |
只是示例数据,但形状才是重点:同一个问题,在任务之后问,回答是六倍,而且回答谈的正是你想了解的事。
按询问时机看回答率
示例数据,占 1,000 位顾客的比例需要多少份回答?
取决于你打算用这些回答做什么。
要发现问题,几个人就够。 Nielsen Norman Group 的模型是:用 n 个用户发现的问题数为 N × (1 − (1 − L)ⁿ),L 是单个用户能暴露的问题占比,他们的项目里约为 31%(出处)。算出来:1 个用户发现 31%,3 个 67%,5 个 84%,10 个 98%,15 个 99.6%。建议做几轮每轮约五人的小测试,轮与轮之间修复,而不是做一次大研究。
要测一个比率,需要更多。 46 份回答得出的满意度百分比,误差范围很宽:满意度 76% 时,正态近似的 95% 区间约为 ±12 个百分点(64% 到 88%)。不要对一个建立在 46 份回答上的数字报告一个百分点的变化。
要决定做什么,数有多少个不同的人提到了同一个问题,而不是某一个人的声音有多大。
算例:200 次对话里的 46 个评分说明了什么
示例数据:客服团队一个月解决了 200 段对话,收到 46 个 1–5 分的评分。
| 分数 | 1 | 2 | 3 | 4 | 5 | 合计 |
|---|---|---|---|---|---|---|
| 数量 | 2 | 3 | 6 | 15 | 20 | 46 |
- 回答率:46 ÷ 200 = 23%。
- 平均分:(1×2 + 2×3 + 3×6 + 4×15 + 5×20) ÷ 46 = 186 ÷ 46 = 4.04。
- 4 分和 5 分的占比:(15 + 20) ÷ 46 = 76.1%,95% 区间约 64% 到 88%。
接下来是容易漏掉的部分。没有回答的 154 个人不在这些数字里。如果他们全都不满意,200 人里只有 35 人满意:17.5%。如果他们全都满意,就是 (35 + 154) ÷ 200 = 94.5%。数据没法告诉你真相落在这个区间的哪里。你只能说“在选择评分的人当中,76% 是满意的”。想了解沉默的大多数,就要看他们实际做了什么:一周内是否又来信、是否离开、是否下单。
所以评分更适合作为一项输入,和行为放在一起看,而不是当成全貌。
拿到反馈之后该做什么?
只收集不行动的反馈,什么都改变不了。一个轻量的循环:
- 每条反馈到达时打一个主题标签(结账、配送、设置、价格、某个功能)。
- 每周按人数统计主题。 十个人提到运费,比一个人对边角情况的长篇抱怨更重要。
- 用行为核对排名靠前的主题。 如果运费是首要主题,漏斗里在费用出现的那一步是否有流失?如果有,你就有了原因和位置;如果没有,声音最大的抱怨未必是最大的问题。找位置可以看用户摩擦。
- 只改一件事,并告诉大家。 告诉提出这件事的人。一句简短的“你们提了,我们改了”,会让下一次请求更容易得到回应。
- 改完之后重测同一个分数,回答数要够,才能看出差异。
想提高满意度分数,可以看怎样提高 CSAT;CSAT 计算器可以帮你算。
哪些错误会让反馈产生误导?
- 在任务中途询问。 它会打断人,拉低回答率,让回答偏向恼火,示例里就是这样。
- 把回答的人当成所有人。 200 里的 46 是 23%;其余 77% 是未知,不是满意。
- 问卷太长。 超过约一分钟,完成率下降,能答完的人也不典型。
- 引导性提问。 “我们的服务有多棒?”和“这次对话怎么样?”得到的答案不一样。
- 太频繁地问同一批人。 设一个冷却期,只在有意义的时刻之后问。
- 收集了却没有要做的决定。 发出去之前,先写下如果结果偏低你打算改什么。
- 忽略安静的反馈。 一声不吭就离开的人也是反馈;去读你的流失数据。
怎样在 TapCub 里收集反馈?
下面以上面的客服例子,说明以客服为主的团队怎样用 TapCub 收集。TapCub 提供客服满意度评分和行为数据;它不做问卷。
- 让访客给已解决的对话打分。 坐席在客服 › 客服工作台点解决之后,访客可以在 24 小时内给这段对话打 1 到 5 分。分数显示在已解决的对话上。
- 读平均分和变化。 客服 › 客服报表把满意度显示成保留一位小数的平均分(每段对话一个分数),并给出相对上一周期的变化,工作量表里也按坐席显示。如果只有 AI 回答、解决之前没有坐席写过话,分数记在 AI 名下,不记给某个人。示例表里每个分数的数量要你自己统计,因为只看平均分,看不出分布是否偏斜。
- 保留一个常开渠道。 客服 › 聊天设置 › 离线留言让访客在没人在线时留下邮箱和问题;状态分新、已回复、已关闭。把这些留言当作自由文本反馈来打标签。
- 在合适的地方就地询问。 客服 › 聊天设置 › 主动邀请可以在访客在某页停留一定秒数后发出消息,例如订单确认页。它邀请访客发起聊天,所以要先想好谁来回答,只用在少数高价值的时刻,不要对每个访客都发。
- 看人们做了什么。 全端分析 › 行为分析 › 行为分析里的漏斗显示人们在哪里流失,热力图和会话回放(默认关闭)显示他们在那一页做了什么。
TapCub 不做问卷(NPS 或 CES)和页面内的评分组件,这类用专门工具,行为核对留在 TapCub 里做。
FAQ
收集用户反馈有什么好办法?
没有单一的方法,要和问题匹配。任务刚完成就用单题评分衡量某个时刻的感受,用客服对话和常开渠道发现你没预料到的问题,用访谈了解动机,用行为数据看人们实际在哪里吃力。至少把一个陈述式来源和一个行为来源结合起来。
什么时候问用户反馈合适?
在用户完成一件真实的事之后:订单确认、对话解决、设置完成。Nielsen Norman Group 建议等任务完成再问,因为过早的弹窗会打断人、带来低质量回答。示例里订单之后询问的回答率是 18%,结账中途弹窗只有 3%。
反馈需要多少用户?
要发现可用性问题,每轮约五个用户能发现大约 84%,所以做小轮次,轮间修复。要测满意度这类比率,需要多得多:46 份回答的误差约 ±12 个百分点。选样本量之前,先想清楚你要的是问题还是一个数字。
怎样得到用户的真实反馈?
在任务之后问,控制在一分钟左右,措辞中立,说明答案会怎么用。提供可选的自由文本框和随时可用的反馈链接。然后把人们说的和做的对照;行为是对说法的核查。
用户反馈和客户反馈有什么区别?
用户反馈关于使用产品或网站:可用性、功能、缺陷。客户反馈更宽,包括购买、配送、客服和价格。收集方法相同;不同的是询问的时刻和对象,所以团队常把两者放在同一个流程里。
资料来源
- Nielsen Norman Group。User-Feedback Requests: 5 Guidelines:先完成任务再询问;问卷要短;使用灵活的格式。核对于 2026-11-19。
- Jakob Nielsen。Why You Only Need to Test with 5 Users,Nielsen Norman Group:问题发现公式和 31% 这个数字。核对于 2026-11-19。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
