PII 示例分三组:直接标识符(姓名、邮箱、电话、家庭住址、身份证号)、间接标识符(IP 地址、设备 ID、出生日期、邮政编码、浏览器指纹)和敏感类别(健康、生物特征、种族、宗教)。对分析来说默认做法很简单:不收集;非收不可就泛化。本文列出 20 个例子和各自的处理规则。本文不是法律意见。
读完你会知道
- 把字段分成直接、间接或敏感;每组需要不同的默认处理
- 大多数 PII 是不小心进入分析的,途径是网址、自由文本框和事件属性
- 示例审计中,30 个属性里有 12 个(40.0%)能识别或可关联到个人
用一条工作规则判断:什么算 PII?
PII,即个人身份信息,是指单独或与其他信息结合后能识别某个人的任何信息。NIST 面向美国联邦机构的指南把它分成两部分:能够区分或追溯个人身份的信息,比如姓名或社会安全号码;以及与个人关联或可关联的其他信息,比如医疗、教育、金融或就业信息(NIST SP 800-122)。欧盟 GDPR 用的是更宽的术语“个人数据”:“与已识别或可识别的自然人有关的任何信息”(第 4 条第 1 款),姓名、位置数据或在线标识符都是识别一个人的方式。
本文不重新下定义,定义请看 PII 术语页。它做的是对分析工作更有用的事:列出分三组的 20 个具体例子,指出哪些会混进埋点数据,并给每个例子一条处理规则。对任何拿不准的字段,可以用这个工作检验:
一个人只要付出合理的努力,或者再拿到另一份数据集,能不能判断出这条数据属于谁?
答案是“能”或“可能”,就先当作个人信息处理,直到你的隐私负责人另有结论。这是实用指南,不是法律意见,定义因法律和国家而异。
这 20 个例子分别属于哪一组?
分三组有用,因为它们需要不同的处理:直接标识符能点名或联系到一个人;间接标识符只有组合起来才指向一个人;敏感类别一旦暴露,造成的伤害更大。
| # | 例子 | 分组 | 分析里通常需要吗 | 默认处理 |
|---|---|---|---|---|
| 1 | 全名 | 直接 | 不需要 | 不收集 |
| 2 | 电子邮箱 | 直接 | 很少 | 不收集;确需匹配键时做哈希 |
| 3 | 电话号码 | 直接 | 不需要 | 不收集 |
| 4 | 家庭住址 | 直接 | 不需要 | 不收集;保留国家或地区 |
| 5 | 身份证号或社会安全号码 | 直接 | 不需要 | 绝不收集 |
| 6 | 护照号码 | 直接 | 不需要 | 绝不收集 |
| 7 | 银行卡号 | 直接 | 不需要 | 绝不收集;误填时脱敏 |
| 8 | IP 地址 | 间接 | 不需要 | 推出国家后截断或丢弃 |
| 9 | 设备 ID 或广告 ID | 间接 | 有时 | 仅在有同意和明确用途时使用 |
| 10 | Cookie 或持久访客 ID | 间接 | 有时 | 优先用轮换或无 Cookie 的标识 |
| 11 | 出生日期 | 间接 | 很少 | 保留年份或年龄段 |
| 12 | 邮政编码 | 间接 | 很少 | 保留地区或只留前几位 |
| 13 | 职位加雇主 | 间接 | 仅 B2B | 保留公司层面的字段 |
| 14 | 精确位置 | 间接 | 不需要 | 取整到城市或国家 |
| 15 | 浏览器指纹(User-Agent 加屏幕加字体) | 间接 | 不需要 | 推出设备类型,其余丢弃 |
| 16 | 健康状况或治疗 | 敏感 | 不需要 | 绝不放进属性 |
| 17 | 生物特征标识(人脸、指纹) | 敏感 | 不需要 | 绝不收集 |
| 18 | 种族或民族出身 | 敏感 | 不需要 | 绝不收集 |
| 19 | 宗教信仰 | 敏感 | 不需要 | 绝不收集 |
| 20 | 工会成员身份 | 敏感 | 不需要 | 绝不收集 |
敏感组对应 GDPR 的特殊类别,第 9 条第 1 款列出了种族或民族出身、宗教信仰、工会成员身份、用于识别个人的生物特征数据以及涉及健康的数据等(第 9 条)。其中好几项(姓名、地址、电话号码、电子邮箱、社会安全号码、账号、设备标识和 IP 地址)也列在 HIPAA 去标识化所列的标识符里,所以健康类网站需要格外小心(45 CFR 164.514(b)(2))。
| 办法 | 作用 | 适用场景 |
|---|---|---|
| 不收集 | 字段不离开浏览器 | 没有明确问题的任何字段 |
| 截断 | 降低精度,比如去掉 IPv4 最后一段 | 国家层面的地理位置 |
| 泛化 | 用区间替代取值 | 年龄、邮编、位置 |
| 哈希 | 单向变换;输入可猜测时,靠猜测可还原 | 不展示原值也能匹配记录 |
| 展示时遮盖 | 对查看者隐藏字符;取值仍被存储 | 限制谁能看到 |
| 假名化 | 用代码替代标识符,对照键单独保管 | 需要按人看历史的分析 |
分析中的优先顺序:先不收集,其次泛化,再次哈希。
其中哪些会不小心混进分析数据?
团队很少会决定去收集护照号码。他们是在这样的地方不小心收到的:
- 网址和查询字符串。
/reset?email=ana@example.com、/orders/48213?name=Ana。路径或完整网址最终会进入一次页面浏览。 - 表单和搜索框。 自由文本字段会记下人们输入的任何东西,包括地址、症状和银行卡号。
- 事件属性。 开发者因为顺手,把
user_email或full_name加到了“注册”事件里。 - 登录标识。 本身就是邮箱或手机号的用户 ID,是伪装起来的直接标识符。
- 错误日志和截图。 堆栈信息和回放录制会记下屏幕上的内容。
- 来源页。 来源网址可能带着令牌或姓名。
在自己的数据里快速搜一遍 @、长数字串,以及 email、phone、name 这类常见查询键。预计会发现一些你没打算收集的东西。
怎样审计自己的属性?
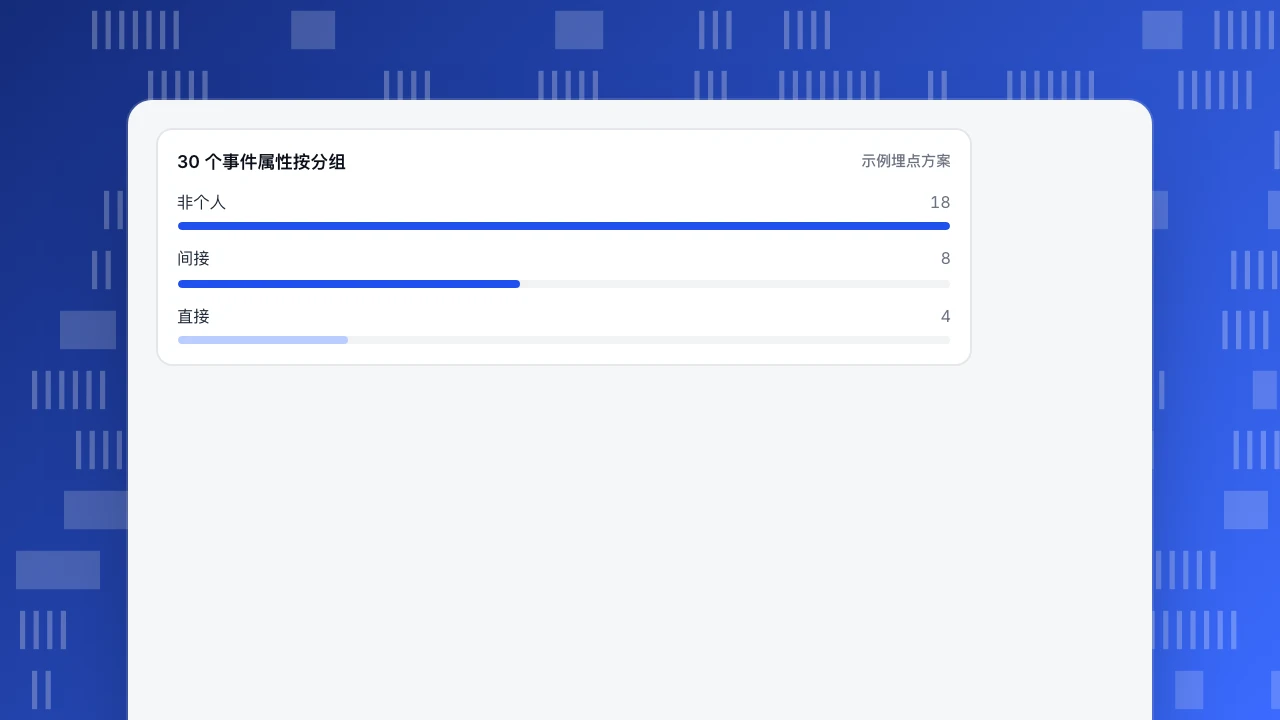
一个带示例数据的算例:团队导出 30 个事件属性的清单,给每个打上标签。
- 直接(4 个):
user_email、full_name、phone、shipping_address。 - 间接(8 个):
ip、device_id、login_id、postcode、birth_date、job_title、city_exact、user_agent_full。 - 非个人(18 个):
plan_tier、page_path、button_id、step_number、country,以及十三个类似的。
占比:4 ÷ 30 = 13.3% 直接,8 ÷ 30 = 26.7% 间接,18 ÷ 30 = 60.0% 非个人。核对:4 + 8 + 18 = 30。五分之二的属性能识别或可关联到个人,而团队在所有报表里只用到其中寥寥几个。
然后对每个直接和间接属性问:如果没有它,哪个问题会答不出来? 答案是“没有”的就删掉。有的就换成更粗的字段:birth_date → age_band,postcode → region,user_agent_full → device_type。
30 个事件属性按分组
示例埋点方案删不掉的字段有哪些处理办法?
| 办法 | 作用 | 还算个人信息吗 | 适用场景 |
|---|---|---|---|
| 不收集 | 字段不离开浏览器 | 没有数据,就没有风险 | 没有明确问题的任何字段 |
| 截断 | 降低精度(IPv4 203.0.113.42 → 203.0.113.0) | 弱化,但往往仍可关联 | 国家层面的地理位置 |
| 泛化 | 用区间替代取值(34 岁 → 30–39) | 通常风险更低 | 年龄、邮编、位置 |
| 哈希 | 对取值做单向变换 | 是,如果输入可以被猜出 | 不展示原值也能匹配记录 |
| 展示时遮盖 | 对查看者隐藏部分字符 | 是,取值仍被存储 | 限制谁能看到 |
| 假名化 | 用代码替代标识符,对照键单独保管 | 依据 GDPR 仍是 | 需要按人看历史的分析 |
哈希需要特别提醒,因为它是被误用最多的办法。同一个邮箱的哈希每次都一样:ana@example.com 的 SHA-256 以 8e43ca37… 开头,任何拿到邮箱列表的人,把列表哈希一遍就能比对。大小写不同,哈希也不同(ANA@example.com 以 b77b68e0… 开头),所以哈希前要统一成小写,否则匹配会失败。哈希后的邮箱是假名化的,不是匿名的;参见哈希术语页和假名化词条。如何在自己的系统里标记一个人,见用户 ID。
对分析来说,排序很简单:不收集优于泛化,泛化优于哈希,哈希优于存原值然后指望没人打开那张表。这个顺序背后的原则是数据最小化。
上线新事件前的简短清单
- 写下这个事件回答的问题。没有问题,就没有事件。
- 列出每个属性,并给它分组:直接、间接、敏感或非个人。
- 删掉每个直接和敏感属性。
- 把每个间接属性换成更粗的,或写下不换的理由。
- 检查将被记录的网址和查询字符串里有没有姓名、邮箱和令牌。
- 确保自由文本字段不会作为属性发送。
- 用一个测试账号试一遍,并读一读存下来的那一行。
- 设定保留期和负责人。
人们在 PII 上常犯哪些错?
- “只是个 IP 地址。” 依据欧盟规则,在线标识符可以识别个人,HIPAA 也把 IP 地址列为标识符;见上表。
- “我们做了哈希,所以是匿名的。” 可猜测取值的哈希,可以通过比对还原。
- “没有姓名字段,所以没有 PII。” 上面的审计发现,没有姓名字段,也有五分之二的属性能识别或可关联到个人。
- “我们从来看不到敏感数据。” 自由文本框和网址会替你看到。
- “PII 是美国术语,所以不适用于欧盟。” 叫法不同;欧盟的个人数据概念更宽。
- “审计一次就够。” 开发者每个迭代都会加属性。埋点方案变化时,重新审计。
怎样在 TapCub 里应用?
还是那次 30 个属性的审计。团队想在保持报表的同时,去掉 12 个能识别或可关联的属性。
- 给每个键分类。 在 全端分析 › 数据管理 › 属性字典 里,用户、事件、账户三个页签列出每个键,带一列 PII。一次扫描会把每个键归为直接标识符、间接标识符或非个人信息;直接标识符默认被遮盖。你保存的编辑算人工确认,之后的扫描不会覆盖。
- 屏蔽或限制键。 治理规则可以屏蔽一个键让它永不存储,或设白名单,其他取值存为
__other。对那四个直接属性用屏蔽规则。 - 用好采集档位。 在 配置 › 合规中心 里,开启脱敏(默认开启)时,形如邮箱或电话号码的字符串会被改写成占位符。地址用于地理位置和访客哈希,不写入事件;城市查询前默认截掉两个字节。
- 看看自动采集看到了什么。 自动采集默认不记录可见元素的文字;打开表单追踪后,提交事件只记录表单的 id、name 和 action,不记录人们输入的内容。
- 让身份识别保持可选。 如果你识别用户,邮箱和电话会按档案设置加密或丢弃,成员按角色看到的是遮盖后的值。
TapCub 不替你判断在你所适用的法律下什么算个人信息;它通过扫描给键分类,由你来确认、屏蔽和遮盖。每次发版后复查一遍属性字典。
FAQ
PII 有哪些例子?
直接标识符包括全名、邮箱、电话号码、家庭住址、身份证号、护照号码和银行卡号。间接标识符包括 IP 地址、设备 ID、出生日期和邮政编码。敏感例子包括健康数据和生物特征标识。
IP 地址是 PII 吗?
通常是。GDPR 把在线标识符列为识别个人的方式,HIPAA 把 IP 地址列为标识符。把它当作个人信息,推出国家后截断或丢弃。
电子邮箱是 PII 吗?
是。它能直接联系到具体的人。如果只是为了匹配记录,就在转成小写后做哈希,并记住哈希后的邮箱仍是假名化数据。
PII 和个人数据有什么区别?
PII 是美国常用的说法。个人数据是 GDPR 更宽的法律术语,指与已识别或可识别的人有关的任何信息。一个字段即使美国的清单不叫它 PII,也可能是个人数据。
什么是非 PII 数据?
无法被合理地关联到个人的信息,比如页面路径、按钮 ID、套餐档位或汇总计数。把它和足够多的其他字段组合,也可能变得可关联,所以组合也要审计。
资料来源
- NIST,SP 800-122 保护个人身份信息保密性指南:PII 的两部分描述,以及 PII 应防止不当访问、使用和披露的原则。核对于 2026-11-18。
- GDPR,第 4 条 定义:个人数据与标识符。核对于 2026-11-18。
- GDPR,第 9 条 特殊类别的个人数据。核对于 2026-11-18。
- Cornell 法律信息研究所,45 CFR 164.514 去标识化:HIPAA 的 18 类标识符。核对于 2026-11-18。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
