服务端埋点常被宣传成找回丢失数据的办法。更准确的理解是:它是某些事件该去的地方,也就是你的服务器本来就知道的那些已确认结果。本文区分这个词的两种含义,给出浏览器和服务端之间的混合分配,并讲清怎样保留来源和会话、又不重复计数。
读完你会知道
- 行为从浏览器发,已确认的结果从服务端发,同一个事件不要两边都发
- 服务端埋点不会改变同意义务,也不是绕开拦截的手段
- 把浏览器里的来源和会话传给服务端,并给服务端事件一个唯一标识
服务端埋点的两种含义
「服务端埋点」指的是两种不同的做法:
- 服务端标记(server-side tagging)。浏览器照样发数据,只是不直接发给各个厂商,而是先发到你自己控制的服务器,再由它转发。Google 跟踪代码管理器的服务器容器就是这样工作的(Google:服务端标记)。
- 后端事件。你的应用服务器自己发送它直接知道的事件:订单已支付、订阅已续费、通过 API 创建了账户。
两者都把工作从浏览器挪走了,但解决的问题不同。本文主要讲第二种,可靠性的提升也主要在这里。
适合做什么,不适合做什么
服务端埋点适合:
- 已确认的结果。付款、续费、退款、注册都发生在服务端。从服务端发,就不会因为「感谢页」没加载而丢失,也不会因刷新而重复;见收入埋点。
- 没有浏览器参与的事件。API 调用、后台任务、回调、发出的邮件。
- 数据可控。你能精确决定哪些字段离开你的系统,这和第一方数据策略一致。
它不是绕开同意或广告拦截的办法。同意的要求取决于你收集什么、为什么收集,与请求从哪里发出无关。论坛上对「服务端埋点能找回丢失数据」的说法多有质疑,对这种说法要谨慎。服务端事件本身也看不到浏览器里的行为:滚动、点击、页面浏览和会话属于浏览器。
在浏览器和服务端之间分配事件
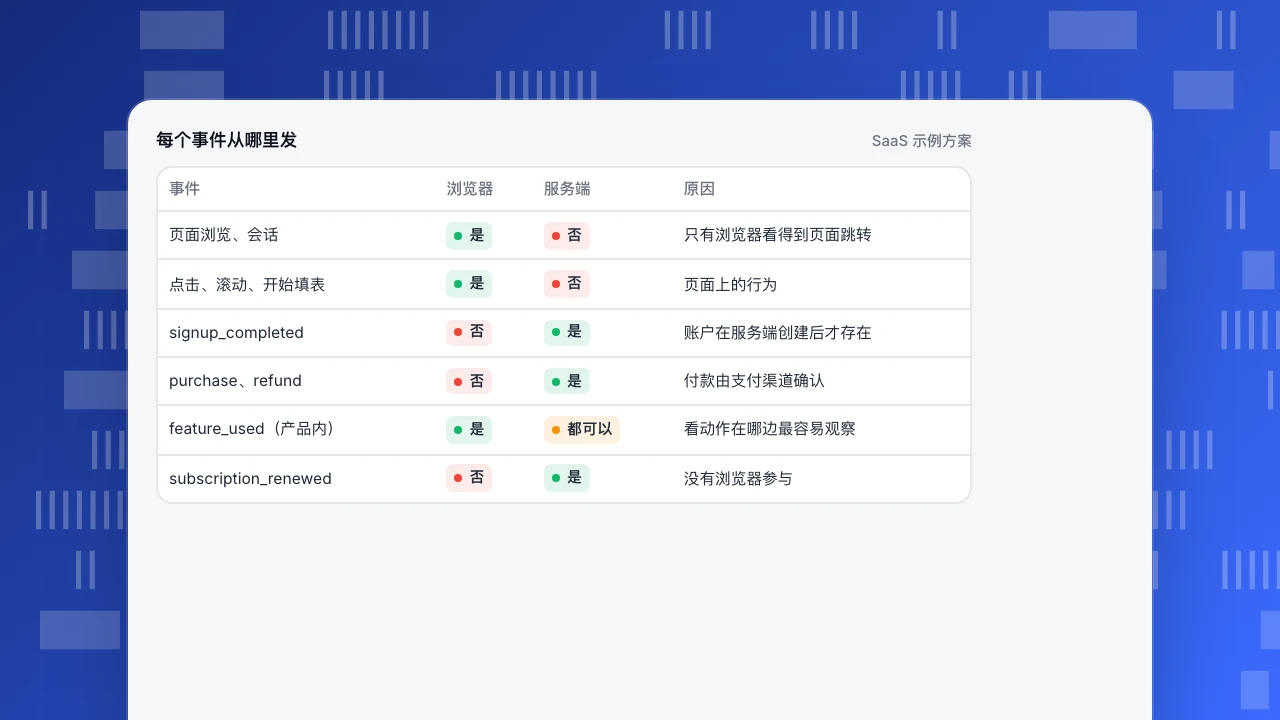
混合方案让每个事件从最清楚它的地方发出。示例是一个 SaaS 产品的典型分配。经验法则:行为从浏览器发,结果从服务端发,同一个事件永远不要两边都发。
每个事件从哪里发
SaaS 示例方案| 事件 | 浏览器 | 服务端 | 原因 |
|---|---|---|---|
| 页面浏览、会话 | 是 | 否 | 只有浏览器看得到页面跳转 |
| 点击、滚动、开始填表 | 是 | 否 | 页面上的行为 |
| signup_completed | 否 | 是 | 账户在服务端创建后才存在 |
| purchase、refund | 否 | 是 | 付款由支付渠道确认 |
| feature_used(产品内) | 是 | 都可以 | 看动作在哪边最容易观察 |
| subscription_renewed | 否 | 是 | 没有浏览器参与 |
前端埋点和服务端埋点对比
下表对比两者在决定事件归属时最常考虑的几点。整体上谈不上哪个更好,每个事件的答案不一样。
| 前端(浏览器) | 服务端 | |
|---|---|---|
| 能看到页面浏览、点击、会话 | 能 | 不能,除非从浏览器传过来 |
| 付款和注册的可靠性 | 页面提前关闭会丢,刷新会重复 | 确认时只发一次 |
| 来源和 UTM | 自动获得 | 必须从浏览器传过来 |
| 受拦截插件影响 | 会 | 后端事件不会 |
| 同意要求 | 适用 | 同样适用 |
| 工作量 | 脚本标签加事件 | 每个事件写后端代码 |
按事件选择,而不是按公司选择。
让服务端事件带上来源和会话
服务端事件本身没有来源页、没有 UTM 参数、也没有会话。如果不把它们传过去,从服务端发的注册看起来就像凭空出现,所有归因报表都会把它算成直接访问。
办法是在浏览器里拿到来源,随表单或订单发给后端,再放进服务端事件。示例展示了在 TapCub 里的做法:浏览器端调用 getAttribution(),服务端事件里原样放进 context.campaign。同时带上访客或会话标识,让服务端事件并入浏览器会话;再用你的用户 ID 调用 identify,之后两边的事件就都归到同一个人。
// 浏览器:脚本标签带 data-attribution
const source = tapcub.getAttribution();
await fetch("/api/signup", {
  method: "POST",
  body: JSON.stringify({ email, password, source })
});

// 服务端:账户创建之后
await track({
  type: "track_signup",
  event: "signed_up",
  login_id: user.id,
  insert_id: "signup_" + user.id,
  time: Date.now(),
  context: { campaign: body.source }
});
避免重复计数
- 每个事件只有一个来源。浏览器发了
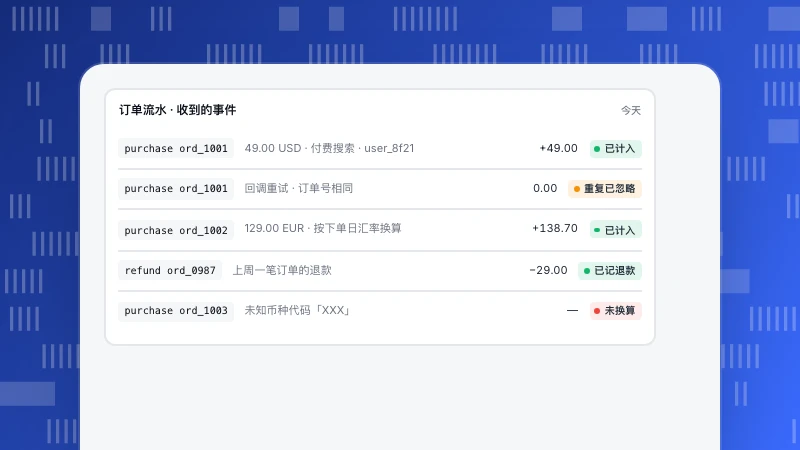
signup_completed,服务端就不要再发。在埋点方案里逐个事件定好。 - 给服务端事件一个 ID。用订单号或记录 ID 作事件 ID,请求重试时会被忽略,而不是算两次。
- 发真实时间。用动作发生的时间(毫秒),而不是任务执行的时间,排队或批量发送的事件尤其要注意。
- 页面浏览留在浏览器。服务端也发页面浏览,流量会翻倍。
TapCub 里的服务端埋点
TapCub 通过 track 接口接收服务端发来的行为事件,用绑定项目的密钥鉴权。每个事件可以带 insert_id(更新和覆盖时必填)、毫秒级 time(与服务器时钟相差超过 72 小时会被改为当前时间并给出警告)和 session_id;没有会话 ID 的事件不计入会话指标。未经哈希的邮箱或手机号会先哈希再存储(见文档服务端事件)。
归因方面,浏览器脚本开启 data-attribution 后可调用 tapcub.getAttribution();把结果原样放进 context.campaign,来源、媒介、活动、点击 ID 和落地页就会保留在这个人身上。没有传来源、但事件带了 IP 和 User-Agent 时,TapCub 会在 7 天内(严格模式下仅当天)寻找同一网络、同一浏览器的访问,并把结果标记为推断。人的页面浏览应留在浏览器脚本上,TapCub 也不会尝试绕过拦截插件或「请勿追踪」(见文档 CSP 与拦截插件)。来自服务器日志的机器人流量走另一个接口,见 AI 爬虫台账。
常见问题
什么是服务端埋点?
从服务器而不是(或者同时也从)访客浏览器发送统计事件:要么把浏览器数据经过你自己的服务器转发,要么由后端直接发送它知道的事件。
服务端埋点比前端埋点好吗?
整体上没有谁更好。服务端对已确认的结果更可靠;前端是看到页面浏览、点击、会话这些浏览器行为的必经之路。
服务端埋点能绕过广告拦截和同意吗?
不应该这样用。同意规则针对的是你收集什么,不管数据从哪里发出。
服务端事件怎么保留归因?
在浏览器里拿到来源,随表单或订单发给后端,再连同访客或会话 ID 一起放进服务端事件。
怎样避免一个事件被算两次?
每个事件只从一边发送,并给服务端事件一个唯一标识(比如订单号),重试就会被忽略。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。