MVP 测试是用能给出可信答案的最小构建,让真实的人来验证产品的一个有风险的假设。写一份计划:假设、行为指标、上线前定好的通过阈值,以及每种结果对应的决定;小样本要当作区间来读:下面的示例里,同样 9.0% 的注册率,在 300 位访客时通过,在 100 位时不通过。下文是测试类型、计划表、区间和决策规则。
读完你会知道
- 上线之前用一张表写好假设、指标、阈值和决定;事后定的阈值,就是定在数字已经在的地方
- 小样本的比率是一个范围:300 位访客的 9.0% 是 6.3% 到 12.8%,100 位访客的 9.0% 则是 4.8% 到 16.2%
- 沿着投入程度的阶梯从邮箱、通话走到付款,并测试成本最低、又能证伪最大风险假设的那一步
什么是 MVP 测试?
MVP 测试是一个实验:用能给出可信答案的最小东西,让真实的人来验证关于产品的一个有风险的假设。Eric Ries 把最小可行产品定义为:让团队用最少的精力,收集到最多经过验证的客户认知的那个版本(Agile Alliance 术语表)。重点在学习,而不是东西做得小:一个落地页、一项手工服务或一个原型,只要能回答问题,都可以是 MVP。
所以 MVP 测试不是质量保证意义上的软件测试,也不是朋友投票。它有四个部分:
- 一个假设:一句可能被证伪的话。
- 一个指标:从行为而不是意见来衡量它。
- 一个阈值:在测试开始前就写好。
- 一个决定:每种结果都对应一个动作。
本文余下的部分,讲怎么把这四样写下来并诚实地核对。关于产品概念本身,见 最小可行产品;关于人们是否想要你做的东西这个更大的问题,见 产品验证。
怎样选择先测哪个假设?
每个产品都有一串假设:有这个问题、人们感受到的程度足以让他们行动、他们能找到你的方案、他们愿意付费、他们会再回来。先测风险最大、成本又最低就能测的那一环,而不是你觉得最有意思的那一个。
快速排序的办法:对每个假设,打 1 到 5 分,衡量「如果它是错的,损失多大」和「现有证据有多少欠缺」,再相乘。从乘积最高的开始测。对一个提醒自由职业者催收未付发票的工具,这串假设可能是:
| 假设 | 若为假的损失 | 证据欠缺程度 | 风险(乘积) |
|---|---|---|---|
| 自由职业者要花时间追讨拖欠的款项 | 5 | 3 | 15 |
| 他们想要一个工具,而不是一封模板邮件 | 4 | 4 | 16 |
| 他们愿意按月付费 | 5 | 5 | 25 |
| 他们会通过搜索或社区找到我们 | 3 | 4 | 12 |
付费意愿排名最高,但在东西还没做出来之前测它成本很高。实用的顺序是先做便宜的测试(兴趣,然后是问题,然后是付费意愿),每一步都以上一步为前提,就像下面的计划那样。
哪种 MVP 测试适合你的问题?
| 测试类型 | 它是什么 | 测试什么 | 要记录的信号 | 投入 |
|---|---|---|---|---|
| 落地页冒烟测试 | 一个描述产品并带注册入口的页面 | 这个承诺是否吸引任何人 | 按流量来源的注册率 | 数小时 |
| 礼宾式服务 | 你亲手向少数客户提供这项服务 | 这个结果是否有价值 | 重复使用、付费意愿 | 数天 |
| 绿野仙踪式 | 产品看起来是自动的,背后由人来做 | 在自动化之前,体验是否成立 | 任务完成、再次访问 | 数天到数周 |
| 预购或付费试点 | 客户在东西做出来之前就付款 | 付费意愿,一个很强的信号 | 付款、退款请求 | 数天 |
| 单一功能产品 | 一个真实的功能,别无其他 | 核心价值能否独立成立 | 第 1 周和第 4 周的回访 | 数周 |
选成本最低、又能证伪你最大风险假设的测试。冒烟测试没法告诉你人们会不会付钱;预购可以。
| 测试类型 | 测试什么 | 要记录的信号 |
|---|---|---|
| 落地页冒烟测试 | 这个承诺是否吸引任何人 | 按来源的注册率 |
| 礼宾式服务 | 这个结果是否有价值 | 重复使用、付费意愿 |
| 绿野仙踪式 | 自动化之前体验是否成立 | 任务完成、再次访问 |
| 预购或付费试点 | 付费意愿 | 付款、退款请求 |
| 单一功能产品 | 核心价值能否独立成立 | 第 1 周和第 4 周的回访 |
选成本最低、又能证伪你最大风险假设的测试。
MVP 测试计划里写什么?
上线之前,把计划写成一张表。每个假设一行,带上决定它的阈值。发票提醒想法的示例数据:
| 步骤 | 假设 | 指标 | 通过阈值 | 示例结果 | 通过后的决定 |
|---|---|---|---|---|---|
| 1. 落地页 | 自由职业者想要它,到了愿意留邮箱的程度 | 注册数 ÷ 独立访客 | 比率 ≥ 8%,且 95% 区间的下端 ≥ 5% | 27 ÷ 300 = 9.0%(6.3% 到 12.8%) | 邀请注册者通话 |
| 2. 访谈 | 注册者在意到愿意交谈 | 约到的通话 ÷ 发出的邀请 | ≥ 20% | 8 ÷ 27 = 29.6% | 完成这 8 次通话 |
| 3. 问题 | 这个问题是眼下的,而不是假想的 | 过去 30 天内催过逾期发票的受访者 | ≥ 8 人中的 6 人 | 8 人中的 6 人 | 提出付费试点 |
| 4. 付费意愿 | 东西还没做出来他们就愿意付钱 | 预付的受访者 | ≥ 8 人中的 2 人 | 8 人中的 4 人 | 开展礼宾式试点 |
| 5. 早期留存 | 两周之后这个结果依然被需要 | 第 2 周仍活跃的试点用户 | ≥ 12 人的 50% | 12 人中的 7 人 = 58.3% | 做出精简版产品 |
这张表的规则:
- 先定阈值。 如果在看到数字之后再写,阈值就会被定在数字已经在的地方。
- 每一步也有止损值。 如果第 1 步的区间上端低于 5%,决定就是「换信息或换受众,或者停下」。
- 小数量只能看方向。 8 次访谈和 12 个试点用户证明不了一个比率;它们只是检验信号到底有没有,下一节会说明。
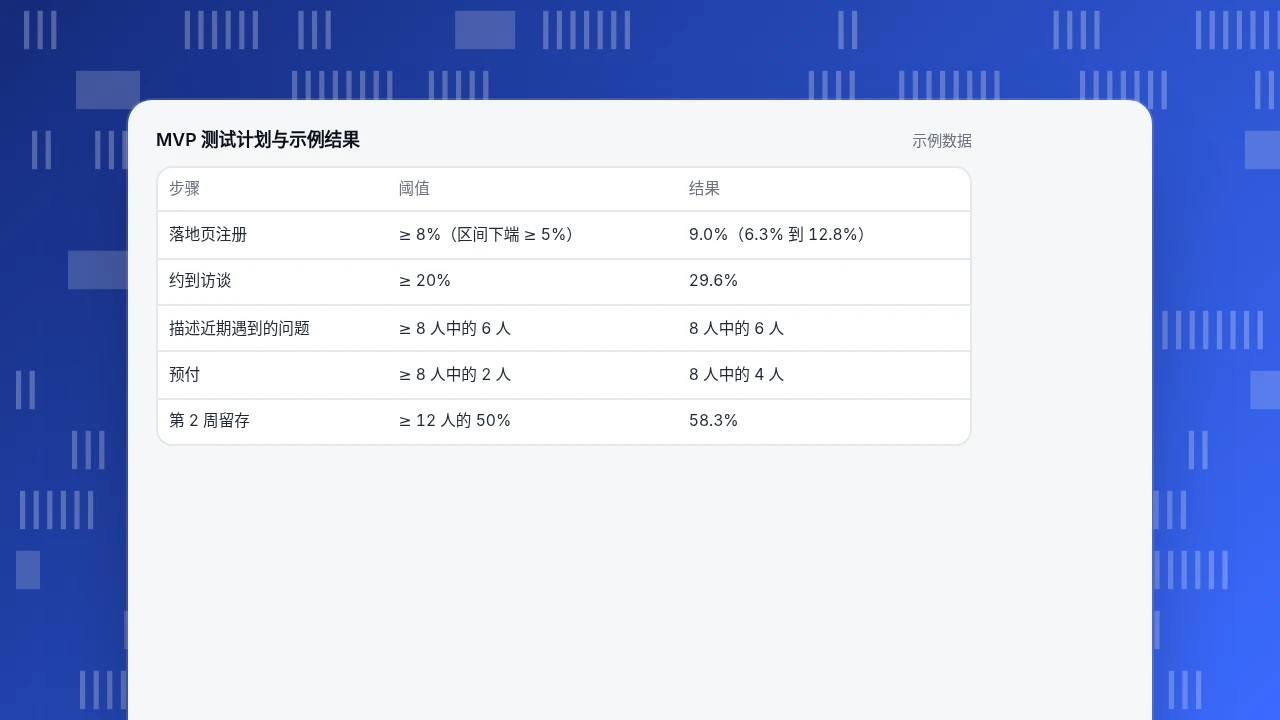
MVP 测试计划与示例结果
示例数据| 步骤 | 阈值 | 结果 |
|---|---|---|
| 落地页注册 | ≥ 8%(区间下端 ≥ 5%) | 9.0%(6.3% 到 12.8%) |
| 约到访谈 | ≥ 20% | 29.6% |
| 描述近期遇到的问题 | ≥ 8 人中的 6 人 | 8 人中的 6 人 |
| 预付 | ≥ 8 人中的 2 人 | 8 人中的 4 人 |
| 第 2 周留存 | ≥ 12 人的 50% | 58.3% |
要有多少用户才能相信结果?
小样本得出的比率是一个范围,不是一个数。威尔逊区间是计算比例区间的标准办法,NIST 的手册给出了公式(NIST/SEMATECH e-Handbook)。取 95% 置信度的 z = 1.96,上面示例结果的区间是:
| 结果 | 观测值 | 95% 区间 |
|---|---|---|
| 300 位访客里 27 人注册 | 9.0% | 6.3% 到 12.8% |
| 100 位访客里 9 人注册 | 9.0% | 4.8% 到 16.2% |
| 600 位访客里 54 人注册 | 9.0% | 7.0% 到 11.6% |
| 27 位注册者里 8 次通话 | 29.6% | 15.9% 到 48.5% |
| 8 人中 4 人预付 | 50.0% | 21.5% 到 78.5% |
| 12 人中 7 人仍活跃 | 58.3% | 32.0% 到 80.7% |
读两遍。同样的 9.0%,在 300 位访客时是通过(下端 6.3%,高于 5% 的下限),在 100 位时却不是(下端 4.8%,低于下限),所以只有 100 位访客时,正确的决定是「继续收集」。8 人中 4 人预付令人鼓舞,但区间从 21.5% 一直到 78.5%,所以它触发的是试点,而不是上线。
一个粗略的样本量规则,针对 9% 左右的比率:n = z² × p × (1 − p) ÷ 误差²。误差 ±5 个百分点时,1.96² × 0.09 × 0.91 ÷ 0.05² ≈ 126 位访客;±2 个百分点时约为 787 位。据此规划流量,或者接受更宽的区间,再判断决定经得起它吗。
怎么测试人们是不是真的会想念它?
行为告诉你人们有没有行动;对已有用户的调查告诉你,他们会不会想念这个产品。Sean Ellis 的问题(Superhuman 用过)是「如果你再也不能使用这个产品,你会有什么感觉?」,选项是非常失望、有点失望和不失望。Ellis 在近 100 家创业公司里得出的基准是 40% 选「非常失望」:低于它的公司通常增长吃力,增长强劲的公司通常超过它。Superhuman 调查的是过去两周内至少用过两次的用户;一开始是 22%,把对象分到合适的用户后达到 33%,经过三个季度的产品改进后到了 58%;作者也指出,大约 40 份回复就可以给出有方向性的参考(First Round Review)。
对 MVP 来说,把它用在试点用户身上,而不是从没用过任何东西的注册者。12 个试点用户的回复远少于 40 份,所以只能把它当作访谈的线索,不能当成分数。
怎么决定:继续、调整还是停止?
| 结果 | 数据长什么样 | 决定 |
|---|---|---|
| 明确通过 | 每一步都高于阈值,区间也高于下限 | 做出精简版产品;为下一个测试设定新阈值 |
| 好坏参半 | 兴趣高,付费意愿低 | 先测定价或更窄的受众,再动手做 |
| 不明确 | 比率靠近阈值,区间很宽 | 继续收集数据;不要改阈值 |
| 明确失败 | 区间上端低于止损值 | 调整信息、受众或想法,重新跑第 1 步;两次调整都失败就停止 |
哪些错误会毁掉 MVP 测试?
- 拿朋友和同事来测。 他们的注册说明不了陌生人的态度。只算来自你目标受众的访客。
- 移动阈值。 事前写「8%」,数字出来后又说「5% 也行」,就等于决定无视这个测试。
- 把点击当作需求。 点一下按钮不是预购。沿着投入程度的阶梯往下走:邮箱、通话、付款。
- 混合来源。 付费流量和社区帖子合在一起的注册率,掩盖了哪个受众有效。按来源分别报告。
- 把小样本当结果。 像表里那样展示区间。
怎样用 TapCub 跑 MVP 测试
TapCub 不做实验、不分流、不发问卷;Ellis 的那个问题需要另外的问卷工具。它衡量的是行为:访客从哪里来、有没有转化、有没有回来。以发票提醒测试为例:
- 给每个渠道打标记。 你发出的每个链接都带
utm_source、utm_medium和utm_campaign,然后看 网站统计 › 来源:「UTM」页签按来源、媒介和活动拆分访客和会话,渠道表再加上转化,所以按渠道的注册率在一张表里。 - 把注册定义为目标。 在 网站统计 › 目标 里,为注册事件或感谢页建一个目标。它的转化率除以的是所选日期内的独立访客,和计划里「注册数 ÷ 独立访客」这个指标一致。
- 注册之后识别个人。 试点用户登录时调用
tapcub.login,这个人就会出现在 全端分析 › 用户 › 用户 里,带有按天排列的行为时间线,对礼宾式和试点这几步很有用。 - 查看各步骤和回访。 在 全端分析 › 行为分析 › 行为分析 里,建一个从落地页到注册再到首次使用的漏斗,并为试点人群建一份留存报表,与第 2 周的阈值对照。
- 区间要自己算。 TapCub 给出数量和比率;小样本的区间像上表那样自己计算,并把决定写进你的计划。
FAQ
什么是 MVP 测试?
MVP 测试是一个实验:用能给出可信答案的最小构建,让真实的人验证关于产品的一个有风险的假设。它需要一个假设、一个行为指标、一个事先写好的阈值,以及每种结果对应的一个决定。
怎么用真实用户测试 MVP?
从成本最低、又能证伪你最大风险假设的测试开始:用落地页测兴趣,用访谈测问题,用预购测付费意愿,用礼宾式试点测留存。事先写好阈值,每一步都以上一步为前提。
测试 MVP 需要多少用户?
取决于你能接受的误差。对 9% 左右的比率,约 126 位访客给出大约五个百分点的误差,约 787 位给出两个百分点。样本更少时就报告区间:100 位访客里 9 人注册是 9%,但可能在 4.8% 到 16.2% 之间。
MVP 测试的阈值定多少合适?
没有通用数字。要从经济账出发:为达到你的获客成本需要的注册率,或者让生意成立所需的预购占比。示例里,8% 且区间下端 5% 是门槛。请在上线之前定下你自己的。
MVP 和原型有什么区别?
原型演示某个东西可能怎么运作;MVP 是和真实客户一起使用,收集他们行为的证据。原型可以是 MVP 测试的一部分,比如绿野仙踪式的做法,但测试由假设和阈值定义,而不是由制品定义。
资料来源
- Agile Alliance。MVP (Minimum Viable Product):归于 Eric Ries 的定义。2026-11-20 核对。
- First Round Review。How Superhuman Built an Engine to Find Product/Market Fit:40% 基准,以及 Superhuman 的 22%、33% 和 58%。2026-11-20 核对。
- NIST/SEMATECH e-Handbook of Statistical Methods。Confidence intervals for proportions:威尔逊区间公式。2026-11-20 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
