CRO 测试就是运行一个对照实验,通常是 A/B 测试,看改动让转化率发生的变化是否超过偶然。从流量和证据都最充分的地方开始,先定好样本量(基线 3% 检测 +20% 每个版本 13,914 位访客),而且不要提前停。
读完你会知道
- 先测访客最多、有明确流失证据的步骤;凭感觉想的点子、又在低流量页面上的放最后
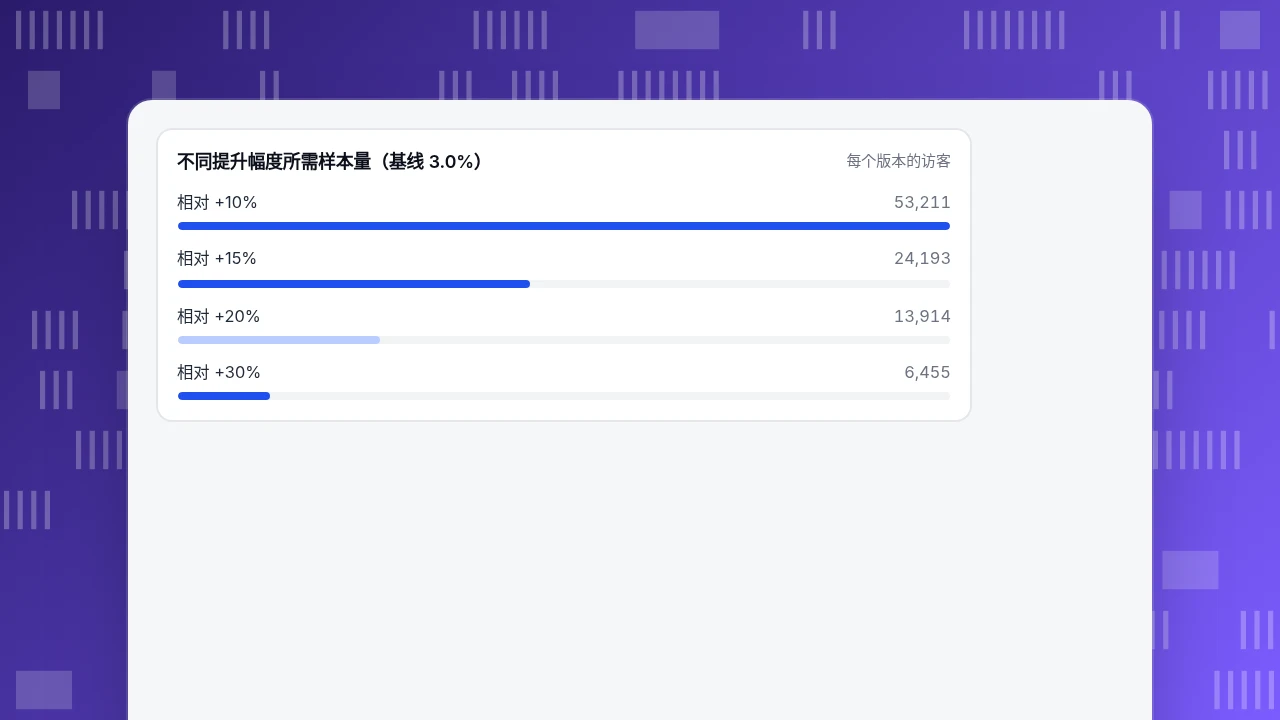
- 基线 3% 时,+10% 每个版本需要 53,211 位访客,+20% 需要 13,914,+30% 需要 6,455
- 一好看就停会把误报率推到 Evan Miller 最坏情形下的 26.1%;先定好样本量
CRO 测试是什么,不是什么
CRO 测试是一种对照实验:把同一个页面或步骤的两个版本,在同一时间展示给相似的访客,比较每组里有多少人完成目标。 起作用的是「对照」这两个字。下面两种做法都不是 CRO 测试:
- 前后对比。 你在 1 号改了页面,然后和上个月比。季节性、一次活动、一次调价或一波机器人流量都能解释差异,而你分不开它们和你那次改动。
- 一直盯到好看为止。 开了真正的分流,却在看板一变绿就停。下面会专门讲,因为这是有效的测试变成无效结论最常见的方式。
CRO 测试只回答一个很窄的问题:这个改动让这个转化率变化的幅度,能不能和偶然区分开?更大的流程(调研、审计、排优先级)见 转化率优化指南 和 CRO 审计。分流测试的具体做法见 A/B 测试指南。
先测什么
在很多人到达、又有很多人离开的步骤上测。一个每月 20,000 人看的页面上,哪怕只涨一点,也比一个只有 200 人看的页面上大涨更值钱,而且只有在这种页面上,才能在几周而不是几个月里得出结论。
用三个能从自己数据里拿到的数字给每个想法打分:该步骤每月访客数、你认为这个想法能挽回多少流失、成本。示例数据:
| 想法 | 每月访客 | 步骤转化率 | 依据 | 成本 | 优先级 |
|---|---|---|---|---|---|
| 结账前显示运费 | 12,000 | 41% | 运费那一步流失陡增 | 低 | 1 |
| 缩短注册表单 | 9,000 | 18% | 回放里表单停留时间很长 | 中 | 2 |
| 新的首页大标题 | 30,000 | 3% | 凭感觉 | 低 | 4 |
| 定价页版式 | 6,000 | 9% | 热力图显示套餐表被跳过 | 中 | 3 |
大标题的流量最多、依据最弱,所以排最后。排序先看依据,再看流量,最后看成本。说不出是哪项数据指向某个想法,它就放到最底下。
| 想检测的提升 | 变体转化率 | 每个版本的访客 | 合计访客 |
|---|---|---|---|
| 相对 +10% | 3.30% | 53,211 | 106,422 |
| 相对 +15% | 3.45% | 24,193 | 48,386 |
| 相对 +20% | 3.60% | 13,914 | 27,828 |
| 相对 +30% | 3.90% | 6,455 | 12,910 |
示例数据:基线 3.0%,5% 显著性(双侧),80% 功效,两比例正态近似。想检测的提升减半,样本量大约变成四倍。
基线 3% 的样本量:一个算例
假设页面转化率是 3.0%。每个版本需要多少访客,测试才能可靠地把它和一个更好的版本区分开?这取决于你想检测多大的提升。按常用的 5% 显著性(双侧)和 80% 功效,用标准的两比例公式,每个版本的样本量如下。(基线是示例数据;所有数字都用 Python 复算。)
| 想检测的提升 | 变体转化率 | 每个版本的访客 | 合计访客 |
|---|---|---|---|
| 相对 +10% | 3.30% | 53,211 | 106,422 |
| 相对 +15% | 3.45% | 24,193 | 48,386 |
| 相对 +20% | 3.60% | 13,914 | 27,828 |
| 相对 +30% | 3.90% | 6,455 | 12,910 |
把它当价目表来看。想检测的提升减半,样本量大约变成四倍,这就是小改动需要海量流量的原因。要在 3% 的页面上检测 10% 的相对提升,合计需要超过 100,000 位访客。
不用计算器也能粗略校验这张表。Evan Miller 给了一个经验公式:每个版本 n = 16σ² ÷ δ²,其中 δ 是你在意的最小差值(百分点),转化率的 σ² = p(1 − p)。对 +20%:δ = 0.006,σ² = 0.03 × 0.97 = 0.0291,所以 n = 16 × 0.0291 ÷ 0.000036 = 12,933。精确计算是 13,914,多约 7%,所以这个捷径可以当第一次的估算。
有两个选择会改变数字。把功效从 80% 提到 90%,+20% 的测试每个版本从 13,914 增加到 18,626 位访客。把显著性水平从 5% 放宽到 10%,则降到 10,960,代价是误报多一倍。
不同提升幅度所需样本量(基线 3.0%)
每个版本的访客要跑多久
用总量除以真正看到测试的每日访客数,再向上取整到整周,这样每个星期几出现的次数相同。对 +20% 的测试(合计 27,828 位访客):
| 被测页面每日访客 | 需要天数 | 取整到整周 |
|---|---|---|
| 500 | 56 | 56 天(8 周) |
| 1,500 | 19 | 21 天(3 周) |
| 3,000 | 10 | 14 天(2 周) |
在上线前就把停止点写下来:「每个版本到 13,914 位访客再停,不提前。」如果答案超过大约六周,这个提升幅度下的测试就不值得做,下一节给出替代办法。
为什么不能一好看就停
Evan Miller 关于重复显著性检验的文章展示了「偷看」的后果。基线 50%、改动其实没有任何作用时,只要每次观察后(最多 150 次)一达到 5% 显著性就停,误报率是 26.1%,超过名义 5% 的五倍。他给出的表是:想让真实误报率保持在 5%,你需要看到的报告显著性为:
| 看了几次 | 必须看到的显著性 |
|---|---|
| 1 | 2.9% |
| 2 | 2.2% |
| 3 | 1.8% |
| 5 | 1.4% |
| 10 | 1.0% |
示例能说明这是什么感觉。在下面做完的例子里,最终结果很清楚,但当 40% 的访客进来时(每个版本 5,600 位,转化 168 对 205),p 值是 0.051,正好在边缘。每天看一次的团队,可能在一个走运的日子停下来,也可能在一个倒霉的日子放弃真正的赢家。办法很简单:事先定好样本量,只在结束时看,或者用专为提前停止设计的序贯方法。
流量太少时怎么办
每个版本 3,000 位访客时,3% 基线能可靠检测到的最小提升约为 1.2 个百分点(80% 功效、5% 显著性下的最小可检测效应约为 0.0123),也就是相对提升 41%。很少有页面改动能带来这么大的效果。你有四个老实的选择:
- 测更大的改动。 换掉整个报价,而不是一个按钮的颜色。大的效果在小样本里也能检测到。
- 在漏斗更靠上的位置测。 点击进入下一步的基础比率比购买高,所需访客更少。要先确认前面的指标真的能预测后面的指标。
- 合并相似页面。 把同一个改动放到共用模板的 10 个商品页上一起测。
- 不测,用证据。 明显的故障或坏掉的表单,不用测试就修。测试是用来做选择的,不是用来修理的。
怎么读结果
把例子做完。测试一直跑到每个版本达到计划的 14,000 位访客。对照组:420 次转化(3.00%)。变体:497 次转化(3.55%)。
- 差值(百分点):3.55% − 3.00% = +0.55 个百分点;相对提升:+18.3%
- 合并转化率 917 ÷ 28,000 = 3.275%;z = 2.59;双侧 p = 0.0097
- 差值的 95% 区间:+0.13 至 +0.97 个百分点
三个习惯能让解读更诚实。写出区间,而不只是赢家:真实的提升可能只有 +0.13 个百分点。检查流量分配是否和计划一致(50/50 的分流实际到了 52/48,说明分配环节出了问题)。还有,别把结果切成十个细分,一直切到某个显著;切十块时,在 5% 的阈值下约有 40% 的概率总有一块碰巧显著(1 − 0.95¹⁰ ≈ 40%)。
在 TapCub 里围绕测试工具做衡量
拿表里「显示运费」的想法来说:每月 12,000 位访客,41% 到达下一步。TapCub 不做 A/B 测试,也不分流,所以分配要用单独的测试工具。TapCub 负责的是在测试前、中、后衡量这些页面。
- 找出要测的步骤。 在 全端分析 › 行为分析 › 行为分析 里建结账漏斗,看流失最大的那一步。这就是上面表里的「依据」一列。
- 看原因。 查看该页面的 全端分析 › 行为分析 › 热力图(点击、滚动),如果已经打开了 全端分析 › 行为分析 › 会话回放(默认关闭)也一起看。
- 确定基线。 在 网站统计 › 目标 里定义目标,读它最近 4 到 8 周的转化率。这就是你代入样本量公式的 3.0%。
- 记录变体。 如果你的测试工具能暴露当前变体,就用自定义事件把它发过来,例如
tapcub.track('checkout_view', { variant: 'B' }),这样就能在漏斗步骤上按这个属性过滤,在同一个目标上比较两个版本。 - 标出上线时间。 在 配置 › 日期标注 里加一条备注,之后的图表上就能看到测试何时开始、何时结束。
- 把机器人挡在分母之外。 TapCub 把真人和机器人流量分开统计,爬虫访问不会稀释你用来比较的转化率。
常见问题
什么是 CRO 测试?
它是运行一个对照实验,通常是 A/B 测试,看对页面或步骤的改动让转化率发生的变化是否超过偶然。前后对比不算,因为它无法把你的改动和同时发生的其他变化分开。
CRO 测试要跑多久?
跑到每个版本达到上线前算好的样本量,并向上取整到整周。基线 3%、提升 +20% 时,每个版本需要 13,914 位访客,每天 2,000 位访客的话是 14 天。千万不要因为结果看起来显著就停。
转化测试需要多大的样本量?
取决于基线、想检测的提升、显著性和功效。基线 3%、5% 显著性、80% 功效时:+10% 每个版本 53,211,+15% 为 24,193,+20% 为 13,914,+30% 为 6,455。
应该先测什么?
访客最多、流失证据最清楚的那一步,比如漏斗里陡降的步骤、显示某个元素被跳过的热力图,或者尝试失败的回放。凭感觉想出来、又在低流量页面上的想法放最后。
TapCub 能运行我的 A/B 测试吗?
不能。TapCub 不做 A/B 实验,也不分流。它衡量测试周围的漏斗、目标、热力图和来源,并且可以记录你作为自定义事件属性发来的变体。
资料来源
- Evan Miller:How Not To Run An A/B Test,2026-11-20 核对(26.1% 误报率、偷看对照表、n = 16σ²/δ²)
- Evan Miller:Sample Size Calculator,2026-11-20 核对(输入项:基线、最小可检测效应、功效、显著性)
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
