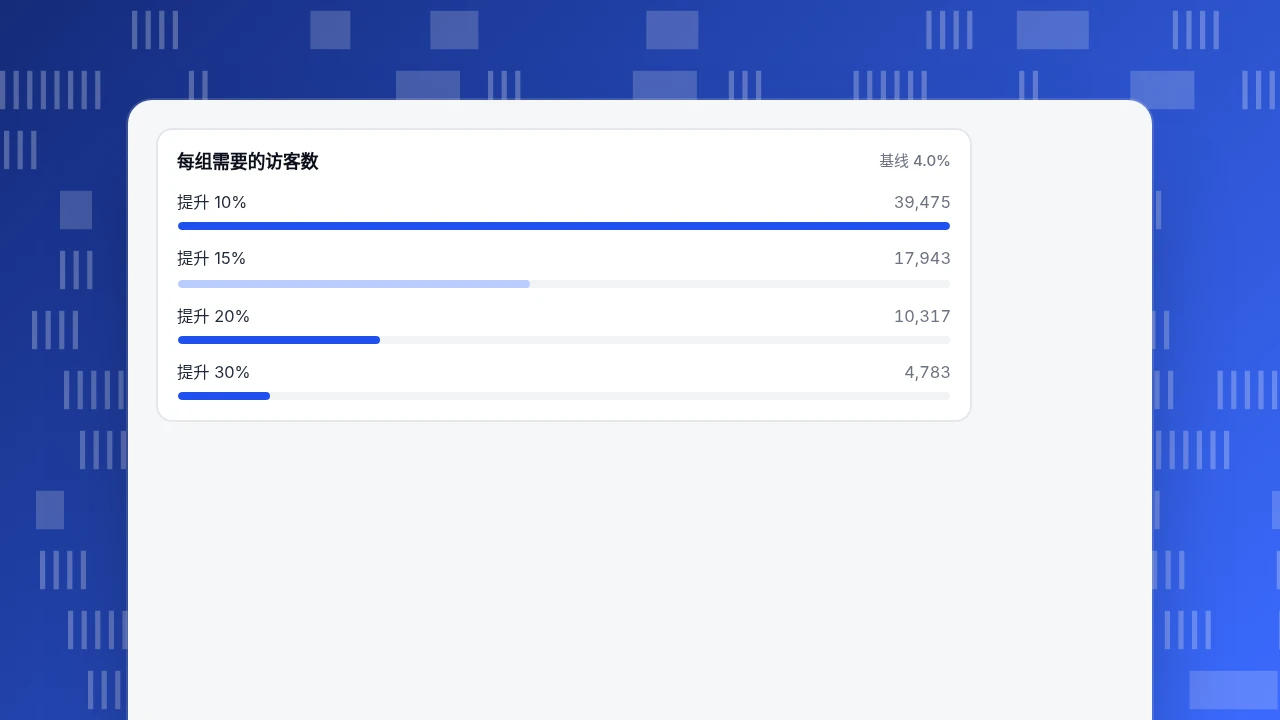
A/B 测试是把访客随机分到 A、B 两个版本,同时运行,只比较事先选定的一个指标。要做好,上线前先定样本量,按整周运行,检查分流比例,读置信区间而不是只看 p 值,并且只看一次结果。下面的实例要把转化率从 4.0% 提升到 4.6%,每组需要 17,943 个访客,最后得到 +0.08 到 +0.91 个百分点的区间。
读完你会知道
- 上线前按基线、值得的最小提升、5% 显著性和 80% 功效定样本量:4.0% 到 4.6% 每组要 17,943 个访客
- 运行时间向上取整到整周,检查分流比例,再读置信区间,而不是只看 p 值
- 在我们的模拟里,看五次并在第一次 p < 0.05 时停下,让 5% 的假赢率变成了 14.55%
A/B 测试是什么,什么时候该用?
A/B 测试(也写作 A 和 B 测试)是随机对照实验:访客被随机分到 A 版(对照)或 B 版(改动),两个版本同时上线,只比较事先选定的一个指标。随机分组是公平对比的前提。设备、来源、心情这些别的差异都会被随机打散,所以指标出现差距,就可以归因于你的改动。
它和“前后对比”不同:前后对比是这周用旧页面、下周用新页面,得到的数字里混着天气、一封邮件、一个节日和竞争对手的一次调价。跑过成千上万个线上实验的研究者总结过一条叫 Twyman 定律的规则:“任何看起来有趣或与众不同的数字,通常都是错的”(Kohavi 等,2014)。同时并行的对照实验,是成本最低的防线。
满足下面三条,才适合做 A/B 测试:
- 有一个要做的决定。“要不要上线更短的注册表单?”是决定,“先看看会怎样”不是。
- 样本量能在合理时间内凑够。如果下面的计算告诉你要 40 周,就别做了:改个更大的改动,换一个流量更高的页面,或者凭判断先决定、上线后再衡量。
- 改动对每个访客相互独立。邻居之间价格不同、一位同事给另一位展示的功能,都会污染分组。
三条里有一条不满足,直接看前后对比的注意事项,不要硬做一个站不住脚的测试。
怎么写假设、怎么选指标?
测试开始前先写下四样东西,因为看到数据之后再改其中任何一项,都是“假赢”的来源:
| 项目 | 本文例子 | 为什么重要 |
|---|---|---|
| 假设 | 把 7 个字段的注册表单换成 3 个字段,完成注册的人会更多 | 写明方向和理由 |
| 主指标 | 注册人数 ÷ 看到表单的访客数 | 只用一个数字做决定 |
| 护栏指标 | 新账户 24 小时内确认邮箱的比例 | 防止赢来的是质量更差的线索 |
| 分组单位 | 访客,只分配一次,回访时留在同一组 | 避免同一个人看到两个版本 |
主指标要快到几周内就能读出来。如果主指标是“12 个月留存”,那是队列研究,不是 A/B 测试。可以用一个有证据能预测长期指标的替代指标,把长期指标留作护栏。
下面用同一组数字走完整个测试:表单页注册率基线 4.0%,希望提升到 4.6%(相对提升 15%),每天 1,500 个符合条件的访客,50 / 50 分流。所有数字均为示例数据,每一步计算都用 Python 复算过。
每组需要多少访客?
样本量取决于四个你来定的输入和一个你控制不了的因素。你来定的是基线转化率(4.0%)、最小可检测效应(值得找出来的最小提升,这里是 4.0% 到 4.6%)、显著性水平(5%,双侧)和统计功效(80%,即提升真实存在时能检测到的概率)。控制不了的是指标本身的波动,对转化率来说由基线决定。
两个转化率 p1、p2 的每组访客数,用标准的正态近似公式:
n = (z(1-α/2) × √(2 × p̄ × (1 - p̄)) + z(功效) × √(p1 × (1 - p1) + p2 × (1 - p2)))² ÷ (p2 - p1)²
其中 p̄ 是 p1 和 p2 的平均值,z(0.975) = 1.960,z(0.80) = 0.842。4.0% 对 4.6%:p̄ = 4.3%,算出每组 17,943 个访客,合计约 36,000 个。
要检测的提升越小,测试就越大。所需样本量大致和提升幅度的平方成反比:提升减半,访客数约要变成四倍。
| 要检测的相对提升 | 变体转化率 | 每组访客数 | 访客合计 | 每天 1,500 个需要的天数 | 向上取整到整周 |
|---|---|---|---|---|---|
| 10% | 4.4% | 39,475 | 78,950 | 52.6 | 8 周 |
| 15% | 4.6% | 17,943 | 35,886 | 23.9 | 4 周 |
| 20% | 4.8% | 10,317 | 20,634 | 13.8 | 2 周 |
| 30% | 5.2% | 4,783 | 9,566 | 6.4 | 1 周 |
把它当作工作估计,而不是保证。各家公开的计算器会差 10–20%,因为假设不同。一家厂商的文档在基线 5% 时,对 15%、10%、5% 的相对提升给出每个版本约 12,000、26,000 和 100,000 个访客(Adobe Target);上面的双侧公式在同样输入下算出 14,193、31,233 和 122,123。关键是规律:提升越小,测试大得越快。
对不是简单转化率的指标有两点提醒。人均收入之类的均值通常比转化率需要更多访客(同一份文档说大约要长 20–30%),严重偏态的指标还要更多;微软、亚马逊、Booking.com 和领英的作者给出一条经验:当指标偏度 s 的绝对值大于 1 时,每个变体至少需要 355 × s² 个观测(Kohavi 等,2014)。
每组需要的访客数
基线 4.0%测试要跑多久?
用总样本量除以每天符合条件的流量,再向上取整。15% 的设计:35,886 ÷ 1,500 = 23.9 天,向上取整为 28 天(整整四周)。
取整到整周不是形式。行为随星期几变化,如果测试周四开始、周二结束,有些日子的权重就偏高。一家厂商要求用户为此把所需时间向上取整到整周(Adobe Target);另一家建议至少跑一个业务周期,并把它定义为七天(Optimizely);2014 年经验法则论文的作者说,文中每个实验都“至少跑了一周”,且各变体的分配比例保持稳定(Kohavi 等,2014)。
用下面的规则定结束日期:
- 先用样本量算天数,再向上取整到整周。不要按“看起来显著了”来定结束日期。
- 至少覆盖一个完整的业务周期。如果买家要考虑三周,跑一周的测试只量到了决定最快的那批人。
- 避开已知干扰。测试期间的促销、一封群发邮件或调价,理论上对两组影响相同,但会改变进入测试的人群。把它们记进日志,影响大就考虑重新开始。
- 在计划日期停,不提前也不延后。一直延长到结果“稳了”,本质上就是偷看(见下文)。
| 要检测的相对提升 | 每组访客数 | 每天 1,500 个需要的天数 | 运行时间 |
|---|---|---|---|
| 10%(4.0% 到 4.4%) | 39,475 | 52.6 | 8 周 |
| 15%(4.0% 到 4.6%) | 17,943 | 23.9 | 4 周 |
| 20%(4.0% 到 4.8%) | 10,317 | 13.8 | 2 周 |
| 30%(4.0% 到 5.2%) | 4,783 | 6.4 | 1 周 |
双侧 5% 显著性、80% 功效、50 / 50 分流,向上取整到整周。提升减半,访客数大约变成四倍。
怎么分流,怎么确认分流没出问题?
没有特别理由,就用对半分流 50 / 50。经验法则论文的作者也这样建议:两组大小相等时,差值的分布近似对称(Kohavi 等,2014)。
每个访客只分配一次,整个测试期间留在同一组。把分配结果存进第一方 Cookie,登录用户则存在用户 ID 上,这样回访的人看到的还是同一个版本。
然后在看任何转化数字之前,先做样本比例检验。如果你本来想 50 / 50,两组的差距却超出了随机波动能解释的范围,说明分配或埋点坏了,结果不能信。示例里测试结束时 A 组 18,040 个访客,B 组 17,960 个。每组期望值是 18,000,所以:
卡方 = ((18,040 − 18,000)² + (17,960 − 18,000)²) ÷ 18,000 = 0.178,对应 p = 0.67
p 值这么大,说明分流和一枚公平硬币相符。如果值非常小(很多团队用 0.001 作警戒线),就该停下来找原因:只有某个版本会触发的机器人、让一侧丢失埋点的跳转,或依赖浏览器的分配逻辑。
另外要把机器人排除在分母之外。爬虫会抬高访客数,却没有转化,两组转化率都被拉低,测试变得不灵敏。经验法则论文也说明它的样本量是“剔除机器人之后”的数字。
怎么读结果?
示例按计划跑满四周后的最终数据:
| 分组 | 访客数 | 注册数 | 转化率 |
|---|---|---|---|
| A(7 个字段) | 18,040 | 722 | 4.002% |
| B(3 个字段) | 17,960 | 808 | 4.499% |
分五步算:
- 差值。4.499% − 4.002% = 0.497 个百分点,相对提升 12.4%。
- 合并转化率。(722 + 808) ÷ (18,040 + 17,960) = 4.250%。
- “没有差异”假设下的标准误。√(0.0425 × 0.9575 × (1/18,040 + 1/17,960)) = 0.00213。
- z 值。0.00497 ÷ 0.00213 = 2.34,对应双侧 p 值 0.0195。
- 差值的置信区间。用非合并标准误 0.00212:0.497 ± 1.96 × 0.212 = 0.08 到 0.91 个百分点,即相对 2.0% 到 22.8%。
p 值 0.02 低于你事先定的 0.05,所以这个提升在统计上显著。更有用的是区间:真实效应可能从几乎没有,到 23% 的相对提升,而观察到的 12.4% 低于你设计时的 15%。这很正常:测试按“检测 15% 提升、功效 80%”设计,更小的效应也能检测到,只是精度低一些。
庆祝之前有两点提醒。其一,区间下限接近零,所以做商业测算要用低端(相对 +2%),不要用点估计。其二,用上 Twyman 定律:如果提升大得离谱,先去找埋点错误再相信它。真正的突破式效应很少见。同一篇论文算过一个例子:如果典型效应以 0 为中心、标准差 0.25%,那么 +2.0% 就在均值之外八个标准差,所以即使结果显著,也该去查埋点错误,而不是庆祝(Kohavi 等,2014)。
p 值背后的统计原理看统计显著性。
中途偷看并提前停止会怎样?
固定样本量的测试,只有在最后看一次时才有效。每多看一次 p 值,随机波动就多一次越过 0.05 的机会。
为了看清问题有多大,我们用 Python 模拟了 4,000 次 A/A 测试(两组完全相同、转化率 4.0%、每组 18,000 个访客,随机种子固定)。只在最后看一次时,4.35% 的测试报告了“显著”差异,接近名义上的 5%。等间隔看五次、第一次 p < 0.05 就停,则有 14.55% 报告显著。同样的流量,同样完全相同的两组,假赢率大约变成了三倍。
实用规则:
- 固定样本测试(本文):事先定好结束日期,只读一次结果。看看仪表盘本身无害,只要你不据此行动。
- 序贯方法:如果必须能提前停,就用为此设计的方法(序贯检验或始终有效的检验),而不是把固定样本测试反复读。一家厂商的文档描述了这种做法,并警告:功效不足的结果看上去有希望,但提升上线后往往保不住(Optimizely)。
- 降低置信度是一种选择,不是技巧。降到 90% 能更快出结论,代价是假阳性变多;只有判错的成本很低、容易撤回时才可以接受。
Adobe 的文档还提醒:用 95% 置信度拿五个方案对比一个对照,至少出现一次假阳性的概率约为 18.5%。如果要测很多变体或很多指标,就把显著性阈值除以对比数,或者只选一个主指标。
最后上线哪个版本?
要看区间、护栏指标和判错的代价,而不是只看 p 值。
| 结果 | 提升的区间 | 护栏指标 | 决定 |
|---|---|---|---|
| 明显获胜 | 下限高于你认为值得的最小提升 | 持平或更好 | 上线 |
| 显著但幅度小 | 下限高于零,但低于值得的最小提升 | 持平 | 维护成本为零就上线,不要期待点估计 |
| 没有结论 | 区间跨过零 | 持平 | 视为“没检测到效应”,按成本和判断决定 |
| 显著变差 | 上限低于零 | 任意 | 保留 A,先弄清原因再试 |
| 赢了但护栏变差 | 下限高于零 | 变差 | 没弄清取舍前不要上线 |
对示例来说,3 个字段的表单属于显著但幅度小的获胜,相对提升下限 +2%。上线成本几乎为零(要维护的字段更少),护栏要先查(24 小时内确认邮箱),商业测算应该用 +2% 到 +12%,不要用 +23%。
如果做不了正规测试,前后对比总比没有强,但要写下这段时间还发生了什么变化,对比相同的星期几,并把结果当作假设。“没有效应”的结果也有用:它告诉你下个月不该把力气花在哪里。
在 TapCub 里怎么衡量两个版本?
TapCub 不做 A/B 测试:没有实验搭建器,不分流,也没有特性开关。谁来给访客分 A 或 B,由你自己的工具或代码负责。TapCub 负责衡量每一组发生了什么。以注册表单的例子来说:
- 让事件带上版本。让页面代码把分配到的版本(比如
form_variant = a或b)作为属性,放进重要的事件里:表单浏览和注册。两个版本用同样的名字。 - 数出每组的访客和转化。在 全端分析 › 行为分析 › 事件分析 里选注册事件,按版本属性拆分。表单浏览事件同样处理,就得到每组访客数;也可以在 全端分析 › 行为分析 › 行为分析 里建一个两步漏斗,分别对每个版本加筛选,比较转化率。
- 用合计数做样本比例检验。把两组访客数和你预期的分流比例对照,用上面的卡方计算。机器人会被识别并在 网站统计 › 机器人 里单独统计,不会抬高任何一组的访客数。
- 用自己的计算读区间。TapCub 给出计数和比率,置信区间和 p 值来自上面的公式,或来自你的测试工具。
- 标注日期。把测试开始、结束,以及期间的活动和发版,作为标注加到 配置 › 日期标注,让团队看得到当时还发生了什么。
FAQ
A/B 测试和多变量测试有什么区别?
A/B 测试比较两个版本之间的一处改动。多变量测试同时改动多个元素,估计每个元素的效应和它们之间的交互,需要多得多的流量。按本文的样本量,一次只测一处改动。
A/B 测试要跑多久?
要跑到计划的样本量,并向上取整到整周,最短是一个完整业务周期(七天)。示例里 35,886 个访客、每天 1,500 个,需要 23.9 天,所以跑四周。
A/B 测试需要多大的样本量?
取决于基线转化率、值得检测的最小提升、5% 显著性和 80% 功效。基线 4.0%、相对提升 15% 时,公式给出每组 17,943 个访客;提升 10% 则是 39,475 个。
流量很低能做 A/B 测试吗?
只适合大幅改动。每天 300 个访客时,基线 4.0%、要检测 30% 的相对提升,每组要 4,783 个,约 32 天。要检测 10% 的提升则要 260 多天,这时凭判断决定更实际。
多臂老虎机比 A/B 测试好吗?
多臂老虎机会在运行中把流量逐渐倾向更好的版本,减少让较差版本曝光的代价,但对差异大小的估计不如固定的 A/B 测试干净。要靠这个数字做决定时,用固定的 A/B 测试。
资料来源
- Kohavi, R., Deng, A., Longbotham, R., Xu, Y. (2014). Seven Rules of Thumb for Web Site Experimenters. KDD 2014(DOI 10.1145/2623330.2623341)。
- Adobe Experience League. How long should you run an A/B test?(样本量确定). Adobe Target 文档,2026-11-20 查阅。
- Optimizely Docs. How long to run an experiment. 2026-11-20 查阅。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
