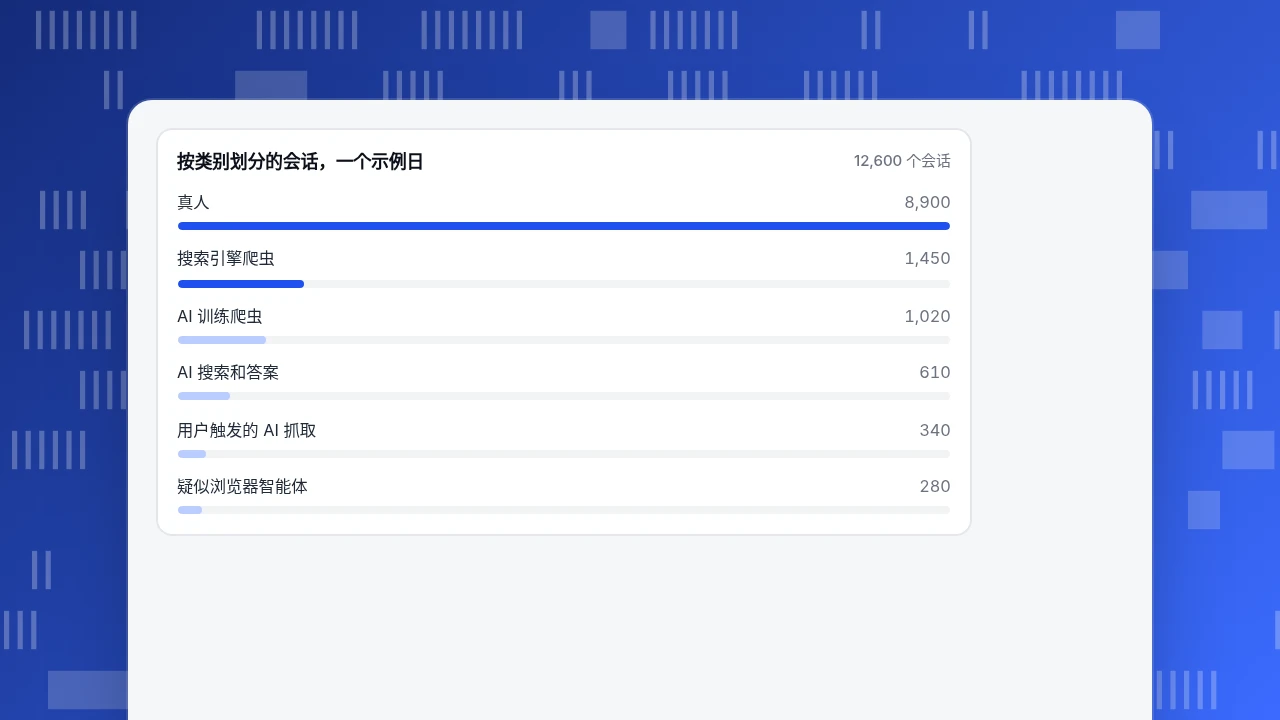
智能体分析就是把 AI 智能体和真人分开衡量。把请求分成四类(训练爬虫、搜索爬虫、用户触发的抓取器和驱动浏览器的智能体),匹配公布的用户代理标识,用运营方的 IP 列表或 DNS 核实,其余的按行为标记。在下面的示例日里,智能体占了 29.4% 的会话,让真人转化率看起来低了 29%。
读完你会知道
- 四类智能体流量要四种处理:训练和搜索爬虫遵守 robots.txt,用户触发的抓取器一般不遵守,浏览器智能体没有标准
- 用户代理的名字只是声明:用公布的 IP 列表或反向 DNS 核实,并记为已验证、疑似或未知
- 在示例日里,把智能体算作访客,让 3.00% 的真人转化率变成了 2.12%
哪些流量算 AI 智能体流量?
“AI 智能体流量”其实是四种不同的东西,需要四种不同的处理方式。把它们混在一起,是智能体分析让人困惑的最常见原因。
| 类别 | 做什么 | 示例标识 | robots.txt 是否适用 | 算不算真人访问 |
|---|---|---|---|---|
| 训练爬虫 | 抓取可能用于训练模型的页面 | GPTBot、ClaudeBot | 适用,厂商称会遵守 | 不算 |
| 搜索或答案爬虫 | 为 AI 搜索功能建立索引 | OAI-SearchBot、PerplexityBot、Claude-SearchBot | 适用 | 不算 |
| 用户触发的抓取器 | 因为有人向助手提问,打开某一个页面 | ChatGPT-User、Claude-User、Perplexity-User | 一般不适用,因为由用户发起 | 不算,但背后有真人 |
| 驱动浏览器的智能体 | 操作完整浏览器,替人或脚本点击浏览网站 | 常常是普通的 Chrome 用户代理 | 没有标准 | 看起来像,其实不是 |
前三类通常会在用户代理里报上名字,第四类不会,所以还需要行为信号。本文讲怎样把这四类都和真人会话分开、这会怎样改变你的转化率,以及怎样衡量智能体在做什么。
哪些用户代理会自报身份,厂商怎么说?
大型 AI 助手的运营方会公布爬虫名称。下表的事实都是 2026-11-20 从各厂商自己的文档读到的;字符串里的版本号会变,所以按标识匹配,不要匹配整串。
| 标识 | 运营方声明的用途 | robots.txt |
|---|---|---|
| GPTBot | 抓取可能用于训练生成式 AI 基础模型的内容 | 适用 |
| OAI-SearchBot | 让网站出现在 ChatGPT 的搜索功能里,不用于训练 | 适用,改动约 24 小时生效 |
| ChatGPT-User | 用户提问或自定义 GPT 动作时访问页面 | “robots.txt 规则可能不适用”,因为是用户发起的 |
| ClaudeBot | 收集可能用于模型训练的网页内容 | 遵守,支持 Crawl-delay 指令 |
| Claude-User | Claude 用户的问题需要时抓取页面 | 厂商称遵守 |
| Claude-SearchBot | 抓取以提升搜索回复的相关性 | 厂商称遵守 |
| PerplexityBot | 在搜索结果中呈现并链接网站,“不用于抓取内容训练 AI 基础模型” | 建议允许 |
| Perplexity-User | 用户提问需要时抓取页面 | “通常忽略 robots.txt 规则” |
出处:OpenAI、Anthropic、Perplexity。
由此有两点结论。其一,robots.txt 里屏蔽训练爬虫,并不能挡住同一运营方的用户触发抓取器,因为厂商说这类请求不受它约束。其二,屏蔽搜索爬虫可能让你从该助手的答案里消失,因为厂商把它描述为建索引的爬虫。要按类别决定,不要按品牌决定。相关字段见用户代理和AI 爬虫。
| 标识 | 声明的用途 | robots.txt |
|---|---|---|
| GPTBot | 收集训练数据 | 适用 |
| OAI-SearchBot | 搜索功能,不用于训练 | 适用 |
| ChatGPT-User | 用户提问时抓取 | 可能不适用 |
| ClaudeBot | 收集训练数据 | 遵守 |
| Claude-User | 用户提问时抓取 | 厂商称遵守 |
| PerplexityBot | 搜索结果,不用于训练 | 建议允许 |
| Perplexity-User | 用户提问时抓取 | 通常忽略 |
取自各运营方文档,2026-11-20 查阅。按标识匹配,不要匹配字符串里的版本号。
怎么分辨真的智能体和冒充的?
用户代理字符串只是客户端自己选择发送的一段文字。任何人都可以在脚本里写上“GPTBot”,所以自报的名字只是声明,不是证明。robots.txt 标准明确写道,它的规则“不是一种访问授权”,爬虫只是被“请求遵守”(RFC 9309)。
计数或屏蔽之前先核实,依据是运营方公布的信息:
- 对照公布的 IP 列表。Perplexity 用 JSON 文件公布了两个智能体的地址段,并要求站长把每个机器人的用户代理和它自己的地址段对应。Anthropic 说,来自其公布列表(claude.com/crawling/bots.json)中地址的请求才是 Anthropic 发的。如果请求声称是某个标识,却来自列表之外,就当作未验证。
- 运营方有文档时,用反向和正向 DNS。Google 对 Googlebot 的流程是:对 IP 做反向 DNS,确认域名是 googlebot.com、google.com 或 googleusercontent.com,再对这个名字做正向 DNS,确认返回原来的 IP(Google)。
- 把结果记成状态,不是是或否。用三种:已验证、疑似、未知。“未知”不等于“假冒”:大多数运营方并没有公布反向 DNS 规律。
在没读运营方建议之前,不要只按 IP 屏蔽。例如 Anthropic 说,屏蔽 IP 可能无法持续地让你退出,因为这会阻止机器人读取 robots.txt。
怎么发现长得像浏览器的智能体?
有些智能体驱动真实浏览器,发送普通的浏览器用户代理。你无法靠名字找到它们,但可以靠会话的行为找到不少,因为真人会话和脚本会话在日志里留下的形状不同。
| 信号 | 典型的真人会话 | 典型的脚本会话 |
|---|---|---|
| 每个页面带的静态资源(CSS、JS、图片) | 很多 | 以文本方式抓页面时很少或没有 |
| 每分钟页数 | 1–3 个,有停顿 | 几十个,间隔均匀 |
| 先请求 robots.txt | 从不 | 声明身份的爬虫有时会 |
| 运行页面 JavaScript | 是 | 常常不运行 |
| 来源 | 搜索、社交、直接访问或某个助手 | 没有来源 |
| 路径特征 | 来回浏览、回到之前的页面 | 按站点地图顺序或数字序号扫过去 |
一条容易执行也容易解释的规则:会话在 2 分钟内请求至少 30 个页面,且静态资源请求为零,就标记为疑似智能体。动手之前要人工复核匹配结果。合法的例外是有的:链接预取、只加载文本的读屏软件、你自己设置的可用性检测,或者把很多人藏在同一个地址后面的企业代理。
示例会话(示例数据)展示这条规则的表现:
| 会话 | 2 分钟内页数 | 静态资源 | 自报标识 | 类别 |
|---|---|---|---|---|
| S1 | 3 | 41 | 无 | 真人 |
| S2 | 52 | 0 | GPTBot | 自报的训练爬虫 |
| S3 | 1 | 0 | ChatGPT-User | 自报的用户触发抓取 |
| S4 | 44 | 0 | 无(Chrome 字符串) | 疑似智能体 |
| S5 | 5 | 0 | 无 | 真人(预取或读屏软件,低于 30 页阈值) |
S5 说明阈值为什么重要:几个纯文本请求,不足以把它判成智能体。
智能体对你的数字有什么影响?一个算例
假设一个网站某天不做任何机器人过滤,统计到 12,600 个会话。按上面的方法分类(示例数据,数量已用 Python 复算):
| 类别 | 会话数 | 占全部会话的比例 |
|---|---|---|
| 真人 | 8,900 | 70.6% |
| 搜索引擎爬虫 | 1,450 | 11.5% |
| 自报的 AI 训练爬虫 | 1,020 | 8.1% |
| 自报的 AI 搜索和答案爬虫 | 610 | 4.8% |
| 自报的用户触发 AI 抓取器 | 340 | 2.7% |
| 疑似浏览器式智能体 | 280 | 2.2% |
| 合计 | 12,600 | 全部会话 |
同一天网站记录了 267 次注册。只有真人会注册,所以:
- 真人会话的转化率:267 ÷ 8,900 = 3.00%。
- 全部会话的转化率:267 ÷ 12,600 = 2.12%。
把智能体算作访客,让真人转化率被低估了 29%(1 − 2.12 ÷ 3.00)。网站什么都没变,是分母被污染了。如果这时你在页面上做测试,这些噪声会拉低基线,让真实的提升更难被检测出来。
同一张表还说明,12,600 个会话里有 3,700 个(29.4%)不是真人。这个比例只属于这个样本;你的网站是多少,只有测了才知道。
按类别划分的会话,一个示例日
12,600 个会话智能体到底在做什么:只读,还是会带人回来?
把真人分出去之后,智能体流量真正有用的问题是一个“兑换率”。3,700 个非真人会话里,有 1,970 个是自报的 AI 读取(1,020 + 610 + 340)。同一天,有 61 位真人访客是从 AI 助手的链接来的。于是:
1,970 次读取 ÷ 61 位带回的访客 = 每位真人访客 32.3 次读取。
解读这个数字要小心。它描述的是一个网站的一天,不是对任何运营方的评判。训练爬虫读页面,本来就不指望带人回来;答案引擎才应该。所以要按类别拆开:1,020 次训练读取,预期没有回访;950 次答案和抓取读取(610 + 340)对 61 次访问,是每位访客 15.6 次读取。要看的是你改了内容或 robots.txt 规则之后它怎么变,而不是拿绝对值去和别的网站比。
三个问题让智能体数据有用处:
- 智能体读得最多的是哪些页面?如果是价格页和文档页,这些就是助手会引用的页面,要保证它们准确。
- 它们读到的是干净的答案吗?看每个爬虫最常见的状态码。大多收到 404 或 5xx 的爬虫,读到的是错误页。
- 你写的规则和实际流量对得上吗?如果在 robots.txt 里屏蔽了训练爬虫之后,用户触发的抓取器仍在来,这符合厂商文档,不是故障。要拦住它,用防火墙规则。
读取你分析数据的智能体呢?
“分析智能体”也指反方向:你自己的 AI 智能体来查询你的分析数据。稳妥的做法是用范围受限的密钥只读访问,这样智能体能回答上周流量的问题,但不能改设置或删数据。它返回的每个数字,都像同事给你的数字一样对待:要求看背后的查询,并手工核对一个数字。TapCub 关于用 MCP 连接 AI 智能体的文档介绍了这条只读路径。
在 TapCub 里怎么衡量智能体流量?
用上面的例子,在 TapCub 里做同样的分离。
- 确认机器人单独统计。新项目默认识别机器人并单独统计,认出来的机器人只进机器人报表,不会抬高真人访客、会话和转化率。只有 不识别 这个设置会把它们混进来,文档不建议这样做。
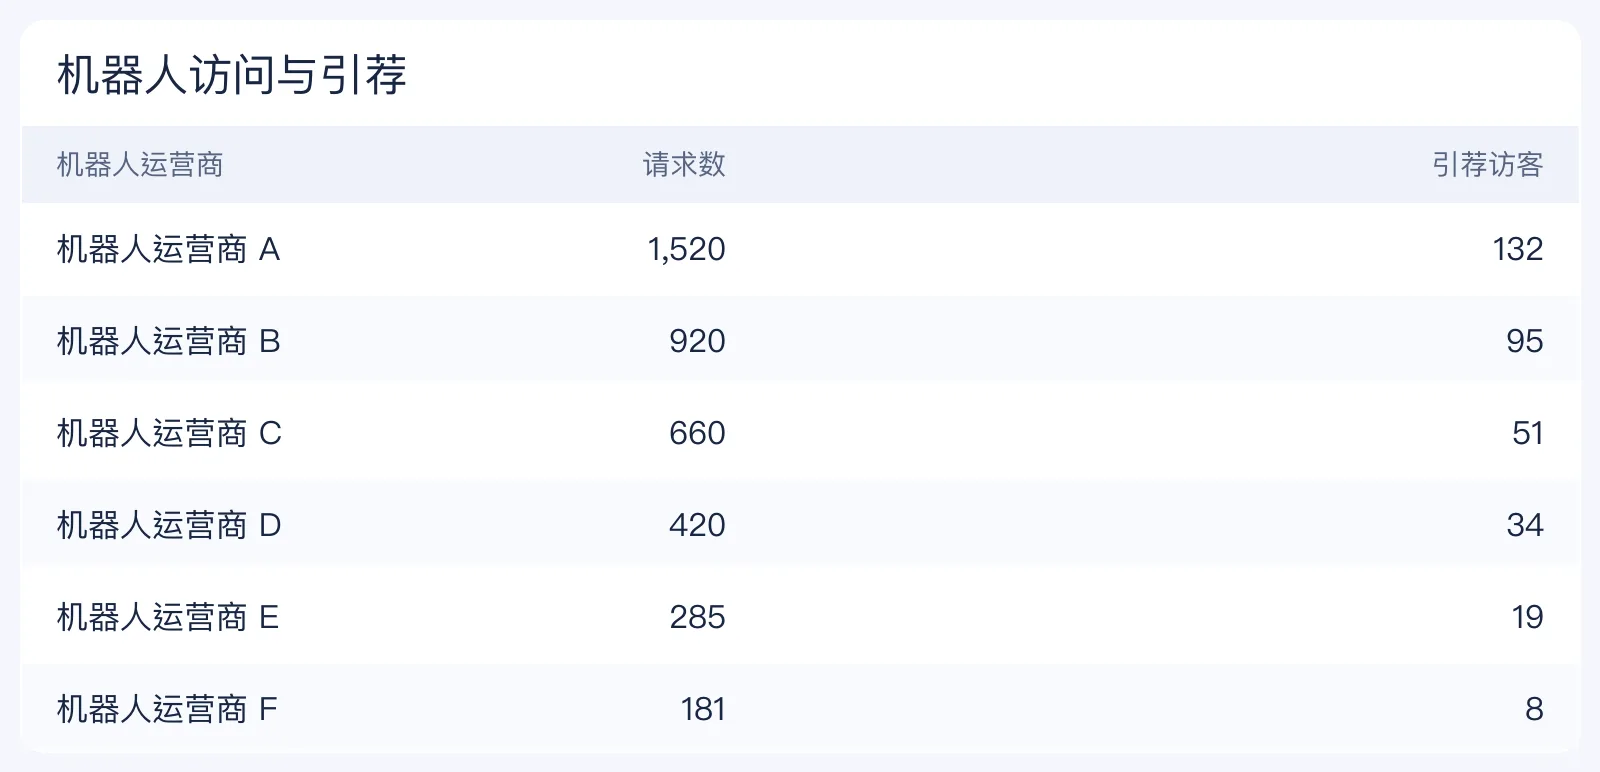
- 打开 网站统计 › 机器人。 在 AI 与智能体 页签,卡片显示 AI 请求、AI 智能体、AI 爬虫和带回的访问。AI 内容账本 按运营方列出读取次数(训练爬虫和答案引擎分两列)、带回的真人访客和比值,比值是读取次数除以访客数。按示例,总体比值是 32.3 : 1。
- 在 全部机器人 里查看一个爬虫。表格列出名称、运营方、用途、请求数、访问页数、最常见状态码、最后出现时间、可信度和命中的检测层。可信度分已验证、疑似、未知;未知本身不代表冒充。某一行认错了,可以报误判。
- 了解边界。只用页面脚本时,TapCub 只看得到会运行 JavaScript 的机器人。不运行脚本的爬虫,以及状态码和响应时间,需要服务端采集:用你的服务器通过服务端事件接口发送这些请求,该接口只保留被识别为机器人的请求。见机器人与 AI 爬虫和读懂 AI 爬虫账本。
- 和真人对照。在 AI 可见性 和 来源 › AI 来源 里,带回的访问是真人会话,所以可以在一处把读取次数和人数放在一起看。完整的账本解读见AI 爬虫账本。
TapCub 不会拦截或限速任何爬虫,只负责衡量。拦截要在 robots.txt 或你的防火墙里做。
FAQ
什么是智能体分析?
衡量 AI 智能体在你的网站或产品上做了什么:哪些智能体来过、读了什么、是否已验证,以及带回多少真人流量,并和真人会话分开。
怎么识别 AI 智能体流量?
先匹配运营方公布的用户代理标识,用公布的 IP 段或反向 DNS 核实,再按行为标记没有自报身份的会话,比如读了很多页面却没有静态资源请求。
AI 智能体会遵守 robots.txt 吗?
训练和搜索爬虫在文档里说会遵守。ChatGPT-User、Perplexity-User 这类用户触发的抓取器,文档里说不受它约束,因为请求是由人发起的。
要不要屏蔽 AI 智能体?
按类别决定。屏蔽训练爬虫是退出训练;屏蔽搜索爬虫可能让你从该助手的答案里消失。先看账本里的读取次数和带回的访问,再做选择。
为什么有些 AI 爬虫不出现在基于页面脚本的报表里?
页面脚本只有在客户端执行 JavaScript 时才会运行。不运行脚本的爬虫只出现在服务器日志里,不会出现在基于脚本的报表里,所以 TapCub 的文档为它们提供服务端采集。
资料来源
- OpenAI. Overview of OpenAI crawlers. 2026-11-20 查阅。
- Anthropic. Does Anthropic crawl data from the web, and how can site owners block the crawler?. 2026-11-20 查阅。
- Perplexity. Perplexity crawlers. 2026-11-20 查阅。
- Google Search Central. Verifying Googlebot and other Google crawlers. 2026-11-20 查阅。
- Koster, M., Illyes, G., Zeller, H., Sassman, L.(2022). RFC 9309: Robots Exclusion Protocol. IETF。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
