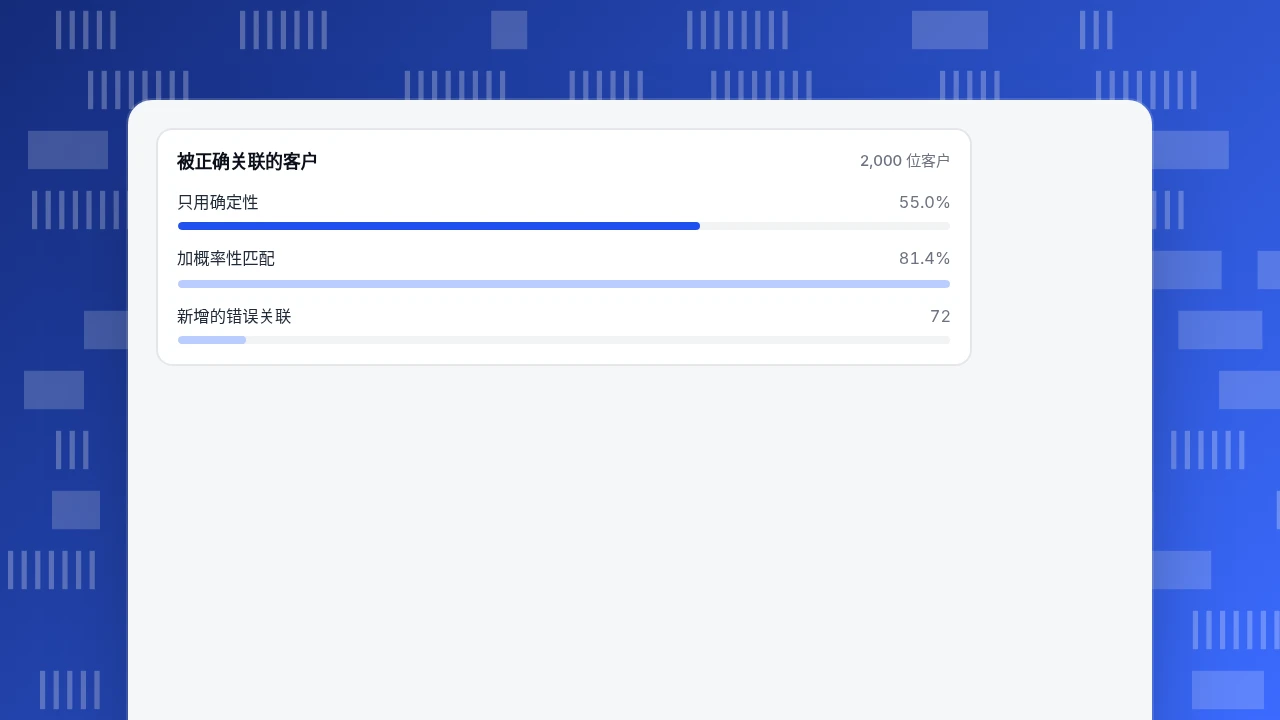
AI CDP 是加入了机器学习或语言模型功能的客户数据平台:概率性身份匹配、预测分数、人群构建和自然语言助手。AI 不会凭空产生客户数据,所以每项功能都受底层标识的限制。在下面的示例里,概率性匹配把被关联的客户从 55.0% 提高到 81.4%,但多出了 72 个错误合并。
读完你会知道
- 每项 AI 功能的上限都由底层数据决定:身份要有确定性锚点,分数要有结果,人群要有去处
- 概率性身份关联用于分析,不要用于无法撤回的操作:新增的 600 个关联里有 72 个是错的
- 一个不错的流失模型联系 1,000 人仍亏了 $200;只有精确率超过盈亏平衡点(这里是 16.7%)的部分才值得行动
什么是 AI CDP,AI 到底多了什么?
客户数据平台(CDP),按 CDP Institute 的说法,是“创建并维护一份持久、统一、可供其他系统访问的客户记录的软件”(CDP Institute)。这句话里有三件事:从多个系统收集数据,把属于同一个人的记录关联起来,再把结果开放给其他工具。
“AI CDP”就是在这三件事之上加了机器学习或语言模型功能的 CDP。实际上厂商说的是四样东西:
AI 不会凭空产生客户数据,也无法修复从没采集过的标识。下面每一项能力,上限都由底层数据决定,本文用能复算的数字指出这个上限在哪里。
每项 AI 能力需要什么,会在哪里失效?
用这张表,把一堆功能列表变成可以拿去追问的问题。
| 能力 | 做什么 | 需要什么 | 在哪里失效 | 依赖它之前要问 |
|---|---|---|---|---|
| 身份识别 | 把设备 ID、邮箱和登录合并成一个档案 | 至少有一些确定性锚点,比如登录 | 错误合并会把两个人并成一个;错误拆分会把一个人算两次 | 在你人工核对过的样本上,错误合并率是多少? |
| 预测 | 给每位客户打流失、购买或价值分数 | 足够多的历史结果、干净的标签、稳定的行为 | 分数能给人排序,但对多数个体是错的 | 排在最前面那一段的精确率是多少,是否高于盈亏平衡点? |
| 人群 | 按规则、模型或描述生成分群 | 新鲜的数据,以及能接收名单的目的地 | 成员过期;分群太小;和其他活动重叠 | 成员多久刷新一次,规模和重叠有多大? |
| 助手 | 用自然语言回答问题 | 能访问真实数据,并留下查询记录 | 说得流畅却不对应任何查询 | 我能看到每个数字背后的查询吗? |
接下来的小节用示例数据走一遍前三项。助手的部分见 AI 营销分析。
| 能力 | 需要什么 | 在哪里失效 | 依赖它之前要问 |
|---|---|---|---|
| 身份识别 | 一些确定性锚点,比如登录 | 错误合并和错误拆分 | 在人工核对的样本上的错误合并率 |
| 预测 | 历史结果和稳定的行为 | 能给人排序,但对多数个体是错的 | 要行动的那一段精确率与盈亏平衡点对比 |
| 人群 | 新鲜的数据和目的地 | 过期或太小的分群;重叠 | 刷新间隔、规模、重叠 |
| 助手 | 能访问真实数据 | 说得流畅却没有查询 | 我能看到每个数字背后的查询吗? |
表里概括了四项能力,下面的小节会复算前三项。
AI 能多准确地把记录匹配到同一个人?
身份识别有两种方法。确定性匹配把共享同一个精确标识(比如同一个登录或同一个哈希邮箱)的记录关联起来:精确,但漏掉所有从没表明身份的人。概率性匹配用较弱的证据(设备类型、时间、位置、行为)给记录对打分,超过阈值就关联:覆盖的人更多,但有时会关联错。统计基础可以追溯到 Fellegi 和 Sunter 1969 年的记录关联理论:你选一个阈值,在错误匹配和漏掉的匹配之间取舍,两者不能同时消除(Fellegi 和 Sunter,1969)。
为什么本来就有一块缺口要补?因为浏览器限制匿名标识的寿命。Safari 的跟踪防护会在用户 7 天没有与网站交互后,删除由 JavaScript 写入的 Cookie 和其他脚本可写的存储;检测到链接装饰时,Cookie 的有效期上限是 24 小时(WebKit)。一位客户第 0 天来过、第 9 天回来,在登录之前可能看起来是两个访客。
一个算例(示例数据,已用 Python 复算)。假设一家店有 2,000 位客户,他们的多台设备本来可以合并成各自的档案。
| 步骤 | 建立的关联数 | 正确的关联数 | 精确率 | 被正确关联的客户占比(召回率) |
|---|---|---|---|---|
| 只用确定性(共享登录) | 1,100 | 1,100 | 全部正确 | 55.0% |
| 加上概率性匹配 | +600 | +528 | 新增部分 88.0% | 不适用 |
| 两者合计 | 1,700 | 1,628 | 95.8% | 81.4% |
读表:
- 加上概率性这一步,被关联的客户占比从 55.0% 提高到 81.4%,多出 528 个正确关联。
- 代价是 72 个错误关联(600 − 528)。每个错误关联都会把两个不同的人并进一个档案,结果就是消息发给了错的人,或者一笔购买记到了错的客户名下。
- 合计的 F1 分数(衡量匹配质量最常用的单一数字)是 2 × 0.958 × 0.814 ÷ (0.958 + 0.814) = 0.88;只用确定性是 0.71。
判断规则:概率性关联用于分析,不要用于无法撤回的操作。统计人群规模,或衡量一位典型客户用几台设备,可以容忍合并结果里 4% 的误差。但给概率性合并出来的档案发个人优惠、账户通知或退款,就不行。向任何厂商要一个在你自己数据上、人工核对过的样本里测出的错误合并率。
被正确关联的客户
2,000 位客户AI 能预测谁会流失吗,分数什么时候值得据此行动?
预测就是每位客户一个分数,评价它的有用方式,是看你要行动的那一段精确率,并和盈亏平衡线对比。
示例数据:10,000 位客户,其中 5%(500 位)本季度会流失。模型给所有人打分,我们按分数从高到低把客户分成十等份:
| 分数分组(每组 1,000 位客户) | 组内流失人数 | 精确率 | 相对 5% 基准的提升倍数 | 占全部流失者的累计比例 |
|---|---|---|---|---|
| 1(最高) | 150 | 15.0% | 3.0 | 30% |
| 2 | 100 | 10.0% | 2.0 | 50% |
| 3 | 70 | 7.0% | 1.4 | 64% |
| 4 | 50 | 5.0% | 1.0 | 74% |
| 5–10 | 130 | 平均 2.2% | 0.4 | 全部 |
按通常的标准,这是个不错的模型:分数最高的 10% 抓到了 30% 的流失者,比随机挑选好三倍。但在最高那一组里,被标出来的人有 85% 不会流失。
这有没有用,取决于行动的成本和能挽回多少。假设一次挽留优惠联系每人花 $2,能留住 20% 本来会走的客户,留住一位客户值 $60。
- 盈亏平衡精确率 = 成本 ÷(留存率 × 价值)= 2 ÷ (0.20 × 60) = 16.7%。
- 联系最高那一组:花 1,000 × $2 = $2,000;150 位流失者 × 20% = 30 位留住 × $60 = $1,800。净额 −$200。
- 只联系那一组里靠前的一半(500 位客户,假设有 90 位流失者,精确率 18.0%):花 $1,000;18 位留住 × $60 = $1,080。净额 +$80。
同一个模型,联系 1,000 位亏钱,联系 500 位赚钱。所以规则是:把截断线定在精确率超过盈亏平衡点的地方,并且拿一个没收到优惠的留出组来衡量留下来的人数。分数不等于决定。如果只凭一个分数就对个人做出有法律后果或类似重大影响的决定,比如信贷或定价,欧盟 GDPR 赋予人们不受仅基于自动化处理(包括画像)作出的决定约束的权利(第 22 条第 1 款);要把这类事自动化之前,请先咨询法律意见(GDPR 第 22 条)。
AI 帮你建的人群有多好?
人群是符合某条规则、某个模型分数或某段描述的一份名单。AI 改变的是创建的速度,不会改变什么才算有用。向一个人群发送之前,检查四件事:
| 检查 | 原因 | 通过的标准 |
|---|---|---|
| 规模 | 名单太小,结果读不出来 | 每个测试组预期的转化数要明显高于几十个 |
| 新鲜度 | 每周才更新的成员,会漏掉昨天刚离开页面的访客 | 刷新间隔短于决策窗口 |
| 重叠 | 同一个人出现在五个人群里,就会收到五条消息 | 数一数有多少人同时在多个生效的人群里 |
| 留出组 | 没有对照组,就分不清是效果还是选择 | 每次发送都留出一个随机的小部分(比如 10%) |
留出组是最常被跳过的一项。符合“购买可能性高”的人本来就要买,所以事后看到的销量,大部分并不是这条消息造成的。想看一个表面的提升里有多少是选择造成的,同样的逻辑出现在衡量聊天机器人的回报和 A/B 测试的指南里。
在 CDP 里加 AI 之前该先决定什么?
按这个清单往下走,遇到第一个“否”就停。
- 你有确定性锚点吗?如果很少有活跃客户登录或留下邮箱,大部分工作就要靠概率性匹配,它的误差会占主导。先把采集做好。
- 你能写出一个会因分数而改变的决定吗?“谁收到挽留优惠”是决定,“一个流失分数”不是。
- 你有足够多的结果吗?罕见事件只有极少的样本,训练不出可靠的模型。
- 你能留出对照组吗?不能的话,就无法衡量收益,也就无法证明成本合理。
- 这个人群有地方可去吗?没法发到邮件、广告或消息工具的人群,只是一份报表,不是一次激活。
- 你能看到每个数字是怎么得出来的吗?对助手来说,一定要看到背后的查询。
TapCub 在这里做什么,不做什么?
TapCub 不是完整的客户数据平台。它不会把人群发送到邮件或广告工具,不做 CRM 和邮件营销,也没有预测分数。它提供的,是上面这些比较所依赖的衡量和身份层,并且都在一个项目里。用上面的例子走一遍:
- 建立确定性锚点。有人登录时调用
tapcub.login()。这个人就会出现在 全端分析 › 用户 › 用户,档案里有按天排列的时间线,会把绑定在同一个登录 ID 上的设备合并起来。匿名访客会被统计,但没有档案,而且识别模式在撰写本文时是付费套餐的功能,请在文档里确认你的套餐。 - 把人分成分群。在 全端分析 › 用户 › 分群与标签 里,可以建规则分群(每天或手动刷新)、粘贴 ID 列表的静态分群,或实时分群。那里还有 10 组 RFM 分桶和分群人数的 30 天趋势。匿名访客不会进入分群,这和上面身份表里“只用确定性”那一行一致。
- 检查新鲜度和重叠。分群页面会记录每次刷新时谁加入、谁离开;如果配置了 Webhook,TapCub 会发出成员变化通知。分群之间的重叠,要自己对照成员数来比较。
- 预测要靠你自己。TapCub 给任何一组人报告计数和比率,但不给流失打分。如果你在别处算出分数,把结果作为事件带回来,在 全端分析 › 行为分析 › 行为分析 里把被标记的人群和留出组做比较。
- 向助手提问,并读它的查询。 全端分析 › 智能运营 › AI 助手 根据在你项目上运行的分析查询来回答,你自己的 AI 智能体也可以通过只读连接读取数据。它不会创建监控,也不会发通知。身份相关的步骤见识别用户。
FAQ
什么是 AI CDP?
加了机器学习或语言模型功能的客户数据平台:概率性身份匹配、预测分数、人群构建和自然语言助手。数据采集和统一仍然来自底层平台。
CDP 和数据仓库有什么区别?
CDP Institute 把 CDP 描述为创建并维护持久、统一的客户记录、并让其他系统可访问的软件。仓库负责存数据;CDP 还要负责客户身份,并把统一后的记录开放出去。
AI 身份识别有多准?
取决于你的数据。上面的示例里,确定性匹配全部正确但只关联了 55% 的客户;加上概率性匹配后关联了 81.4%,整体精确率 95.8%。向厂商要在你自己核对过的样本上测出的错误合并率。
只做分析,需要 CDP 吗?
往往不需要。如果你要的是网站和 App 上一致的身份与衡量,带登录身份和分群的分析产品可能就够了。只有当你必须把统一的人群推送到很多激活工具时,才需要 CDP。
客户打分受隐私法约束吗?
可能受。仅基于自动化处理、且带来法律后果或类似重大影响的画像决定,适用 GDPR 第 22 条第 1 款。只给邮件名单排序的营销分数通常不同,但你的情况要咨询法律意见。
资料来源
- Customer Data Platform Institute. What is a CDP? 2026-11-20 查阅。
- Fellegi, I. P. and Sunter, A. B.(1969). A Theory for Record Linkage. Journal of the American Statistical Association 64(328)。
- WebKit. Tracking Prevention in WebKit. 2026-11-20 查阅。
- 欧盟. General Data Protection Regulation, Article 22. 2026-11-20 查阅。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
