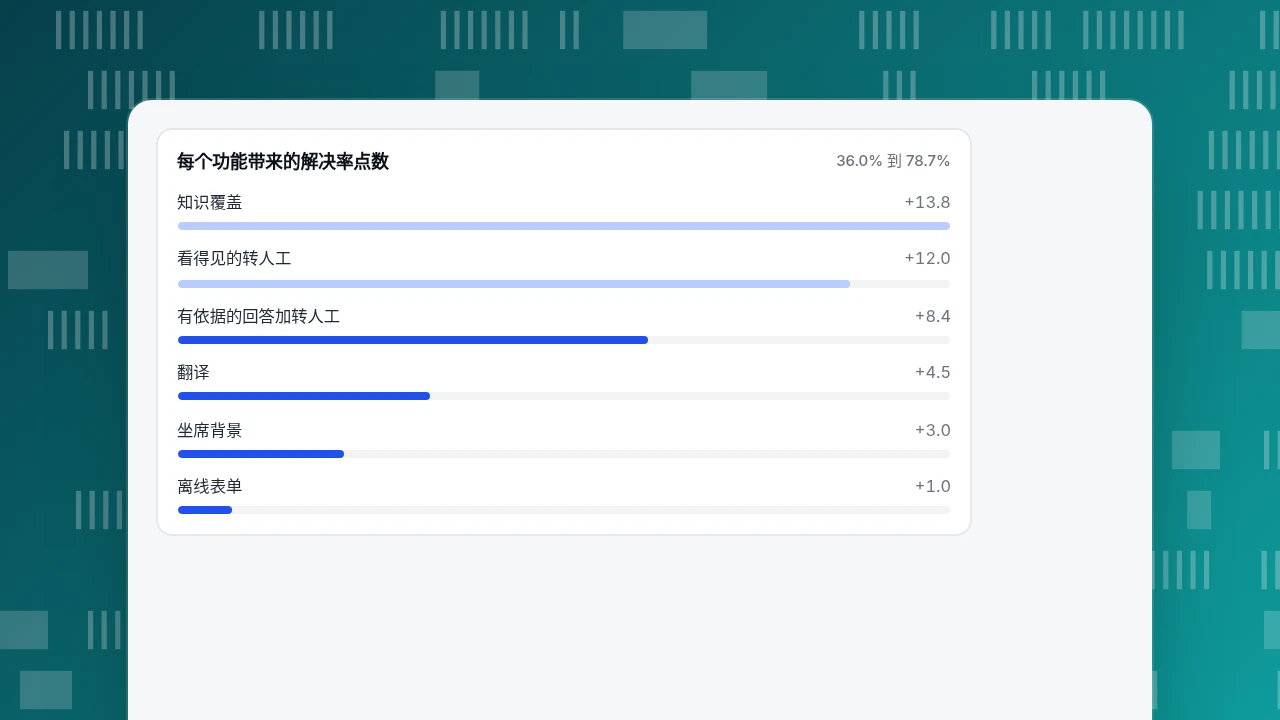
对客服重要的 AI 聊天机器人功能,是能挽救未解决会话的那些:知识覆盖加精确匹配的答案、看得见的联系真人的方式、只用你的资料作答、翻译,以及给坐席的背景。在示例月里,它们把解决率从 36.0% 提到 78.7%,其中覆盖加转人工贡献了 42.7 个点里的 25.8 个点。装饰性选项得零分。
读完你会知道
- 按挽救的会话数给每个功能打分:示例里知识覆盖(+13.8 点)和转人工(+12.0 点)胜过其他所有功能
- 转人工要算数:客户能主动要求、机器人会自己转、记录原因、坐席能看到访客是谁
- 没把握就转人工会降低机器人单独解决的占比,却提高解决率,因为有人把事情做完了
评价 AI 聊天机器人的功能,该用什么标准?
评价每个功能只问一个问题:它能让更多客户的问题得到解决吗?解决率是周期内标记为已解决的会话数除以全部会话数,不论是机器人还是人解决的。这是合适的标尺,因为客服机器人常见的失败都是没能解决:机器人没有答案、给了错误答案,或者让客户卡在原地。
监管机构和研究者描述的是同一种模式。美国消费者金融保护局(CFPB)2023 年对银行聊天机器人的审视指出,客户可能陷入重复的、无用的回答循环,它称之为“死循环”,还有些聊天机器人让人“没有通往真人客服的出口”。报告引用的一项调查里,80% 用过聊天机器人的消费者感到更沮丧,78% 之后还需要联系真人(CFPB,2023)。Nielsen Norman Group 的一项聊天机器人可用性研究发现,机器人承认失败并给出出口时,用户反应良好,而重复的回答会惹恼他们。该研究只有 8 名参与者,只能当作方向性参考(NN/g)。
所以下面的评级,按每个功能能挽回多少未解决的会话来排序。装饰性功能在这个尺度上得零分,这本身就是一个正当的结论。
哪些会话会失败,每一种该用哪个功能挽救?
从会话为什么失败说起,因为每种失败的解法不同。下面是一个只有答案来源、别的什么都没有的机器人一个月的示例(示例数据,1,000 个会话):
| 结果 | 会话数 | 占比 |
|---|---|---|
| 已解决 | 360 | 36.0% |
| 失败:知识库里没有答案 | 230 | 23.0% |
| 失败:客户卡住,没有办法联系真人 | 150 | 15.0% |
| 失败:机器人给了错误或不相关的答案 | 120 | 12.0% |
| 失败:客户用了机器人处理不了的语言 | 60 | 6.0% |
| 失败:请求需要不了解访客的坐席来处理 | 60 | 6.0% |
| 失败:客户来信时没有人在线 | 20 | 2.0% |
| 合计 | 1,000 | 全部 |
基线解决率:360 ÷ 1,000 = 36.0%。示例把 640 个失败拆成六种原因。接下来把功能和原因对上,并明确说出每个功能能挽救多少这类失败。这些挽救率是示例里的假设,不是实测值;请换成你自己会话里的数字。
| 失败类型 | 会话数 | 占比 |
|---|---|---|
| 已解决 | 360 | 36.0% |
| 知识库里没有答案 | 230 | 23.0% |
| 客户卡住,没有办法联系真人 | 150 | 15.0% |
| 错误或不相关的答案 | 120 | 12.0% |
| 语言处理不了 | 60 | 6.0% |
| 坐席不了解访客 | 60 | 6.0% |
| 没有人在线 | 20 | 2.0% |
示例数据:只有答案来源、没有其他功能的机器人,1,000 个会话。基线解决率 36.0%。
哪些功能最重要?分级清单
每个功能:挽救的会话 = 该类失败数 × 假设的挽救率;点数 = 挽救的会话 ÷ 1,000。
| 排名 | 功能 | 针对的失败 | 失败数 | 假设的挽救率 | 挽救的会话 | 解决率提高的点数 |
|---|---|---|---|---|---|---|
| 1 | 知识覆盖,高频问题用精确匹配的答案 | 知识库里没有答案 | 230 | 60% | 138 | +13.8 |
| 2 | 看得见的联系真人的方式,加轮数上限 | 客户卡住 | 150 | 80% | 120 | +12.0 |
| 3 | 只用你的资料作答,没把握就转人工 | 错误或不相关的答案 | 120 | 70% | 84 | +8.4 |
| 4 | 双向翻译 | 语言不通 | 60 | 75% | 45 | +4.5 |
| 5 | 转人工时把访客背景展示给坐席 | 坐席不了解访客 | 60 | 50% | 30 | +3.0 |
| 6 | 离线留言表单 | 没有人在线 | 20 | 50% | 10 | +1.0 |
加起来:138 + 120 + 84 + 45 + 30 + 10 = 多解决 427 个会话。解决率从 360 ÷ 1,000 = 36.0% 变成 (360 + 427) ÷ 1,000 = 78.7%。
排名里有三点启示。
- 最大的两项收益根本不是“AI”。覆盖和转人工合计占 42.7 个点里的 25.8 个点。一个团队花一个月调模型,却不管知识缺口和卡住的客户,就是在错的一头使劲。
- 第 3 项会降低机器人自己解决的占比,却能提高解决率。没把握就转人工,意味着机器人自己回答的问题变少了;解决率上升,是因为有人把事情做完了。
- 实际操作中顺序很重要。先加转人工(+12.0),在接下来几周补知识缺口(+13.8)的同时,也保护着客户。
没进表的功能在这里得零分:机器人的名字和头像、友好语气的设置、表情符号、打字动画。它们可能影响聊天的感觉,但不能挽救上面六种失败里的任何一种。不要因为它们而买。
每个功能带来的解决率点数
36.0% 到 78.7%“转人工”要包含什么才算功能?
“转人工”出现在每家厂商的清单里,所以要看细节,因为不起作用的转人工,就是 CFPB 报告里的死循环。一个有效的转人工有五个特点:
- 客户随时可以要求,用平实的话说就行,第一次要求就被满足。
- 机器人会自己转:在一定数量的无效轮次之后自动转,所以客户永远不会被困住。
- 记录原因(无匹配、模型无法回答、客户要求、轮数上限),这样你能看出表里六种失败原因分别占多少。
- 有一条消息说明接下来会怎样,包括没人在线时怎么办(一个留下邮箱和问题的表单)。
- 坐席能看到对话和访客是谁,不用再问一遍。
测试很简单:打开你自己的聊天,问一个机器人答不了的问题,数一数要经过多少条消息才能联系到真人或看到留言表单。经验上,超过四五条就是在形成循环。
准确性和诚实相关的功能呢?
语言模型能写出流畅却错误的答案。CFPB 的审视警告说,这类聊天机器人“不擅长区分事实正确和不正确的数据”,错误可能造成实际伤害。准确性功能可以降低这种风险:
- 只用批准的资料作答。从你自己页面检索出来的答案可以核对;来自模型通用知识的答案不行。
- 高风险问题优先用精确匹配。退款政策或送达期限应当原样发送,而不是转述。
- 错误答案只需纠正一次。坐席改正一个答案后,修正应当被存下来,下次同样的问题就得到更正后的答案。
- 标明这是 AI。在欧盟,《AI 法案》第 50 条第 1 款要求直接与人交互的 AI 系统的提供者,在设计上让人知道自己在与 AI 系统交互,除非这一点显而易见(AI 法案第 50 条)。第 113 条规定了何时适用,请核对你所在市场的日期。
也要坦诚机器人做不到什么。NN/g 研究里的用户常常事先不知道机器人能做什么;在开场白里说明它的范围,可以避免错误的期待。
怎么衡量一个功能有没有帮助?
按整周衡量改动前后的解决率,并像对待其他测试一样谨慎地读这个变化。
- 先记录 2–4 周的基线:会话数、解决率、转人工原因、由知识库回答的问题占比。
- 一次只改一件事。如果同一周既加了翻译又重写了答案,你就不知道是哪个让数字动的。
- 拿可比的对比。促销、产品故障或新增的客服时段,会改变会话的构成,要记下来。
- 看失败的构成,不只看总数。如果解决率上升了,但“客户要求”类的转人工翻了一倍,你可能让机器人变得更难用了。
- 对大幅跳变保持警惕。如果解决率一夜之间从 36% 跳到 80%,检查“已解决”是不是被闲置计时器自动设置的。
怎样设计前后对比,见 A/B 测试;客服智能体该做什么、不该做什么,见 AI 客服智能体;聊天机器人的类别见聊天机器人类型。
这些功能在 TapCub 里对应什么?
用上面的失败表,看每个功能在 TapCub 在线客服里的位置。
- 覆盖和精确匹配。在 客服 › 知识库 里,问答条目的问题等于访客的话,或访客的话包含全部关键词时,会原样发送,不消耗 AI 调用。文档会被切成约 600 字的段落,没有问答匹配时,模型根据得分最高的段落起草回答。在 草稿收件箱 里,从历史会话生成 把最近 30 天已解决的会话整理成问答草稿;批准之前不会上线。
- 转人工。在 客服 › 聊天设置 › AI 接待 里选三种模式之一:关闭、仅坐席全离线时、AI 先答。坐席接手、人工回复或访客要求人工时,AI 就停止。每个会话的最大 AI 轮数 范围是 1 到 20(默认 6),超过就转人工,没人在线时窗口变成留言表单。
- 知道为什么转。工作台会标出原因:无知识匹配、模型无法回答、访客要求、达到轮数上限,或坐席接手。把这些标签当作上面的失败表来用。
- 错误答案只改一次。在工作台里,纠错入库 把改正后的答案存成问答条目,下次同样的问题不再询问模型就直接发送。
- 翻译和背景。 问候语与翻译 让访客和坐席各看自己的语言。工作台侧栏显示访客的来源、最近 2 天的浏览轨迹和过去的对话,一键就能打开统计里的档案。
- 衡量。 客服 › 客服报表 显示会话数、解决率(已解决 ÷ 会话数)、首次响应(只算人工回复,AI 回复不算)、满意度和知识库命中率。离线留言单独计,不算已解决。见设置 AI 聊天回复。
有两条边界要说清楚。TapCub 的 AI 只会根据知识库起草回复:不会改订单、不会退款、不会发邮件,也不会调用别的系统。而且在第一次回复之前,访客会被告知他们在和 AI 对话,这条提示不能关闭。
FAQ
AI 聊天机器人应该有哪些功能?
按解决的会话数排序:知识覆盖加精确匹配的答案、看得见的联系真人的方式、只用你的资料作答、翻译,以及把背景传给坐席。装饰性选项挽救不了任何失败。
对客服来说,AI 聊天机器人最重要的功能是什么?
示例里,知识覆盖(+13.8 点)和有效的转人工(+12.0 点)合计带来约 60% 的改进。没有它们,更强的模型多半只是对错的问题给出流畅的答案。
怎么衡量聊天机器人的解决率?
周期内已解决的会话数除以全部会话数,不论是谁解决的。要连同转人工原因一起跟踪,因为解决率上升、客户却更常要求真人,可能说明机器人更难用了。
AI 聊天机器人应该转人工吗?
应该,在客户要求时,以及一定数量的无效轮次之后。CFPB 的审视把死循环和缺少出口描述为主要危害,所以转人工不仅要能用,还要自动触发。
AI 聊天机器人能执行退款之类的操作吗?
只有专门接入那些系统才行,这会增加风险和集成工作。TapCub 的 AI 不做:它根据知识库起草回复,把操作留给坐席。
资料来源
- Consumer Financial Protection Bureau(2023). Chatbots in consumer finance. 2023 年 6 月 6 日发布。
- Nielsen Norman Group. The User Experience of Chatbots. 小规模定性研究,8 名参与者。2026-11-20 查阅。
- 欧盟. Artificial Intelligence Act, Article 50: Transparency obligations. 2026-11-20 查阅。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
