业务瓶颈是流程里处理能力有限、因而决定整条流程产出的那一个环节。改进其他任何环节都不会有变化,所以要靠数字而不是意见去找它:相对上一步的转化、耗时中位数和利用率。下面是四类瓶颈、一个五步算例,以及怎样估算修好它值多少。
读完你会知道
- 只有最慢的一步决定吞吐量;把其他任何一步的能力翻倍,提升都是 0
- 瓶颈的特征:前面有队、本身接近满负荷、后面的环节闲置
- 一次只修一步,然后重新测量:修好的瓶颈会转移到下一步
什么是业务瓶颈?
瓶颈是流程里的一个环节,它有限的处理能力决定了整条流程最多能交付多少。活儿来得比这一步能往下传的快,于是这一步前面排起了队,它后面的环节就有一部分时间闲着。名字来自瓶颈本身:瓶身再宽,液体流出的速度也只由瓶颈决定。
所以瓶颈是整条流程的属性,不是某一个团队的问题。如果一个环节的能力是实际需要的两倍,再把它提速不会有任何变化。只有最慢的那一步决定吞吐量,也就是每小时或每天从流程末端出来多少订单、工单、注册或发票。
读别的文章时,还有两组区别值得先搞清:
- 短期瓶颈和长期瓶颈。 短期瓶颈是暂时的,比如只有一个人会做某件事,而他请了三天假。长期瓶颈是写在流程里的,会持续拖慢产出,比如一台总是排不过来的设备,或一条总在积压的审批规则。前者靠补位,后者要改流程。
- 约束和瓶颈。 两个词的用法略有出入。约束理论把约束定义为任何阻止系统达成目标的东西;说「瓶颈」时,通常指处理能力低于需求的那个资源。做测量时判断方法是一样的:找出限制整体产出的那一步。
本文剩下的部分讲大多数文章略过的内容:怎样用数字而不是凭感觉找到瓶颈,以及修好它大概能换来多少提升。
四类业务瓶颈
瓶颈通常落在四类里。分类有用,是因为每一类在数据里留下的痕迹不同。
| 类型 | 限制流动的是什么 | 典型例子 | 在数据里的特征 |
|---|---|---|---|
| 产能 | 一台设备、一个房间、一台服务器或固定数量的名额 | 整个仓库只有一个打包台 | 这一步接近满负荷,前面排队,后面的环节闲着 |
| 流程 | 步骤的顺序、交接或审批规则 | 每笔退款都要经理签字 | 步骤之间等待很长,期间没有人在处理这一单 |
| 人员 | 技能或时间集中在一个人或一个团队 | 所有合同只有一个人审 | 这个人休假那几天等待时间陡增;每个延误的单子上都是同一个名字 |
| 系统 | 软件、数据或集成 | 支付接口很慢,或在两个工具之间手工重复录入 | 这一步出现超时、重试和失败,而不是人们单纯离开 |
真实的瓶颈常常是两类混在一起。只有一个人能执行的审批规则(流程加人员)很常见,只修其中一半,队伍还在原地。
| 类型 | 限制流动的是什么 | 典型例子 | 在数据里的特征 |
|---|---|---|---|
| 产能 | 一台设备、一个房间、一台服务器或固定数量的名额 | 整个仓库只有一个打包台 | 接近满负荷,前面排队,后面的环节闲着 |
| 流程 | 步骤的顺序、交接或审批规则 | 每笔退款都要经理签字 | 步骤之间等待很长,期间没有人处理这一单 |
| 人员 | 技能或时间集中在一个人或一个团队 | 所有合同只有一个人审 | 这个人休假那几天等待陡增 |
| 系统 | 软件、数据或集成 | 支付接口很慢,或在两个工具之间手工重复录入 | 这一步出现超时、重试和失败 |
真实的瓶颈常常是两类混在一起,比如只有一个人能执行的审批规则。
算例:一个五步订单流程
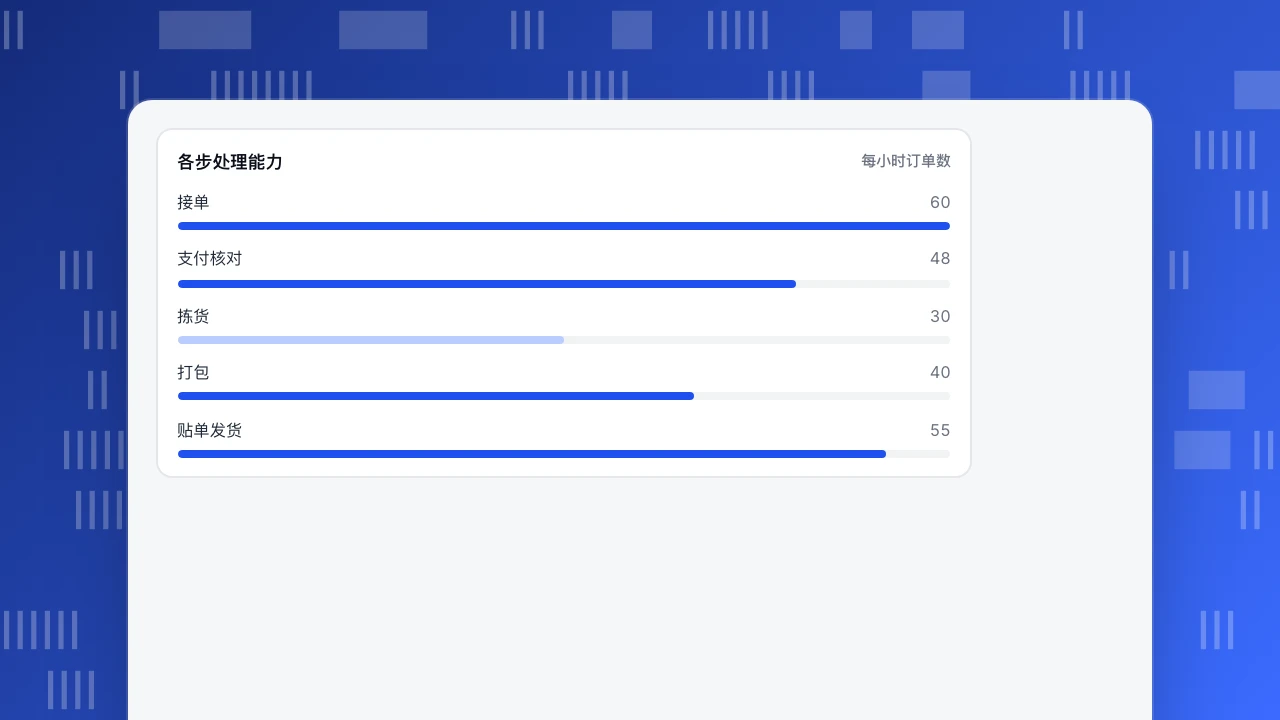
示例数据:一家网店在忙时每小时收到 45 个订单。每个订单要经过五个步骤,每一步每小时的处理能力(单位:订单)如下:
| 步骤 | 处理能力(单/小时) | 到达的订单(每小时) | 往下传的订单(每小时) | 利用率 |
|---|---|---|---|---|
| 接单 | 60 | 45 | 45 | 45 ÷ 60 = 75% |
| 支付核对 | 48 | 45 | 45 | 45 ÷ 48 = 93.8% |
| 拣货 | 30 | 45 | 30 | 30 ÷ 30 = 满负荷 |
| 打包 | 40 | 30 | 30 | 30 ÷ 40 = 75% |
| 贴单发货 | 55 | 30 | 30 | 30 ÷ 55 = 54.5% |
整条线的吞吐量 = 最小的处理能力 = 每小时 30 单,尽管来了 45 单。拣货就是瓶颈。表里有三处线索:它是仅有的满负荷的一步,它收到的比传出的多,它后面的环节利用不足(75% 和 54.5%),因为拣货让它们吃不饱。
队伍怎么长出来的。 每小时到达的比拣货处理的多 45 − 30 = 15 单。一个 8 小时班次结束时,积压是 15 × 8 = 120 单。按利特尔法则(平均等待时间 = 排队数量 ÷ 吞吐量),第 8 小时到达的订单要等 120 ÷ 30 = 4.0 小时才轮到拣货。整个班次的平均等待是 2.0 小时,因为积压是从零开始匀速增长的。
改错地方得到什么。 比较三种改动:
| 改动 | 整条线新的吞吐量 | 相对每小时 30 单的提升 |
|---|---|---|
| 打包 40 → 60(在错误的地方大幅升级) | min(60, 48, 30, 60, 55) = 30 | 0% |
| 拣货 30 → 40 | min(60, 48, 40, 40, 55) = 40 | 每小时多 10 单,+33.3% |
| 拣货 30 → 48,打包 40 → 48 | 45,因为每小时只来 45 单 | 每小时多 15 单,+50% |
把错误环节的能力翻倍,什么也没买到;而在瓶颈处提升三分之一,整条线就提升三分之一。第三行给出了停止的规则:每个环节的能力都够应付需求后,吞吐量就等于需求,再投入就是浪费。还要注意,拣货提到 40 之后,打包也正好是 40:瓶颈已经转移,下一步提升需要两个环节一起改。
各步处理能力
每小时订单数怎样在数据里找到瓶颈
凭感觉说「哪里最卡」常常不准,因为嗓门最大的环节不一定是最慢的那个。对流程的每一步测三样东西:
- 相对上一步的转化。 进入这一步的单子里,有多大比例从这一步出来。比例低,说明单子在这里流失或失败。
- 距上一步的耗时。 用中位数,不用平均数,因为少数特别久的个案会把平均数拉高。中位数长,说明单子在等。
- 利用率或队列长度。 对实物或有人值守的环节:通过这一步的流量除以它的处理能力,以及排在它前面的数量。
然后对照下表读出模式:
| 数字显示什么 | 通常意味着什么 | 下一步 |
|---|---|---|
| 转化低,等待短 | 漏水:人在这一步离开或放弃 | 按流失处理。见漏水桶和流失率 |
| 转化正常,等待长,前面有队 | 产能或流程瓶颈:单子留下了,但很慢 | 加产能、取消一道审批,或拆分这一步 |
| 转化低而且等待长 | 这一步在人们离开之前就已经在伤害他们 | 先看这里;参考用户摩擦 |
| 满负荷,后面环节闲置 | 典型瓶颈:这一步让后面所有环节吃不饱 | 只改这一步,别动其他的 |
有两点提醒。其一,瓶颈是相对需求而言的:下午 4 点满负荷的环节,上午 9 点可能只有 40%,所以要看忙时,不要看全天平均。其二,流失最多的一步不一定是瓶颈。帕累托分析按大小给原因排序,瓶颈测试是看哪一步限制了整个流量。两者配合:帕累托挑出哪些问题重要,瓶颈测试看哪一步限制了结果。
示例:在注册流程里发现瓶颈
同样的测试也适用于线上流程,只是「处理能力」变成了人的耐心,「队伍」变成了等待的时间。示例数据:某团队协作工具用漏斗测量 1,000 个新注册用户经过五个步骤的情况。
| 步骤 | 到达人数 | 相对上一步的转化 | 距上一步的耗时中位数 |
|---|---|---|---|
| 注册 | 1,000 | – | – |
| 验证邮箱 | 720 | 720 ÷ 1,000 = 72.0% | 2 分钟 |
| 创建工作区 | 650 | 650 ÷ 720 = 90.3% | 4 分钟 |
| 邀请队友 | 390 | 390 ÷ 650 = 60.0% | 30 小时 |
| 生成报表 | 312 | 312 ÷ 390 = 80.0% | 3 小时 |
只有邀请这一步既低(60.0%)又慢(30 小时)。它占各步中位数之和的 30 ÷(2 分钟 + 4 分钟 + 30 小时 + 3 小时)≈ 91%。中位数相加只是总耗时的近似,但差距大到取整不影响结论。
值多少?拿两个不同环节做同样的 10 个百分点提升来比。邀请转化从 60% 升到 70%,生成报表的人数从 312 变成 650 × 0.70 × 0.80 = 364(多 52 人,+16.7%)。如果改成邮箱验证从 72% 升到 82%,结果是 1,000 × 0.82 ×(650 ÷ 720)× 0.60 × 0.80 ≈ 355(多 43 人,+13.9%)。邀请这一步两方面都占优:在较低的基数上多提升一点,相对值更大;它的 30 小时等待也拖慢了每一个最终通过的人。只盯着流失人数最多的一步(验证流失 280 人,邀请流失 260 人),就会指错地方。
约束理论:一段话讲清
约束理论由 Eliyahu Goldratt 在 1984 年的小说《目标》(The Goal)中提出,把这个思路变成五个聚焦步骤的循环:识别约束,挖尽它(确保它不空转、不做错的事),让其他一切服从它(不要比它能处理的更快地喂给它),提升它(增加产能),然后重复,因为修好的约束会转移。放到订单例子里就是:找到拣货;让它一直处理正确的订单;让接单环节不要放出超过拣货能接的量;加一个拣货员或拆分任务;然后重新测量,因为现在打包已经到了极限。这个循环也在防止最常见的浪费,即改进了一个并不是约束的环节。
找瓶颈时的常见错误
- 改进看起来最忙的环节。 喊得最响的团队不一定是瓶颈。先看利用率,再看这一步之后的空闲时间。
- 用平均数衡量等待。 平均数会掩盖长尾。报告等待时间的中位数和第 90 百分位。
- 在清闲时段测量。 需求低的时候,没有哪一步是瓶颈。要在峰值时段测量。
- 只测一遍就停。 第一次修好之后瓶颈会转移。在动手修最先那一处之前,就先安排好第二次测量。
- 责怪个人。 队伍排在某一个人面前,说明流程只允许这个人做这件事。该修的是流程,不是这个人。
- 只数进、不数出。 一个「处理了 100 条」却输出 70 条的环节,是丢了 30 条。永远对比进入的数量和输出的数量。
在 TapCub 里找出最慢的一步
把上面的注册例子放到 TapCub 里再走一遍。TapCub 只负责衡量流程,不改变产能、不分派工作、也不做排队建模,所以订单例子里的利用率数字要来自你的运营系统。
- 把每一步变成事件或页面。 漏斗的一步是一个事件名或页面路径,共 2 到 20 步。发生在你服务器上的业务步骤,比如「已拣货」「已审批」,可以用服务端 HTTP 接口作为事件发送。见发送服务端事件。
- 在 全端分析 › 行为分析 › 行为分析 里建漏斗。 设置转化窗口(默认 7 天,最长 180 天)。每一步显示人数、相对第一步的比例、相对上一步的比例、流失,以及距上一步的耗时中位数;最大的一次流失会被标出。见搭建漏斗和读懂漏斗流失。
- 用上面的表读出模式。 点一步,列出在这里流失的人,再在同一页打开路径视图,看他们转去了哪里。见分析用户路径。
- 用同样的方法看客服队列。 在 客服 › 客服报表 里,平均首次响应是从会话开始到坐席第一次回复的时长(AI 回复不算),旁边同时显示中位数;按星期和小时统计的会话开始热力图,可以对照你的工作时间。如果首次响应只在某几个小时偏慢,瓶颈就是这些时段的人手。
- 某一步变差时收到通知。 在 全端分析 › 智能运营 › 监控 里,可以对一个保存的自定义指标按小时、天、周或月检查;试运行会告诉你过去 30 天会触发几次。监控只通知,不会替你做任何操作。
判断规则和例子里一样:找到既慢又起限制作用的那一步,估算改进它的收益,只修这一处,然后再测。
常见问题
什么是业务瓶颈?
它是流程中相对所承受需求而言处理能力最小的那一步。因为它后面的环节只能处理它传下来的东西,整个流程的产出被限制在这一步的速度上,直到它被修好或被绕开。
业务瓶颈有哪些例子?
仓库里只有一个打包台,只有一位经理能批所有退款,结账时支付服务很慢,法务审核只在周四进行,或者客服团队在多数会话开始的时段没有人值守。每一个都是拖住后面所有环节的一步。
怎样识别瓶颈?
对每一步测量相对上一步的转化、距上一步的耗时中位数,以及利用率或队列长度。瓶颈是前面队伍最长、接近满负荷运转,而它后面的环节利用不足的那一步。
瓶颈和约束有什么区别?
这两个词有重叠。在约束理论里,约束是任何阻止系统达成目标的东西;很多实用指南把处理能力低于需求的资源叫瓶颈。做分析时两者处理方法一样:找出起限制作用的那一步。
修好瓶颈,整个流程就会变快吗?
会,直到下一步成为新的限制。在示例订单流程里,把拣货从每小时 30 单提到 40 单,吞吐量提升 33.3%,然后 40 单的打包成为下一个限制。吞吐量达到需求时,就不再继续提升。
资料来源
- 维基百科,Bottleneck (production):瓶颈的定义、短期和长期瓶颈。
- 维基百科,Theory of constraints:Goldratt,The Goal(1984),五个聚焦步骤。
- 维基百科,Little's law:L = λW,用于排队等待时间的计算。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
