机器人流量是指由软件而不是真人发起的访问。本文讲三种类型、在统计里暴露它们的信号、怎么验证爬虫、为什么应该单独报告机器人而不是删掉,以及哪些措施真正能拦住有害的那部分。
读完你会知道
- 机器人流量有三类,处理方式不同:搜索引擎爬虫、AI 爬虫、恶意或采集机器人。
- 用叠加信号来发现(暴增、不执行 JavaScript、托管网络、请求速率);封禁前先用反向 DNS 验证自称的搜索引擎。
- 把机器人单独报告而不是删除;有害的用速率限制和 WAF 拦住,因为 robots.txt 只对守规矩的机器人有效。
什么是机器人流量?
机器人流量(bot traffic)是指由软件而不是真人发起的网站访问,包括搜索引擎爬虫、AI 爬虫、采集器、可用性监控和攻击脚本。有的机器人有用,有的有害,但只要不和真人访客分开识别和报告,它们都会扭曲你的统计数据。
这部分流量占比不小。Imperva 的 2026 年恶意机器人报告称,2025 年自动化活动占网络流量的 53% 以上,前一年为 51%,真人活动降到 47%。这是 Imperva 自己客户群的数据,只能当作参考信号,而不是对整个网络的普查。你的网站可能高于也可能低于这条线,所以要自己测。
机器人流量分哪三类?
有用的分法不是“好”与“坏”,而是机器人做什么、是否如实表明身份。机器人类型一文列得更全;对统计来说,三类最重要。
- 搜索引擎爬虫。Googlebot、Bingbot 等抓取页面,好让你出现在搜索结果里。你需要它们,它们也往往是许多网站里最大的一块非真人请求。网络爬虫一文讲了它们的工作方式。
- AI 爬虫。为训练模型或回答问题而读取页面的机器人,如 GPTBot、ClaudeBot、PerplexityBot。Cloudflare 2024 年 5 月到 2025 年 5 月的数据里,GPTBot 在 AI 和搜索爬虫请求中的占比从 2.2% 升到 7.7%,Googlebot 从 30% 升到 50%(Cloudflare)。它们是否带回访客是另一个问题,见 AI 爬虫账本。
- 恶意、采集和垃圾机器人。内容采集器、撞库脚本、虚假注册和垃圾评论机器人、漏洞扫描器。它们常常披着普通浏览器的 user-agent。Imperva 报告 2025 年有 27% 的机器人攻击针对 API 接口,而不是网页。
还有一类不起眼的:监控和工具类机器人(可用性检测、SEO 审计、死链检查)。把它们和首类同样对待:在预期之内,但不是真人。
怎么在统计里发现机器人流量?
没有哪一个信号能证明某次访问是机器人。检测靠的是叠加多个较弱的信号:触发多项的访问,比只触发一项的更可能是自动化的。最常用的有:
- 没有活动支撑的突然暴增。会话一夜翻倍,却没有邮件、帖子或广告能解释。
- 接近满值的跳出率和零秒访问。只看一页,不滚动,不点击。
- 异常的地区或网络。来自你不服务的国家,或来自托管和云网络(机房 IP 段)的突发访问,真人很少从那里上网。要留意:使用 VPN 和公司代理的真人也会出现在这些网络上。
- 不执行 JavaScript、没有互动。很多机器人只抓 HTML,不运行你的页面脚本。无头浏览器会运行,但常留下痕迹:webdriver 标记、过小或默认尺寸的屏幕、没有语言列表。
- user-agent 自报是机器人,或与请求头对不上。Chrome 的 user-agent 却缺少真 Chrome 会发的请求头,就可疑。
- 真人不可能达到的请求速率。同一地址一分钟几十次请求。
- 同一页面被反复请求。登录、搜索、结账或价格页被猛打,其余页面却很安静。
下表把这些信号整理成一份简短的检查清单。
| 信号 | 表现 | 怎么查 |
|---|---|---|
| 无法解释的暴增 | 没有活动,会话却骤增 | 对照邮件、广告和发帖;打开当天的机器人报告 |
| 接近 100% 的跳出率 | 只看一页、零秒、不滚动 | 按来源和国家拆分 |
| 托管网络或异常网络 | 来自机房 IP 或你不服务的国家的突发访问 | 查网络和国家;注意 VPN 和代理用户 |
| 不执行 JavaScript、没有互动 | 抓了 HTML 但页面脚本没运行,或有无头痕迹 | 看 webdriver 标记、默认屏幕尺寸、缺少语言 |
| user-agent 对不上 | Chrome 的 user-agent 却没有 Chrome 请求头,或自称机器人 | 对自称搜索引擎的用反向加正向 DNS 验证 |
| 请求速率 | 同一地址一分钟几十次请求 | 对登录、注册、搜索和结账做速率限制 |
单个信号可能有正常原因;两三个同时出现才指向自动化。
怎么确认爬虫真的是它自称的那个?
user-agent 只是一句自述,谁都可以写上“Googlebot”。Google 关于验证来自 Google 爬虫的请求的文档给了两种检查。手动方式:对 IP 做反向 DNS 查询,确认域名属于 googlebot.com、google.com 或 googleusercontent.com,再对该域名做正向查询,确认解析回原来的 IP。自动方式:把 IP 与 Google 公布的爬虫 IP 段 JSON 列表(如 common-crawlers.json)比对。
在封禁任何自称搜索引擎的流量之前先做这一步。来自无关网络的假“Googlebot”是采集器;误封了真的,会影响你被抓取。
应该过滤掉机器人流量,还是单独报告?
单独报告。把机器人从数据里删掉,得到一份干净的真人报表,但也丢掉了你需要的信息:
- 搜索引擎抓取状况。Googlebot 多久来一次、哪些页面返回 404、发版后抓取是否下降。
- AI 爬虫动向。谁在读你的内容、有没有访客回来,这是决定放行还是封禁的依据。
- 攻击模式。某个采集器打同一类网址、垃圾机器人盯着某个表单,只有还能看到机器人才看得出来。
- 复核。如果某条检测规则出错,单独的报告能让你发现被误标的真实客户;悄悄删掉,错误就看不见了。
实用规则:真人报表保持纯真人(访客、会话、跳出率、转化),机器人有自己的报告,可以按名称、用途和请求数查看。
分开机器人之后,数字会怎么变?
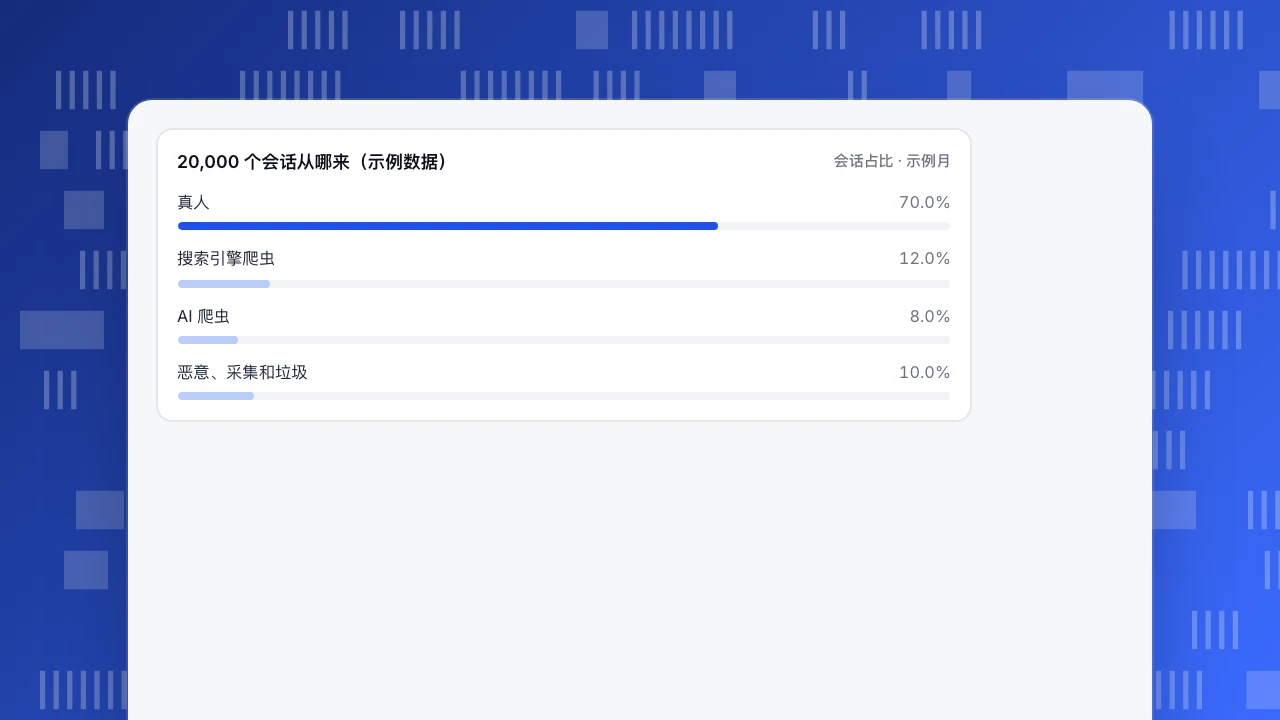
下面用示例数据(不是真实网站)算一遍。某店铺 30 天有 20,000 个会话、420 笔订单。机器人检测把会话拆成:
| 类别 | 会话 | 占比 |
|---|---|---|
| 真人 | 14,000 | 70.0% |
| 搜索引擎爬虫 | 2,400 | 12.0% |
| AI 爬虫 | 1,600 | 8.0% |
| 恶意、采集和垃圾 | 2,000 | 10.0% |
| 合计 | 20,000 | 全部 |
不过滤的转化率是 420 / 20,000 = 2.10%,只算真人是 420 / 14,000 = 3.00%。混在一起的数字比真实转化率低 (3.00 - 2.10) / 3.00 = 30%。看到 2.1% 的团队,可能为一个并不存在的问题去做结账页测试,或者误以为一次活动失败了。
同一份数据还显示了只删除不报告会错过的一点:2,400 + 1,600 = 4,000 个会话(20.0%)来自你可能想要的爬虫,2,000 个(10.0%)才是需要处理的。
20,000 个会话从哪来(示例数据)
会话占比 · 示例月怎么拦住有害的机器人流量?
检测告诉你发生了什么,拦截要在网站前面加控制措施,先要清楚 robots.txt 能做什么。
robots.txt只对守规矩的机器人有效。标准本身写明这些规则不是一种访问授权(RFC 9309,2022 年 9 月)。Cloudflare 的分析也提到遵守与否是自愿的。把它用在遵守规则的搜索引擎和 AI 爬虫上,不要指望它管住采集器。- 速率限制。对登录、注册、搜索和结账按 IP 或会话限制请求数。真人不可能产生的突发请求,是最容易拦住的坏流量。
- Web 应用防火墙(WAF)或机器人管理服务。可以按网络(托管网段)封禁、对可疑客户端发起挑战,并在请求到达应用之前执行规则。
- 保护接口,不只是页面。如果 API 调用常被盯上,要求认证并单独限速。
- 封之前先验证。用上面的方法检查自称搜索引擎的机器人,免得误封你想要的。
- 维护一份例外名单。合作方、监控和你自己的工具应该有意放行。
从代价小、最贴合证据的控制开始:突发用速率限制,某个网络用 WAF 规则,垃圾注册用表单验证。
TapCub 怎么检测并分开机器人流量?
TapCub 的机器人检测思路和上面的信号清单一致,分五层:user-agent、请求头、客户端信号、ASN / IP 网络、请求速率。内置 197 条以上规则,按名称识别已知机器人和 AI 爬虫。综合证据足够强才判定为机器人,不靠单一信号。
新项目默认是“检测并单独报告”:识别出的机器人只出现在机器人报告里,不会抬高真人访客、会话或页面浏览量。入口在 Web analytics › Bots,可以按名称、运营方、用途、请求数和页面查看搜索引擎、AI 爬虫和其他机器人,还有一份 AI 内容账本,显示哪些运营方读了你的页面、给你带回多少真人访客。抓取健康把你的 robots.txt 与实际抓取你的情况对照,作为封禁决策的依据。
两点要说明:
- 检测不是完美的。TapCub 不声称完全准确。如果真实访客被误标,可以把这次误判标记为真人。
- 页面脚本只能看到会执行 JavaScript 的机器人。不执行脚本、只抓 HTML 的爬虫,需要服务端采集或日志导入才会出现。
TapCub 负责报告机器人,不负责拦截。设置里有「识别并丢弃」选项,但它只是不保存机器人事件,机器人仍然能访问你的网站。拦截请用上面的速率限制和 WAF,并把报告当作依据。报告字段见机器人与 AI 爬虫帮助指南,产品的其余部分见网站统计概览。
FAQ
网络流量里有多少是机器人?
Imperva 的 2026 年恶意机器人报告称,2025 年自动化流量占网络流量的 53% 以上,真人为 47%。这是 Imperva 客户群的数据;下方引用的 Cloudflare 文章提到 Cloudflare Radar 的数据约为全球网络流量的 30%,口径和样本不同,你的网站也会不同。把机器人从统计里分出来,就能测出自己的数字。
怎么发现机器人流量?
找叠加的信号:无法解释的暴增、接近满值的跳出率、来自托管网络或意外国家的访问、不执行 JavaScript 也没有互动、自称机器人的 user-agent、异常快的请求速率。再用反向 DNS 或公布的 IP 段验证自称搜索引擎的机器人。内置机器人检测的统计工具会替你做这种叠加判断。
机器人流量会影响 SEO 吗?
搜索引擎爬虫是 SEO 所必需的。有害机器人不会直接影响排名,但会扭曲指标、占用服务器资源,还可能拖慢真实访客。对 SEO 的风险来自误读数据,或者误封了真正的爬虫。
要把所有机器人流量都封掉吗?
不要。封掉 Googlebot 或 Bingbot 会让你从搜索结果里消失。按类别决定:放行搜索引擎爬虫,对 AI 爬虫根据它们是否带回访客有意识地选择,对采集器和攻击机器人封禁或限速。
robots.txt 能挡住恶意机器人吗?
不能。它是守规矩的爬虫才会遵守的请求,不是访问控制。采集器和攻击脚本会无视它,对这些要用速率限制、WAF 和认证。
机器人检测会出错吗?
会。任何检测都会在两个方向上误判一些访问。所以单独报告很重要,TapCub 也允许把误判的访客标记为真人。
另见:AI 引荐流量:怎么识别和衡量;内容分析:该看哪些指标,怎样每周复盘
资料来源
- Imperva(2026)。Bad Bot Report 2026: Bots in the Agentic Age:2025 年自动化流量占网络流量 53% 以上(前一年 51%),真人 47%;27% 的机器人攻击针对 API 接口。厂商自有客户群数据。核对于 2026-11-21。
- Google。Verify requests from Google crawlers and fetchers:对 googlebot.com、google.com、googleusercontent.com 做反向加正向 DNS 检查;公布的 JSON IP 段列表。核对于 2026-11-21。
- Cloudflare(2025)。From Googlebot to GPTBot: who's crawling your site in 2025:2024 年 5 月到 2025 年 5 月,Googlebot 在 AI 和搜索爬虫流量中占比 30% 升到 50%,GPTBot 2.2% 升到 7.7%;遵守 robots.txt 是自愿的。核对于 2026-11-21。
- Koster, M. 等(2022)。RFC 9309: Robots Exclusion Protocol:“These rules are not a form of access authorization.” 核对于 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
